
第21章 深度学习与伦理
本章由 Travis LaCroix 和 Simon J.D. Prince 共同撰写。
AI 有可能向好或向坏的方向改变社会。这些技术具有巨大的社会向善潜力(Taddeo & Floridi, 2018; Tomašev et al., 2020),包括在医疗保健(Rajpurkar et al., 2022)和应对气候变化(Rolnick et al., 2023)方面发挥重要作用。然而,它们也有被误用和造成意外伤害的潜力。这催生了 AI 伦理(AI ethics)这一领域。
深度学习的现代纪元始于2012年的 AlexNet,但对 AI 伦理的持续关注并非紧随其后。事实上,2013年 NeurIPS 上一个关于机器学习公平性的研讨会因缺乏材料而被拒绝。直到2016年,AI 伦理才迎来了自己的"AlexNet时刻"——ProPublica 曝光了 COMPAS 累犯预测模型中的偏见(Angwin et al., 2016),以及 Cathy O'Neil 出版了《数学杀伤性武器》(Weapons of Math Destruction)(O'Neil, 2016)。此后,相关研究兴趣持续膨胀;自2018年创办以来的五年间,公平性、问责制与透明度会议(Conference on Fairness, Accountability, and Transparency, FAccT)的投稿量增长了近十倍。
与此同时,许多组织提出了负责任 AI 的政策建议。Jobin et al.(2019)发现了84份包含 AI 伦理原则的文件,其中88%是在2016年之后发布的。这些非立法性政策协议依赖于自愿的、非约束性的合作,其有效性受到质疑(McNamara et al., 2018; Hagendorff, 2020; LaCroix & Mohseni, 2022)。总之,AI 伦理尚处于起步阶段,伦理考量往往是被动应对而非主动预防。
本章探讨 AI 系统设计和使用中可能产生的危害,包括算法偏见、缺乏可解释性、数据隐私侵犯、军事化、欺诈和环境问题。目标不是提供如何更加道德的建议,而是表达观点并在哲学、政治科学和更广泛的社会科学中已经受到关注的关键领域开启对话。
21.1 价值对齐
在设计 AI 系统时,我们希望确保其"价值观"(目标)与人类的价值观一致。这有时被称为价值对齐问题(value alignment problem)(Russell, 2019; Christian, 2020; Gabriel, 2020)。这在三个方面具有挑战性:首先,完全且正确地定义我们的价值观是困难的;其次,将这些价值观编码为 AI 模型的目标是困难的;第三,确保模型学会执行这些目标也是困难的。
在机器学习模型中,损失函数是我们真实目标的代理(proxy),两者之间的不一致被称为外部对齐问题(outer alignment problem)(Hubinger et al., 2019)。在这种代理不够充分的情况下,系统可能会利用"漏洞"来最小化损失函数,同时未能满足预期目标。例如,考虑训练一个 RL 智能体下国际象棋。如果智能体因吃子而获得奖励,这可能导致大量和棋而非取得胜利(赢得比赛)。相反,内部对齐问题(inner alignment problem)是确保即使损失函数定义得很好,AI 系统的行为也不会偏离预期目标。如果学习算法未能找到全局最小值,或训练数据不具代表性,训练可能收敛到一个与真实目标不一致的解,从而导致不良行为(Goldberg, 1987; Mitchell et al., 1992; Lehman & Stanley, 2008)。
Gabriel(2020)将价值对齐问题分为技术层面和规范层面。技术层面关注如何将价值观编码到模型中,使其可靠地按照应有的方式行事。一些具体问题,如避免奖励黑客和安全探索,可能有纯技术性的解决方案(Amodei et al., 2016)。相反,规范层面关注的是正确的价值观首先是什么。鉴于不同文化和社会所重视的事物各不相同,这个问题可能没有唯一的答案。重要的是,编码的价值观应当代表所有人,而不仅仅是社会中占文化主导地位的群体。
另一种思考价值对齐的方式是将其视为一个结构性问题,当人类委托人(principal)将任务委托给人工代理人(agent)时就会产生(LaCroix, 2022)。这类似于经济学中的委托-代理问题(Laffont & Martimort, 2002),该问题允许在任何一方被期望代表另一方最佳利益行事的关系中存在竞争性激励。在 AI 的语境中,当以下情况发生时可能产生利益冲突:(i) 目标被错误指定,或 (ii) 委托人和代理人之间存在信息不对称(图 21.1)。
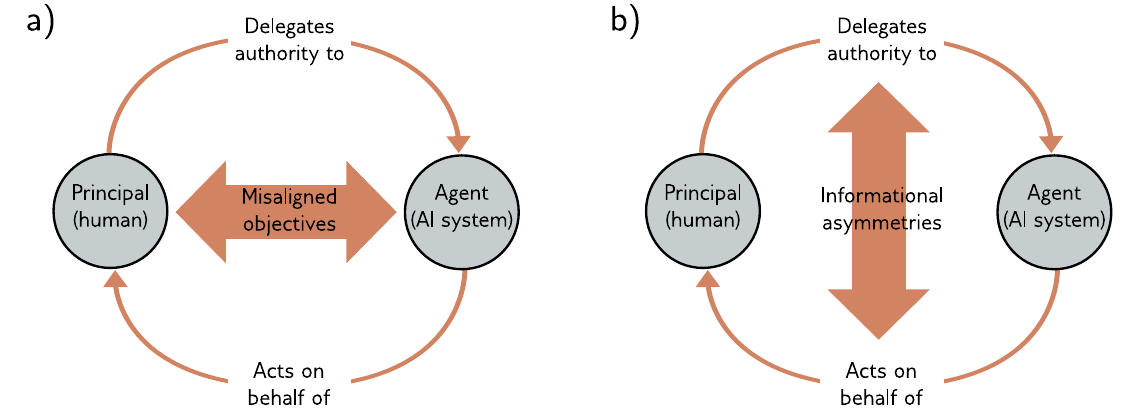
图 21.1 价值对齐的结构性描述。当人类委托人将任务委托给人工代理人时,就会出现价值对齐问题。利益冲突可能源于:(i) 目标被错误指定(外部对齐问题),或 (ii) 委托人和代理人之间存在信息不对称(内部对齐问题)。
AI 伦理中的许多话题可以通过价值对齐的结构性视角来理解。以下各节讨论偏见与公平性以及人工道德主体(均与目标指定有关)、透明度与可解释性(均与信息不对称有关)的问题。
21.1.1 偏见与公平性
从纯科学的角度来看,偏见(bias)指的是对某种规范的统计偏离。在 AI 中,当这种偏离取决于影响输出的不合理因素时,它就可能是有害的。例如,性别与工作表现无关,因此将性别作为招聘候选人的依据是不合理的。同样,种族与犯罪无关,因此将种族作为累犯预测的特征也是不合理的。
AI 模型中的偏见可以通过多种方式引入(Fazelpour & Danks, 2021):
- 问题规范:选择模型的目标需要对什么对我们重要做出价值判断,这就允许偏见的产生(Fazelpour & Danks, 2021)。如果我们未能成功地将这些选择操作化,问题规范就无法捕捉我们的预期目标,可能引入进一步的偏见(Mitchell et al., 2021)。
- 数据:当数据集不具代表性或不完整时,算法偏见就会产生(Danks & London, 2017)。例如,PULSE 人脸超分辨率算法(Menon et al., 2020)是在以白人名人照片为主的数据库上训练的。当应用于 Barack Obama 的低分辨率肖像时,它生成了一张白人男性的照片(Vincent, 2020)。如果生成训练数据的社会本身就对边缘化群体存在结构性偏见,那么即使完整且具有代表性的数据集也会引发偏见(Mayson, 2018)。例如,美国的黑人个体遭受警察盘查和监禁的频率高于白人个体。因此,用于训练累犯预测模型的历史数据已经对黑人群体存在偏见。
- 建模与验证:选择一个数学定义来衡量模型公平性需要价值判断。存在多个不同但同样直观的定义,且它们在逻辑上是不一致的(Kleinberg et al., 2017; Chouldechova, 2017; Berk et al., 2021)。这表明需要从纯数学的公平性概念化转向更实质性地评估算法在实践中是否促进了正义(Green, 2022)。
- 部署:部署的算法可能与社会中的其他算法、结构或制度相互作用,形成复杂的反馈循环,从而巩固现有偏见(O'Neil, 2016)。例如,像 GPT3 这样的大语言模型(Brown et al., 2020)是在网络数据上训练的。然而,当 GPT3 的输出被发布到网上时,未来模型的训练数据就会被污染。这可能加剧偏见并产生新的社会危害(Falbo & LaCroix, 2022)。
不公平性可能因交叉性(intersectionality)的考量而加剧;社会类别可以组合产生重叠且相互依存的压迫系统。例如,一位有色人种酷儿女性所经历的歧视,不仅仅是她作为酷儿、作为女性、或作为有色人种可能分别经历的歧视之总和(Crenshaw, 1991)。在 AI 领域,Buolamwini & Gebru(2018)表明,主要在浅肤色人脸上训练的面部分析算法在深肤色人脸上表现不佳。而且,它们在肤色和性别等特征的组合上的表现甚至比单独考虑这些特征时预期的更差。
当然,可以采取措施确保数据的多样性、代表性和完整性。但如果生成训练数据的社会本身就对边缘化群体存在结构性偏见,那么即使完全准确的数据集也会引发偏见。鉴于算法偏见的潜力以及上述训练数据集中缺乏代表性的问题,还必须考虑这些系统输出的失败率如何可能加剧对已经被边缘化群体的歧视(Buolamwini & Gebru, 2018; Raji & Buolamwini, 2019; Raji et al., 2022)。由此产生的模型可能编纂并巩固权力和压迫系统,包括资本主义和阶级主义;性别歧视、厌女症和父权制;殖民主义和帝国主义;种族主义和白人至上主义;残障歧视;以及顺性别异性恋规范。对偏见保持敏感并关注权力动态的视角,需要考虑数据中编码的历史不平等和劳动条件(Micelli et al., 2022)。
为防止这一点,我们必须积极确保算法的公平性。一种朴素的方法是通过无知实现公平(fairness through unawareness),即简单地从输入特征中移除受保护属性(protected attributes)(如种族、性别)。不幸的是,这是无效的;其余特征仍然可以携带关于受保护属性的信息。更实际的方法首先定义一个公平性的数学准则。例如,二元分类中的分离(separation)度量要求在给定真实标签
图 21.2 偏见缓解。已经提出了在训练流程各个阶段补偿偏见的方法,从数据收集到对已训练模型的后处理。参见 Barocas et al.(2023)和 Mehrabi et al.(2022)。
一个更复杂的因素是,除非我们能够确定社区成员身份,否则无法判断算法是否对某个社区不公平。大多数关于算法偏见和公平性的研究都集中在训练数据中可能存在的可直接观察的特征(如性别)上。然而,边缘化群体的特征可能是不可观察的,这使得偏见缓解更加困难。例子包括酷儿身份(Tomasev et al., 2021)、残障状况、神经类型、阶级和宗教。当可观察的特征已从训练数据中删除以防止模型利用它们时,也会出现类似问题。
21.1.2 人工道德主体
许多决策空间不包含具有道德分量的行为。例如,选择下一步国际象棋走法没有明显的道德后果。然而,在其他场景中,行为可以带有道德分量。例子包括自动驾驶车辆中的决策(Awad et al., 2018; Evans et al., 2020)、致命性自主武器系统(Arkin, 2008a,b)、以及用于儿童看护、老年护理和医疗保健的专业服务机器人(Anderson & Anderson, 2008; Sharkey & Sharkey, 2012)。随着这些系统变得更加自主,它们可能需要独立于人类输入做出道德决策。
这引出了人工道德主体(artificial moral agency)的概念。人工道德主体是能够做出道德判断的自主 AI 系统。道德主体可以按照复杂度递增进行分类(Moor, 2006):
- 伦理影响主体(Ethical impact agents)是影响情况好坏的主体,但其设计中并未考虑伦理。因此,几乎任何部署在社会中的技术都可以算作伦理影响主体。
- 隐式伦理主体(Implicit ethical agents)是包含某些内置安全特性的伦理影响主体。
- 显式伦理主体(Explicit ethical agents)能够根据上下文遵循一般性道德原则或伦理行为准则。
- 完全伦理主体(Full ethical agents)是具有信念、欲望、意图、自由意志和行动意识的主体。
机器伦理领域寻求创建人工道德主体的方法。这些方法可以分为自上而下(top-down)、自下而上(bottom-up)或混合(hybrid)(Allen et al., 2005)。自上而下(理论驱动)的方法直接实现并层级化地组织基于某种道德理论的具体规则来指导伦理行为。Asimov 的"机器人三定律"就是这种方法的一个简单例子。
在自下而上(学习驱动)的方法中,模型从数据中学习道德规律性,无需显式编程(Wallach et al., 2008)。例如,Noothigattu et al.(2018)设计了一个基于投票的伦理决策系统,该系统使用从人类在道德困境中的偏好收集的数据来学习社会偏好;然后系统汇总和聚合结果以做出"伦理"决定。混合方法结合了自上而下和自下而上的方法。
一些研究者质疑人工道德主体这一概念本身,并论证道德主体对于确保安全是不必要的(van Wynsberghe & Robbins, 2019)。参见 Cervantes et al.(2019)获取关于人工道德主体的近期综述,以及 Tolmeijer et al.(2020)获取人工道德主体技术方法的近期综述。
21.1.3 透明度与不透明性
如果一个复杂计算系统的所有运作细节都是已知的,那么它是透明的(transparent)。如果人类能够理解系统如何做出决策,那么它是可解释的(explainable)。在缺乏透明度或可解释性的情况下,用户和 AI 系统之间存在信息不对称,这使得价值对齐难以确保。
Creel(2020)在多个粒度层次上描述了透明度。功能透明度(Functional transparency)指对系统算法运作方式(即将输入映射到输出的逻辑规则)的了解。本书中描述的方法就是在这个层面。结构透明度(Structural transparency)需要知道程序如何执行算法。当高级编程语言编写的命令由机器代码执行时,这一点可能变得模糊。最后,运行透明度(run transparency)需要理解程序在特定实例中是如何执行的。对于深度网络,这包括关于硬件、输入数据、训练数据及其交互的知识。以上这些都无法通过审查代码来确定。
例如,GPT3 在功能上是透明的;其架构在 Brown et al.(2020)中有描述。然而,由于我们无法访问代码,它不具有结构透明度,并且由于我们无法访问学习到的参数、硬件或训练数据,它也不具有运行透明度。后续版本 GPT4 则完全不透明。这一商业产品的工作细节是未知的。
21.1.4 可解释性与可理解性
即使系统是透明的,这并不意味着我们能够理解决策是如何做出的,或者决策基于什么信息。深度网络可能包含数十亿参数,因此我们无法仅通过检查来理解它们的工作方式。然而,在某些司法管辖区,公众可能有权获得解释。欧盟《通用数据保护条例》第22条建议所有数据主体应有权"获得对所做决定的解释",在那些决定完全基于自动化处理的情况下。
这些困难催生了可解释 AI(explainable AI)这一子领域。一个较为成功的方向是生成局部解释。虽然我们无法解释整个系统,但有时可以描述特定输入是如何被分类的。例如,局部可解释模型无关解释(Local Interpretable Model-agnostic Explanations,LIME)(Ribeiro et al., 2016)在附近的输入处采样模型输出,并使用这些样本构建一个更简单的模型(图 21.3)。即使原始模型既不透明也不可解释,这也能提供对分类决策的洞察。
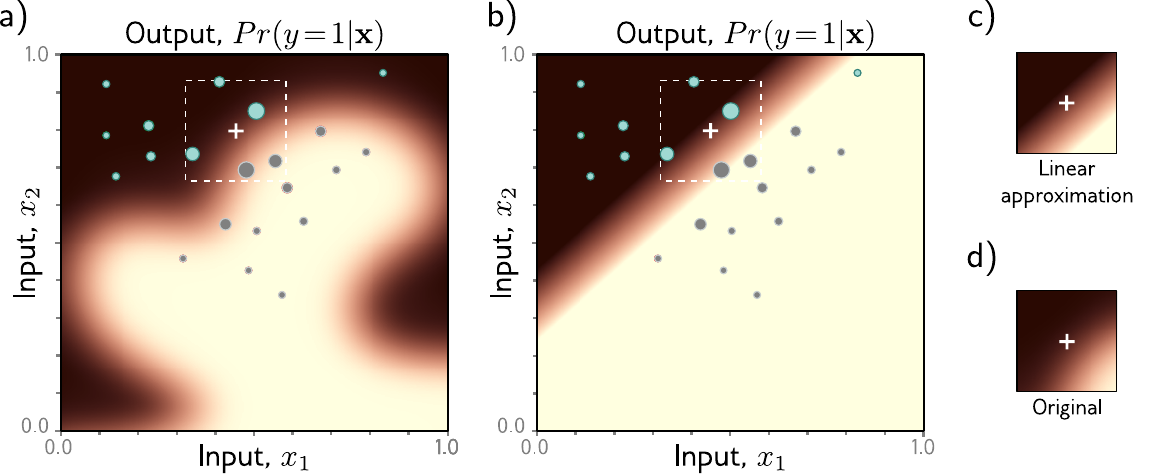
图 21.3 LIME。深度网络的输出函数是复杂的;在高维空间中,很难知道决策为何做出或如何修改输入来改变它。a) 考虑试图理解为什么白色十字处
较低。LIME 在附近的点处探测网络,看它是否将它们识别为 (青色点)或 (灰色点)。它按照与目标点的距离对这些点加权(权重由圆圈大小表示)。b) 加权点被用于训练一个更简单的模型(此处为逻辑回归——一个线性函数通过sigmoid)。c) 在白色十字附近,这个近似与 d) 原始函数很接近。尽管我们无法访问原始模型,但我们可以从这个近似模型的参数推断出,如果我们增加 或减少 , 将增加,输出类别将改变。改编自 Prince(2022)。
能否构建出对用户甚至创建者完全可理解的复杂决策系统,这仍有待观察。关于一个系统是可解释的、可理解的还是可诠释的,其含义也存在持续的争论(Erasmus et al., 2021);目前没有这些概念的具体定义。更多信息参见 Molnar(2022)。
21.2 蓄意滥用
上一节中的问题源于目标指定不当和信息不对称。然而,即使系统功能正常,它也可能导致不道德的行为或被蓄意滥用。本节重点介绍 AI 系统滥用引起的一些具体伦理问题。
21.2.1 人脸识别与分析
人脸识别技术有着特别高的被滥用风险。威权国家可以用它们来识别和压制抗议者,从而危及言论自由和抗议权等民主理想。Smith & Miller(2022)认为,自由民主的价值观(如安全、隐私、自主性和问责制)与这些技术的潜在用途(如边境安全、刑事调查和警务、国家安全以及个人数据的商业化)之间存在不匹配。因此,一些研究者、活动人士和政策制定者质疑这项技术是否应该存在(Barrett, 2020)。
此外,这些技术往往无法实现其声称的功能(Raji et al., 2022)。例如,纽约大都会运输局在一次概念验证试验报告了100%的面部识别失败率后,仍然推进并扩展了人脸识别的使用(Berger, 2019)。同样,面部分析工具经常夸大其能力(Raji & Fried, 2020),可疑地声称能够推断个人的性取向(Leuner, 2019)、情绪(Stark & Hoey, 2021)、可雇佣性(Fetscherin et al., 2020)或犯罪倾向(Wu & Zhang, 2016)。Stark & Hutson(2022)指出,计算机视觉系统使"在科学上无根据、种族主义的、已被否定的伪科学"——面相学和颅相学——有了复兴。
21.2.2 军事化与政治干预
各国政府对以国家安全和国家建设名义资助 AI 研究有着切身利益。这可能导致国家间的军备竞赛,伴随着"高投资率、缺乏透明度、相互猜疑和恐惧,以及被认为的先发制人意图"(Sisson et al., 2020)。
致命性自主武器系统因其容易想象且确实许多这样的系统正在开发中而受到广泛关注(Heikkilä, 2022)。然而,AI 也促进了网络攻击和虚假信息运动(即以欺骗为目的而分享的不准确或误导性信息)。AI 系统使得高度逼真的虚假内容的创建成为可能,并促进了信息的大规模传播,通常针对特定受众(Akers et al., 2018; Bontridder & Poullet, 2021)。
Kosinski et al.(2013)指出,敏感变量——包括性取向、民族、宗教和政治观点、人格特质、智力、幸福感、成瘾物质使用、父母分离、年龄和性别——可以仅从社交媒体上的"点赞"来预测。基于这些信息,像"开放性"这样的人格特质可以被用于操纵目的(例如改变投票行为)。
21.2.3 欺诈
不幸的是,AI 是自动化欺诈活动的有用工具(例如发送大量邮件或短信来诱骗人们泄露敏感信息或汇款)。生成式 AI 可以用来欺骗人们,使其误以为自己在与合法实体互动,或者生成误导或欺骗性的虚假文档。此外,AI 可能增加网络攻击的复杂程度,例如生成更具说服力的钓鱼邮件或适应目标组织的防御系统。
这凸显了呼吁机器学习系统透明度的负面效应:系统越公开透明,它们就越容易受到安全风险或被恶意行为者利用。例如,生成式语言模型(如 ChatGPT)已被用来编写可用于间谍活动、勒索软件和其他恶意软件的软件(Goodin, 2023)。
将计算机行为拟人化的倾向,特别是将意义投射到符号串上的行为,被称为 ELIZA 效应(Hofstadter, 1995)。这导致在与复杂聊天机器人互动时产生虚假的安全感,使人们更容易受到基于文本的欺诈(如恋爱诈骗或商业电子邮件诈骗)(Abrahams, 2023)。Véliz(2023)强调了某些聊天机器人中使用表情符号本质上具有操纵性,利用了人们对表情图像的本能反应。
21.2.4 数据隐私
现代深度学习方法依赖于大规模众包数据集,这些数据集可能包含敏感或私人信息。即使敏感信息被移除,辅助知识和冗余编码也可以用来对数据集进行去匿名化(Narayanan & Shmatikov, 2008)。1997年就发生了一个著名的案例:马萨诸塞州州长 William Weld。在一家保险集团发布了去除明显个人信息(如患者姓名和地址)的健康记录后,一位有志于此的研究生通过交叉引用公共选民名册成功地进行了"去匿名化",确定了哪些记录属于 Weld 州长。
因此,隐私优先的设计对于确保个人信息安全非常重要,特别是在将深度学习技术应用于医疗保健和金融等高风险领域时。差分隐私和语义安全(同态加密或安全多方计算)方法可以用于在模型训练过程中确保数据安全(参见 Mireshghallah et al., 2020; Boulemtafes et al., 2020)。
21.3 其他社会、伦理和职业问题
上一节确定了 AI 可能被蓄意滥用的领域。本节描述 AI 广泛应用可能产生的其他潜在副作用。
21.3.1 知识产权
知识产权(IP)可以被定义为原创思想产物的非物质财产(Moore & Himma, 2022)。在实践中,许多 AI 模型是在受版权保护的材料上训练的。因此,这些模型的部署可能带来法律和伦理风险,并侵犯知识产权(Henderson et al., 2023)。
有时,这些问题是明确的。当语言模型被提示输入受版权保护的材料摘录时,其输出可能逐字包含受版权保护的文本,类似的问题也适用于扩散模型中图像生成的上下文(Henderson et al., 2023; Carlini et al., 2022, 2023)。即使训练属于"合理使用",在某些情况下这也可能侵犯内容创作者的精神权利(Weidinger et al., 2022)。
更微妙的是,生成模型(第12、14-18章)引发了关于 AI 和知识产权的新问题。机器学习模型的输出(如艺术、音乐、代码、文本)能否被版权保护或获得专利?在特定艺术家的作品上微调模型以复制该艺术家的风格,这在道德或法律上是否可以接受?知识产权法是一个凸显现有立法未将机器学习模型纳入考虑的领域。虽然政府和法院可能在不久的将来确立先例,但在撰写本书时这些问题仍然悬而未决。
21.3.2 自动化偏见与道德技能退化
随着社会越来越依赖 AI 系统,人们越来越倾向于产生自动化偏见(automation bias),即期望模型输出是正确的(因为它们是"客观的")。这导致了量化方法优于定性方法的观点。然而,正如我们将在21.5节看到的,号称客观的事业很少是真正价值无涉的。
社会学概念去技能化(deskilling)指的是技能在自动化背景下的冗余和贬值(Braverman, 1974)。例如,将记忆等认知技能外包给技术可能导致我们记忆能力的下降。类似地,在道德负荷决策中使用 AI 自动化可能导致我们道德能力的下降(Vallor, 2015)。例如,在战争背景下,武器系统的自动化可能导致对战争受害者的非人化(Asaro, 2012; Heyns, 2017)。同样,老年护理、儿童看护或医疗保健场景中的服务机器人可能削弱我们关爱彼此的能力(Vallor, 2011)。
21.3.3 环境影响
训练深度网络需要大量的计算能力,因而消耗大量能源。Strubell et al.(2019, 2020)估计,训练一个拥有2.13亿参数的 Transformer 模型排放了约284吨
21.3.4 就业与社会
技术创新的历史就是就业替代的历史。2018年,麦肯锡全球研究院估计,到2030年 AI 可能使经济产出增加约13万亿美元,主要通过自动化替代劳动力来实现(Bughin et al., 2018)。麦肯锡全球研究院的另一项研究表明,2016至2030年间,全球劳动力中高达30%(1亿至8亿人)可能因 AI 而失业(Manyika et al., 2017; Manyika & Sneader, 2018)。
然而,预测本质上是困难的,虽然 AI 导致的自动化可能导致短期失业,但技术性失业的概念被描述为"暂时的适应不良阶段"(Keynes, 1931)。这是因为财富增长可以通过对产品和服务的需求增加来抵消生产力提升。此外,新技术可以创造新类型的工作。
即使自动化从长远来看不会导致总体就业的净损失,短期内也可能需要新的社会项目。因此,无论是乐观(Brynjolfsson & McAfee, 2016; Danaher, 2019)、中立(Metcalf et al., 2016; Calo, 2018; Frey, 2019)还是悲观(Frey & Osborne, 2017)地看待 AI 背景下的失业可能性,可以确定的是社会将发生重大变化。
21.3.5 权力集中
随着深度网络规模的增大,训练这些模型所需的数据量和计算能力也相应增加。在这方面,小公司和初创企业可能无法与大型成熟科技公司竞争。这可能产生反馈循环,使得权力和财富日益集中在少数企业手中。一项近期研究发现,大型科技公司和"精英"大学与中低层大学之间在主要 AI 会议上的论文发表数量差距越来越大(Ahmed & Wahed, 2016)。在许多观点看来,这种财富和权力的集中与社会中的公正分配是不相容的(Rawls, 1971)。
这催生了通过使每个人都能创建此类系统来民主化 AI 的呼声(Li, 2018; Knight, 2018; Kratsios, 2019; Riedl, 2020)。这一过程需要通过开源和开放科学使深度学习技术更加广泛可用且更易于使用,使更多人能从中受益。这降低了准入门槛并增加了 AI 的可及性,同时降低成本、确保模型准确性、增加参与度和包容性(Ahmed et al., 2020)。
21.4 案例研究
我们现在描述一个涉及本章讨论的许多问题的案例研究。2018年,大众媒体报道了一个有争议的面部分析模型——被称为"同性恋检测 AI"(Wang & Kosinski, 2018)——伴随着诸如AI能从一张照片判断你是否是同性恋:人工智能以惊人准确度预测性取向(Ahmed, 2017);一个令人恐惧的AI能判断一个人是否是同性恋,准确率91%(Matsakis, 2017);以及人工智能系统能判断你是否是同性恋(Fernandez, 2017)等耸人听闻的标题。
这项工作存在多方面问题。首先,训练数据集高度偏向且不具代表性,主要由高加索人图像组成。其次,鉴于性别和性取向的流动性,建模和验证也存在问题。第三,这种模型最明显的用途是在将同性恋定为犯罪的国家中对 LGBTQ+ 群体进行针对性歧视和迫害。第四,在透明度、可解释性和价值对齐方面,这个"同性恋检测"模型似乎是基于打扮、着装和生活方式的虚假相关性,而非作者所声称的面部结构(Agüera y Arcas et al., 2018)。第五,在数据隐私方面,从约会网站抓取"公开"照片和性取向标签的伦理性令人质疑。最后,在科学传播方面,研究者以一种必然会引发轰动标题的方式传达了他们的结果:甚至论文标题本身就是对模型能力的夸大其词:深度神经网络能够从面部检测性取向。(它们不能。)
同样显而易见的是,一个确定性取向的面部分析模型对 LGBTQ+ 群体毫无益处。如果要造福社会,最重要的问题是某项特定研究、实验、模型、应用或技术是否服务于其所涉及社区的利益。
21.5 科学的价值无涉理想
本章列举了 AI 系统的目标可能在无意中或通过滥用偏离人类价值观的多种方式。现在我们论证科学家不是中立的行为者;他们的价值观不可避免地影响着他们的工作。
也许这令人惊讶。有一种广泛的信念认为科学是——或者应该是——客观的。这被科学的价值无涉理想(value-free ideal of science)所体现。许多人会认为机器学习是客观的,因为算法本质上是数学。然而,类似于算法偏见(第21.1.1节),AI 从业者的价值观可以在四个阶段影响他们的工作(Reiss & Sprenger, 2017):
- 选择研究问题。
- 收集与研究问题相关的证据。
- 接受科学假设作为问题的答案。
- 应用科学研究的结果。
可以说,在第一和最后一个阶段,价值观发挥着重要作用是没有争议的。最初的研究问题选择和后续应用的选择受到科学家、机构和资助机构利益的影响。然而,科学的价值无涉理想规定在中间的科学过程中应尽量减少道德、个人、社会、政治和文化价值观的影响。这一理念预设了价值中立论题(value-neutrality thesis),即科学家(至少在原则上)可以在阶段(2)和(3)中不做这些价值判断。
然而,无论是否有意,价值观都嵌入在机器学习研究中。这些价值观大多可归类为认识性(epistemic)价值(如性能、泛化能力、基于先前工作的积累、效率、新颖性)。但决定这组价值本身就是一个价值判断;很少有论文明确讨论社会需求,更少有论文讨论潜在的负面影响(Birhane et al., 2022b)。科学哲学家们质疑科学的价值无涉理想是否可以实现或值得追求。例如,Longino(1990, 1996)认为这些认识性价值不是纯粹认识性的。Kitcher(2011a,b)认为科学家通常并不真正关心真理本身;相反,他们追求与自己目标和利益相关的真理。
机器学习依赖于归纳推理,因此本质上容易受到归纳风险的影响。模型仅在训练数据点处受约束,而维度诅咒意味着这只是输入空间的极小比例;无论我们使用多少数据来训练模型,输出总是可能出错的。因此,选择接受还是拒绝一个模型预测需要一个价值判断:在接受时犯错的风险是否低于在拒绝时犯错的风险。
因此,使用归纳推理意味着机器学习模型本质上是价值负载的(Johnson, 2022)。事实上,如果它们不是价值负载的,它们将毫无用处:正是因为它们是价值负载的,它们才有用。因此,接受算法被用于排序、分类、过滤、推荐、分类、标注、预测等,就意味着这些过程将产生现实世界的影响。随着机器学习系统日益商业化和广泛应用,它们在我们关心的事物中变得越来越根深蒂固。
这些洞察对那些认为算法在某种程度上比人类决策者更加客观(因此应当取代人类决策者,特别是在我们认为客观性很重要的领域)的研究者具有启示意义。
21.6 负责任的AI研究作为集体行动问题
推卸责任是容易的。阅读本章的学生和专业人士可能认为他们的工作与现实世界相距甚远,或者他们只是更大机器中的一个小部分,他们的行为不可能产生影响。然而,这是一个错误。研究者通常可以选择他们投入时间的项目、他们工作的公司或机构、他们寻求的知识、他们互动的社交和学术圈子,以及他们的沟通方式。
做正确的事,无论这意味着什么,往往呈现为社会困境的形式;最佳结果依赖于合作,尽管合作未必符合任何个人的利益:负责任的 AI 研究是一个集体行动问题。
21.6.1 科学传播
一个积极的步骤是负责任地进行传播。错误信息在许多类型的社交网络中传播得比真相更快、更持久(LaCroix et al., 2021; Ceylan et al., 2023)。因此,重要的是不夸大机器学习系统的能力(参见上述案例研究),并避免误导性的拟人化。同样重要的是意识到机器学习技术被误用的可能性。例如,面相学和颅相学等伪科学实践在 AI 中出人意料地找到了复兴(Stark & Hutson, 2022)。
21.6.2 多样性与异质性
第二个积极的步骤是鼓励多样性。当社会群体是同质的(由相似成员组成)或同质亲和的(由倾向于与相似他人交往的成员组成)时,主导群体往往会使其惯例被重复和巩固(O'Connor & Bruner, 2019)。缓解压迫系统的一种方式是确保多元观点得到考虑。这可以通过公平、多样性、包容性和无障碍倡议(在机构层面)、参与式和社区导向的研究方法(在研究层面),以及对社会、政治和道德问题的更多意识(在个人层面)来实现。
立场认识论(standpoint epistemology)(Harding, 1986)的理论认为,知识是社会定位的(即取决于一个人在社会中的位置)。科技圈的同质性可能导致有偏见的技术(Noble, 2018; Eubanks, 2018; Benjamin, 2019; Broussard, 2023)。缺乏多样性意味着创造这些技术的个人的视角将渗入数据集、算法和代码中,成为默认视角。Broussard(2023)认为,因为大部分技术是由健全的、白人的、顺性别的美国男性开发的,技术是为健全的、白人的、顺性别的美国男性优化的,他们的视角被视为现状。确保技术惠及历史上被边缘化的群体,需要研究者理解这些群体的需求、愿望和视角(Birhane et al., 2022a)。设计正义(Design justice)以及参与式和社区导向的 AI 研究方法认为,受技术影响的社区应当积极参与技术的设计(Constanza-Chock, 2020)。
21.7 前进之路
不可否认的是,AI 将从根本上改变社会。然而,由 AI 驱动的未来乌托邦式的乐观愿景应当以谨慎和健康的批判性反思来对待。许多被吹捧的 AI 好处仅在特定情境和特定群体中是有益的。例如,Green(2019)指出,一个利用 AI 加强警察问责和替代监禁的项目,与另一个为增加安全而通过预测性警务开发的项目,都被标榜为"AI 造福社会"。赋予这一标签缺乏任何基本原则;一个社区的善可能是另一个社区的害。
在考虑新兴技术惠及社会的潜力时,有必要反思这些好处是否会平等或公平地分配。人们常常假设技术上最先进的解决方案就是最好的——即所谓的技术沙文主义(technochauvinism)(Broussard, 2018)。然而,许多社会问题源于深层的社会结构问题,并不需要技术解决方案。
本章贯穿了一些共同主题,我们希望向读者强调四个关键观点:
- 机器学习研究无法回避伦理。 历史上,研究者可以在受控的实验室环境中专注于工作的基础方面。然而,由于商业化 AI 的巨大经济激励以及学术工作受到产业资助的程度(参见 Abdalla & Abdalla, 2021),这种奢侈正在消失;即使是理论研究也可能产生社会影响,因此研究者必须与其工作的社会和伦理层面互动。
- 即使是纯技术决策也可能是价值负载的。 认为 AI 本质上只是数学因而是"客观的"、与伦理无关的观点仍然很普遍。当我们考虑 AI 系统的创建或部署时,这一假设并不成立。
- 我们应该质疑 AI 工作所处的结构。 大多数 AI 伦理研究关注的是具体情境,而非质疑 AI 将被部署到的更大社会结构。例如,确保算法公平性固然有很大的兴趣,但在现有的社会和政治结构中,实现公平、正义或公正的概念并非总是可能的。因此,技术本质上是政治性的。
- 社会和伦理问题不一定需要技术解决方案。 围绕 AI 技术的许多潜在伦理问题本质上是社会性和结构性的,因此仅靠技术创新不能解决这些问题;如果科学家要通过新技术促成积极变化,他们必须采取政治和道德立场。
这些将普通科学家置于何处?也许以下命令是必要的:反思自己工作的道德和社会维度。这可能需要积极与那些最可能受到新技术影响的社区互动,从而培养研究者和社区之间的关系并赋予这些社区权力。同样,这可能需要跨越自身学科界限与文献互动。对于哲学问题,斯坦福哲学百科全书(Stanford Encyclopedia of Philosophy)是宝贵的资源。跨学科会议在这方面也很有用。领先的工作在公平性、问责制与透明度会议(FAccT)和 AI、伦理与社会会议(AIES)上发表。
21.8 总结
本章探讨了深度学习和 AI 的伦理影响。价值对齐问题是确保 AI 系统的目标与人类目标一致的任务。偏见、可解释性、人工道德主体以及其他话题都可以通过这一视角来审视。AI 可以被蓄意滥用,本章详述了其中一些方式。AI 的进步在知识产权法和气候变化等多样化领域还有更深远的影响。
伦理 AI 是一个集体行动问题,本章最后呼吁科学家思考其工作的道德和伦理影响。每一个伦理问题都不在任何单个计算机科学家的控制范围内。然而,这并不意味着研究者完全没有责任去思考——并在力所能及之处缓解——他们所创建系统被误用的可能性。