
第1章 引言
人工智能(Artificial Intelligence,简称 AI)致力于构建能够模拟智能行为的系统。它涵盖了广泛的方法,包括基于逻辑、搜索和概率推理的技术。机器学习(Machine Learning)是人工智能的一个子领域,通过将数学模型拟合到观测数据上来学习做出决策。这一领域经历了爆发式增长,如今已(尽管并不准确地)几乎与"人工智能"一词同义。
深度神经网络(deep neural network,或简称深度网络)是一类机器学习模型,将此类模型拟合到数据的过程称为深度学习(deep learning)。在本书撰写之时,深度网络是最强大且最实用的机器学习模型,并频繁出现在日常生活中。使用自然语言处理算法翻译文本、通过计算机视觉系统搜索特定物体的图像、或借助语音识别接口与数字助理对话——所有这些应用均由深度学习驱动。
顾名思义,本书旨在帮助初涉该领域的读者理解深度学习背后的基本原理。本书既非高度理论化(不包含任何数学证明),亦非极度面向实践(几乎不提供代码)。其核心目标在于阐释深层思想;通读本书后,读者将有能力将深度学习应用于全新场景——即便该场景尚无现成的成功范式可循。
机器学习方法大致可分为三大类:监督学习、无监督学习和强化学习。在本书撰写之际,这三个领域的前沿技术均依赖深度学习(图 1.1)。本章作为导论,将从宏观层面介绍这三类方法,这一分类也大致体现在本书的整体结构中。无论我们是否愿意,深度学习正蓄势改变我们的世界,而这一变革并非全然积极。因此,本章还包含人工智能伦理的简要入门,并以如何高效使用本书的建议作结。
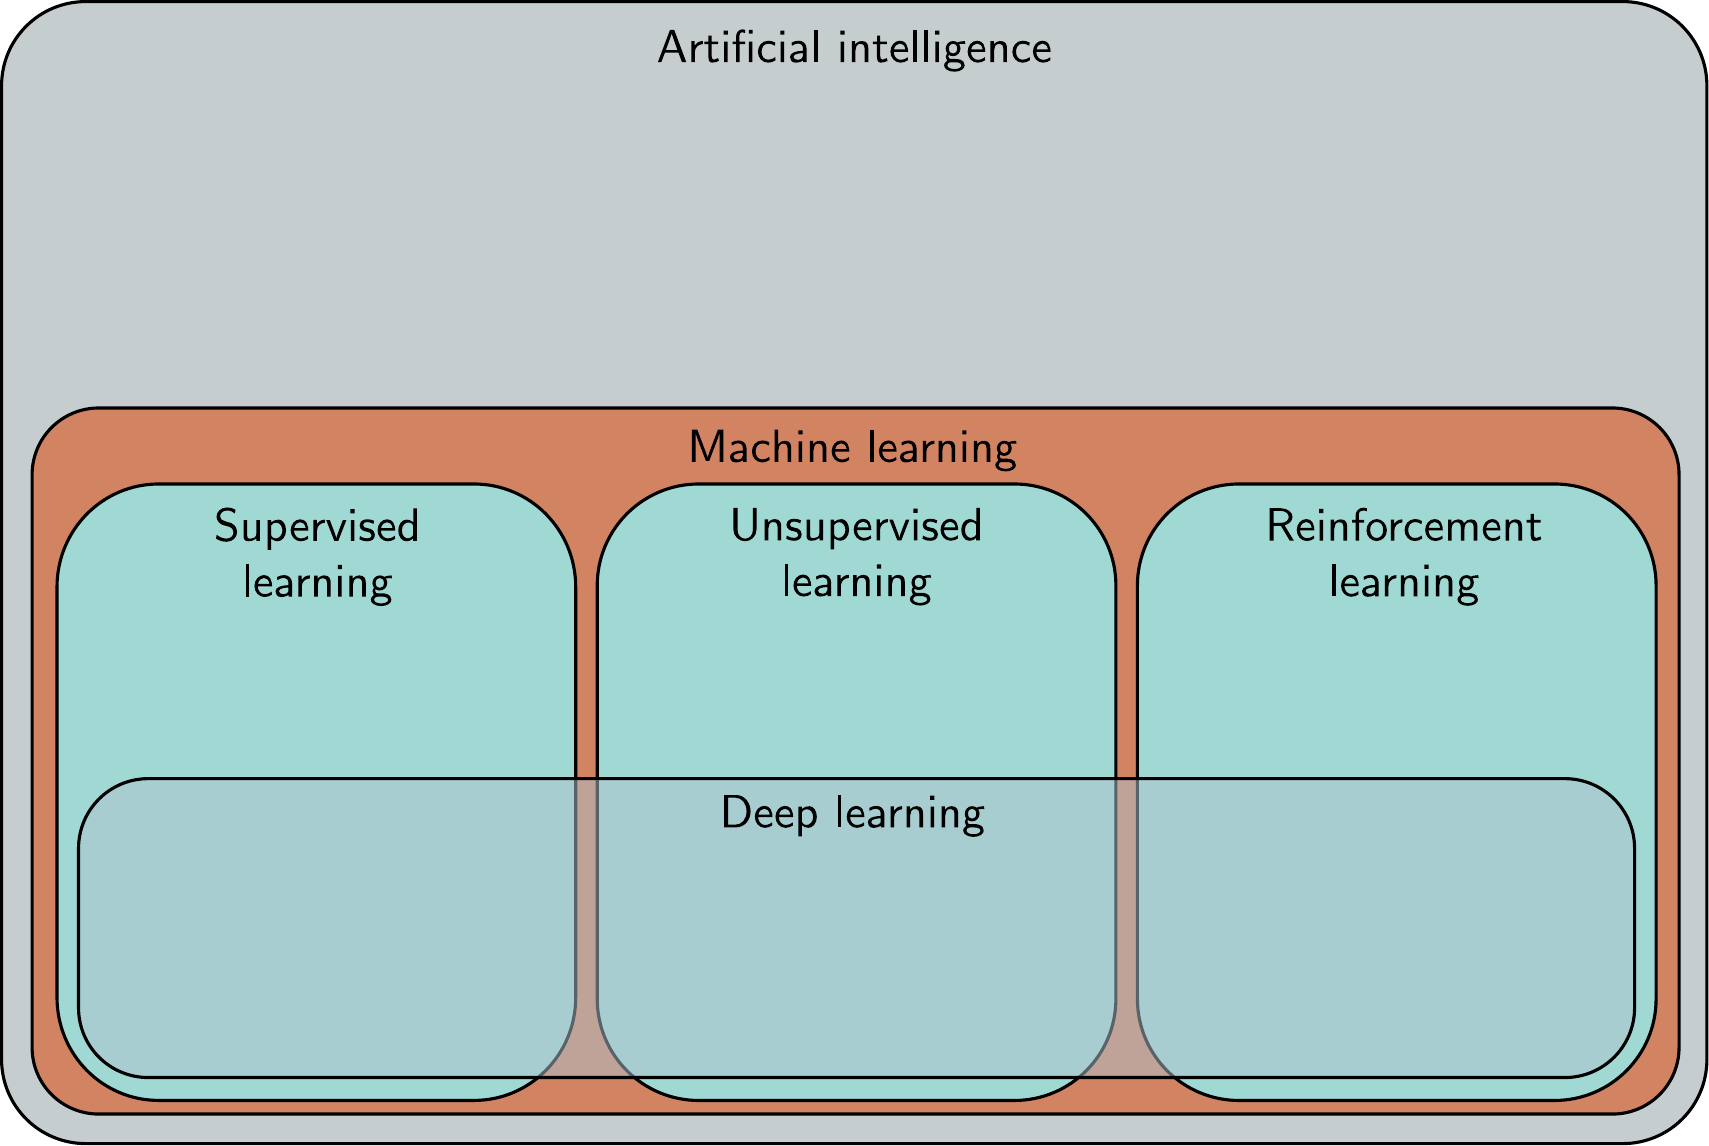
图 1.1 机器学习是人工智能的一个分支,通过将数学模型拟合到观测数据来做出决策。它大致可分为监督学习、无监督学习和强化学习三类。深度神经网络在这三个领域中均发挥着重要作用。
1.1 监督学习
监督学习模型定义了一种从输入数据到输出预测的映射关系。在接下来的小节中,我们将分别讨论输入、输出、模型本身,以及所谓"训练"模型的具体含义。
1.1.1 回归与分类问题
图 1.2 展示了若干回归与分类问题。在每种情况下,输入均为具有实际意义的现实世界数据(如一句话、一段音频、一幅图像等),并被编码为一个数值向量,构成模型的输入。模型将输入映射为一个输出向量,随后该输出向量被"翻译"回具有现实意义的预测结果。目前,我们暂且聚焦于输入与输出本身,将模型视为一个黑箱:它接收一个数值向量作为输入,并返回另一个数值向量作为输出。
图 1.2a 中的模型根据房屋特征(如面积、卧室数量等)预测其售价。这是一个回归(regression)问题,因为模型输出的是一个连续数值(而非类别标签)。相比之下,图 1.2b 中的模型以分子的化学结构为输入,预测其凝固点与沸点。由于需同时预测多个数值,这属于多元回归(multivariate regression)问题。
图 1.2c 中的模型以一段餐厅评论文本为输入,预测该评论的情感倾向为正面或负面。这是一个二分类(binary classification)问题,因为模型需将输入划分至两个互斥类别之一。输出向量包含输入属于各类别的概率。图 1.2d 和 1.2e 则展示了多分类(multiclass classification)问题,模型需将输入划分至
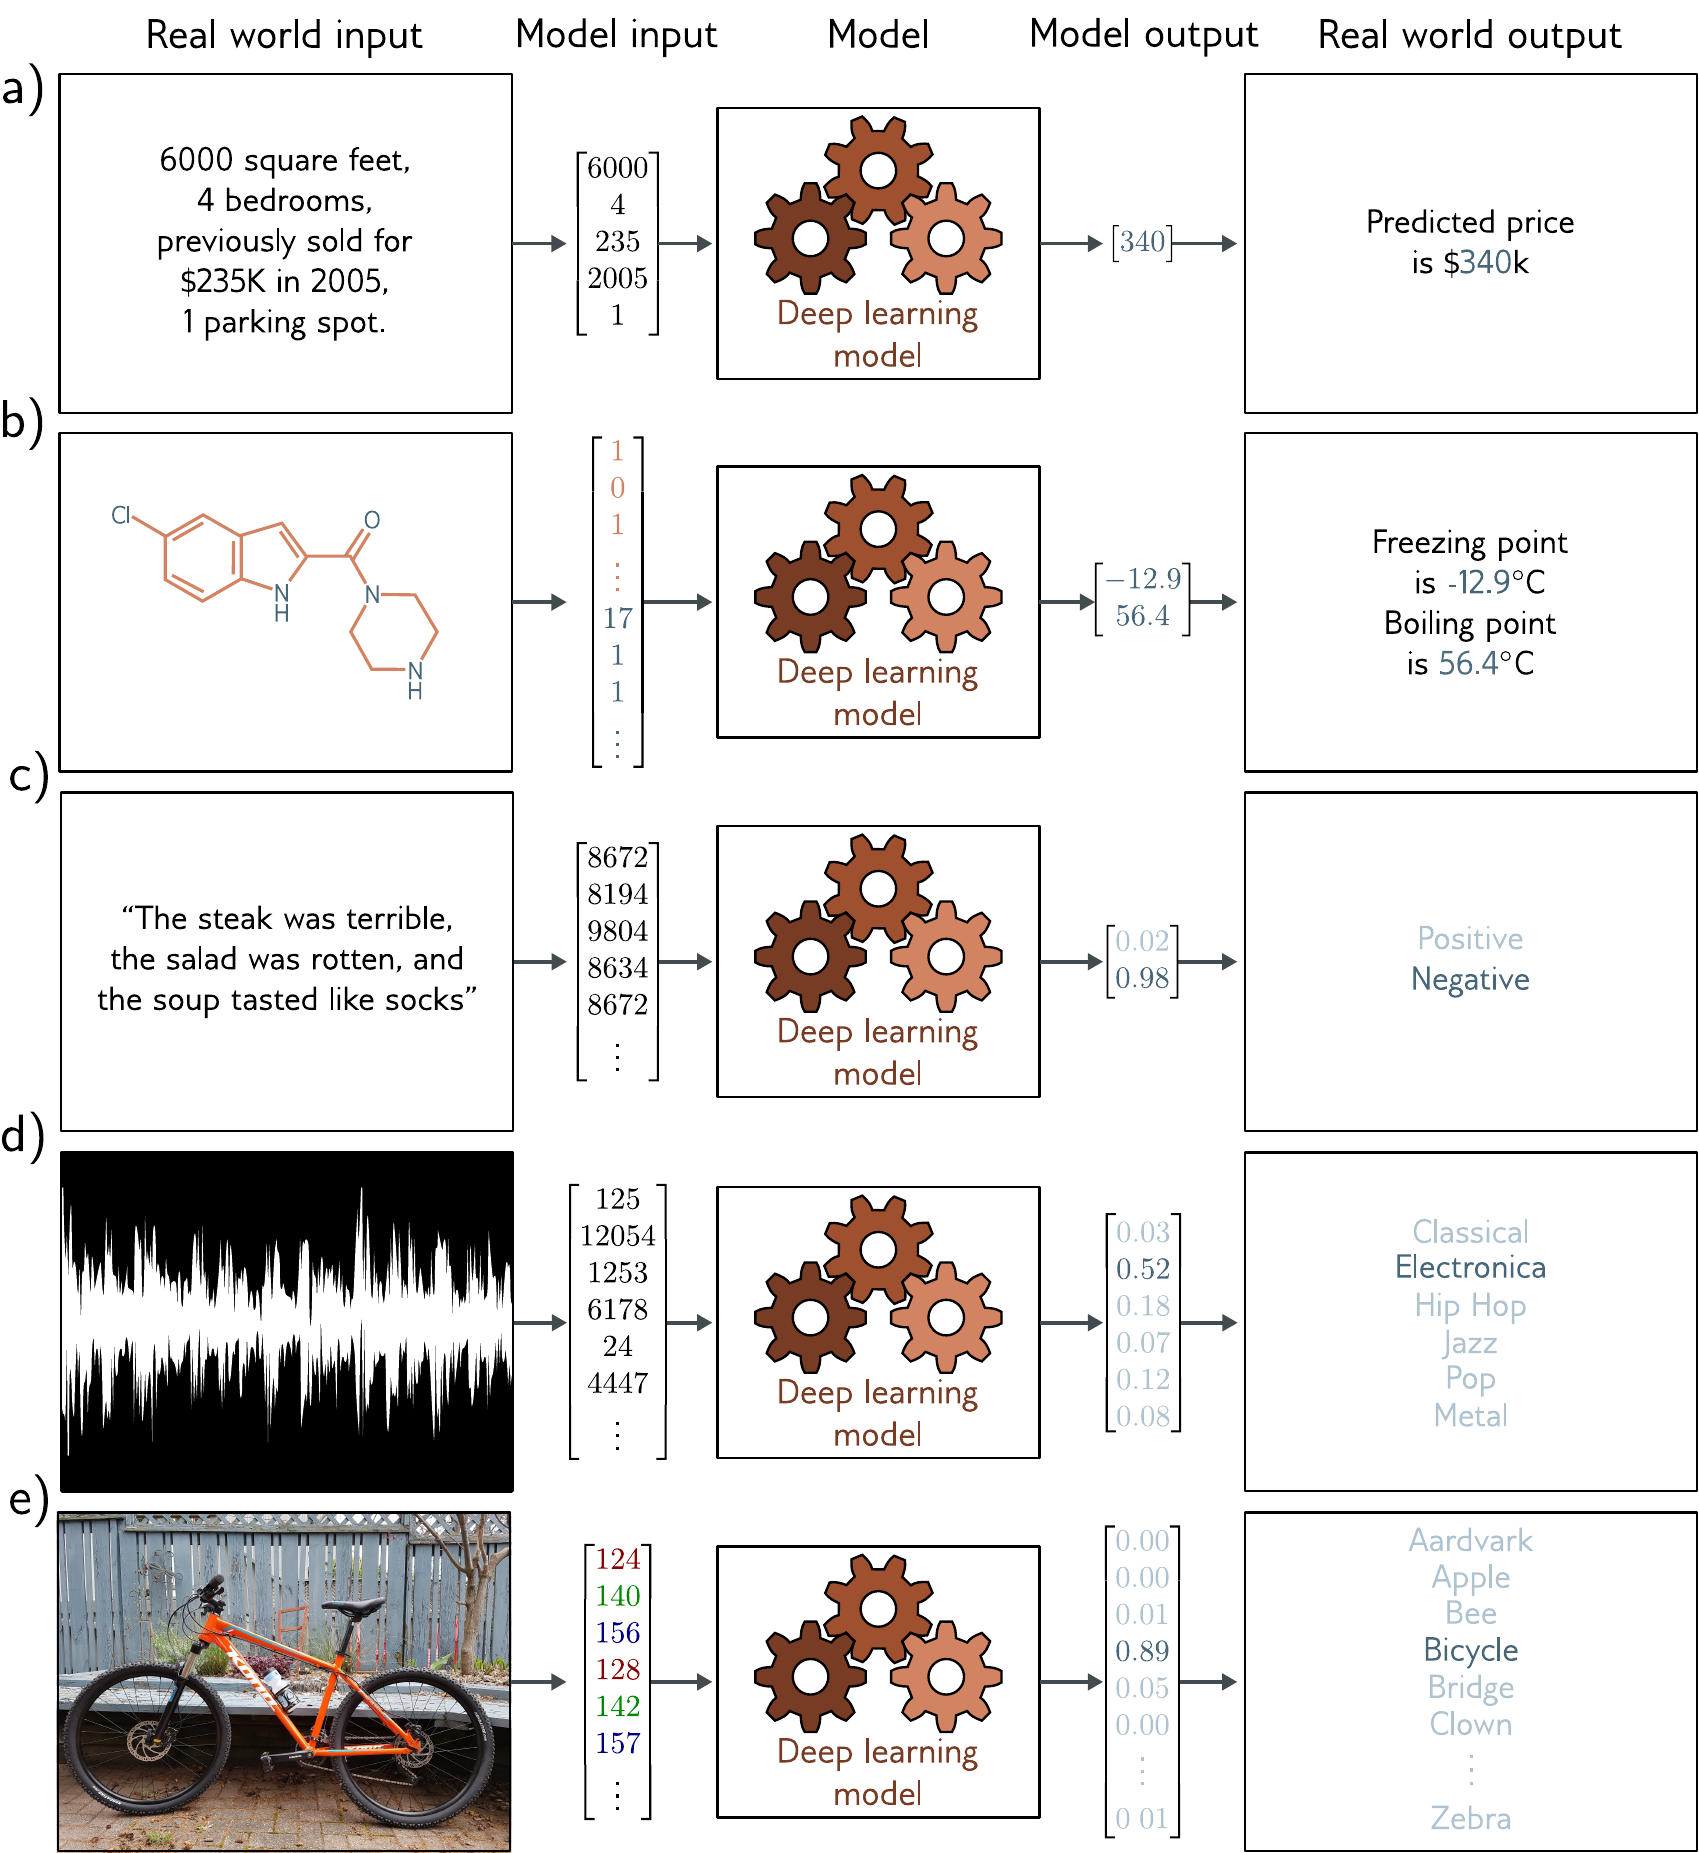
图 1.2 回归与分类问题。a) 该回归模型接收表征房屋属性的数值向量,预测其价格。b) 该多元回归模型接收化学分子结构,预测其凝固点与沸点。c) 该二分类模型接收一条餐厅评论,将其分类为正面或负面。d) 该多分类问题将一段音频片段划分至
个可能的音乐流派之一。e) 另一个多分类问题中,模型根据图像中可能包含的 种物体之一对其进行分类。
1.1.2 输入
图 1.2 中的输入数据形式差异显著。在房价预测示例中,输入是一个固定长度的向量,其中各元素表征房屋的各类属性。此类数据称为表格型数据(tabular data),因其内部不具结构性:若打乱输入向量中各元素的顺序并重新训练模型,预测结果预期保持不变。
相反,餐厅评论示例中的输入是一段文本,长度随评论词数变化,属于可变长输入。此外,语序至关重要:"我妻子吃了鸡肉"与"鸡肉吃了我妻子"含义截然不同。文本需先编码为数值形式才能输入模型。此处采用一个固定大小为 10,000 的词汇表,简单地将各单词对应的索引拼接成向量。
在音乐分类示例中,输入向量可能是固定大小的(比如10秒的片段),但维度极高(即包含大量元素)。数字音频通常以 44.1 kHz 采样并用 16 位整数表示,因此一个10秒的片段由 441,000 个整数组成。显然,监督学习模型必须能够处理如此大规模的输入。图像分类示例中的输入(由每个像素的 RGB 值拼接而成)同样维度巨大。此外,图像具有空间结构:即使在输入向量中不相邻,上下相邻的两个像素也是密切相关的。
最后,考虑预测分子凝固点和沸点的模型输入。分子可能包含不同数量的原子,且原子之间的连接方式各异。在这种情况下,模型必须同时接收分子的几何结构和各组成原子的信息。
1.1.3 机器学习模型
到目前为止,我们一直将机器学习模型视为一个接收输入向量并返回输出向量的黑箱。那么这个黑箱里面究竟是什么?考虑一个根据儿童年龄预测身高的模型(图 1.3)。机器学习模型是一个数学方程,描述了平均身高如何随年龄变化(图 1.3 中的青色曲线)。当我们将年龄输入该方程,它便返回对应的身高。例如,如果年龄为10岁,则预测身高为 139 厘米。
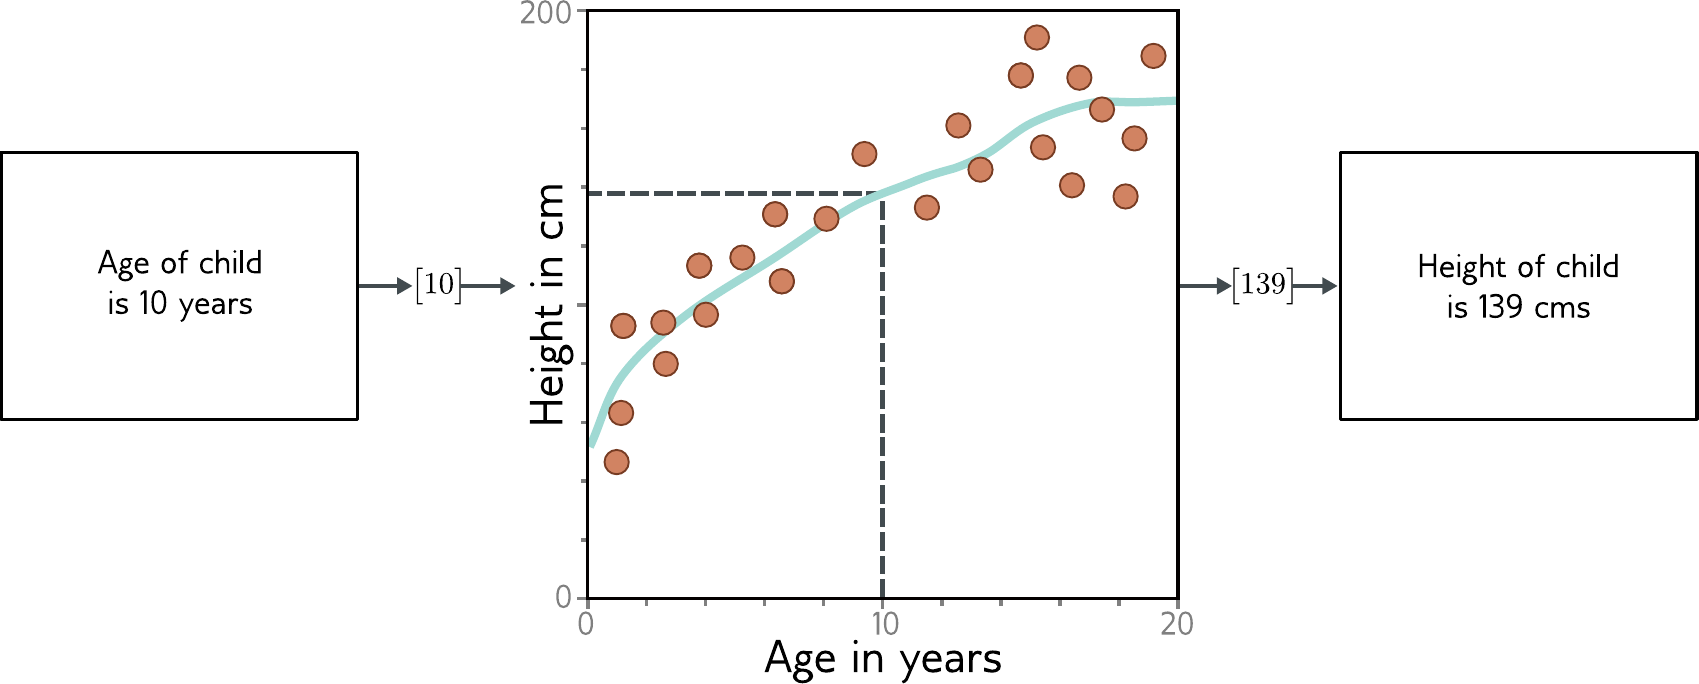
图 1.3 机器学习模型。模型代表一族将输入(儿童年龄)与输出(儿童身高)关联起来的关系。具体采用哪一种关系由训练数据决定;训练数据由若干输入/输出对(橙色点)构成。训练过程中,我们遍历所有可能的关系,从中选出一个能较好拟合数据的。此处,训练完成的模型即为青色曲线,可用于计算任意年龄对应的身高。
更准确地说,模型代表一族将输入映射到输出的方程(即一族不同的青色曲线)。具体选用哪条曲线由训练数据(training data,即输入/输出对的样本)决定。在图 1.3 中,这些数据对用橙色点表示,可以看到模型(青色线)合理地描述了这些数据。当我们说训练(training)或拟合(fitting)一个模型时,意思是在将输入映射到输出的所有可能方程(所有可能的青色曲线)中搜索,找到最准确描述训练数据的那一个。
由此可知,图 1.2 中的模型需要带标签的输入/输出对进行训练。例如,音乐分类模型需要大量音频片段,且每个片段都已由人类专家标注了所属流派。这些输入/输出对在训练过程中扮演教师或监督者的角色,这就是监督学习(supervised learning)一词的由来。
1.1.4 深度神经网络
本书讨论的是深度神经网络,它是一类特别有用的机器学习模型。深度神经网络是能够表示极其广泛的输入到输出映射关系族的方程,且在这个族中搜索描述训练数据的那条关系特别容易。
深度神经网络能够处理非常大的、变长的、包含各种内部结构的输入。它们既可以输出单个实数(回归)、多个实数(多元回归),也可以输出两个或更多类别上的概率(二分类和多分类)。正如下一节所述,它们的输出同样可以非常大、变长,并包含内部结构。这样的方程或许很难想象,读者不妨暂且接受这一点。
1.1.5 结构化输出
图 1.4a 展示了一个用于语义分割的多变量二分类模型。在该模型中,输入图像的每个像素被赋予一个二值标签,指示其属于牛还是背景。图 1.4b 展示了一个多变量回归模型,输入为一幅街景图像,输出为每个像素处的深度值。在这两种情况下,输出都是高维且结构化的。然而,这种结构与输入紧密相关,且可被利用:如果一个像素被标记为"牛",那么具有相似 RGB 值的相邻像素很可能也是同一标签。
图 1.4c–e 展示了三个输出具有复杂结构但与输入关联不那么直接的模型。图 1.4c 展示了一个输入为音频文件、输出为转录文字的模型。图 1.4d 是一个翻译模型,输入为一段英文文本,输出为对应的法文翻译。图 1.4e 描绘了一个极具挑战性的任务:输入是一段描述性文本,模型需要生成与该描述相匹配的图像。
原则上,后三项任务可以在标准的监督学习框架下处理,但由于两个原因,它们更加困难。首先,输出可能确实存在歧义:一个英语句子到法语的翻译可能有多种合理的译法,而任何描述也可能对应多幅图像。其次,输出包含大量结构:并非所有单词序列都能构成有效的英语或法语句子,也并非所有 RGB 值的集合都能形成逼真的图像。换言之,在学习映射关系的同时,我们还必须尊重输出的"语法"。
幸运的是,这种"语法"可以在不需要输出标签的情况下学习。例如,我们可以通过学习大规模文本语料库的统计特性来掌握如何生成合法的英语句子。这就引出了本书下一节要讨论的内容——无监督学习模型。
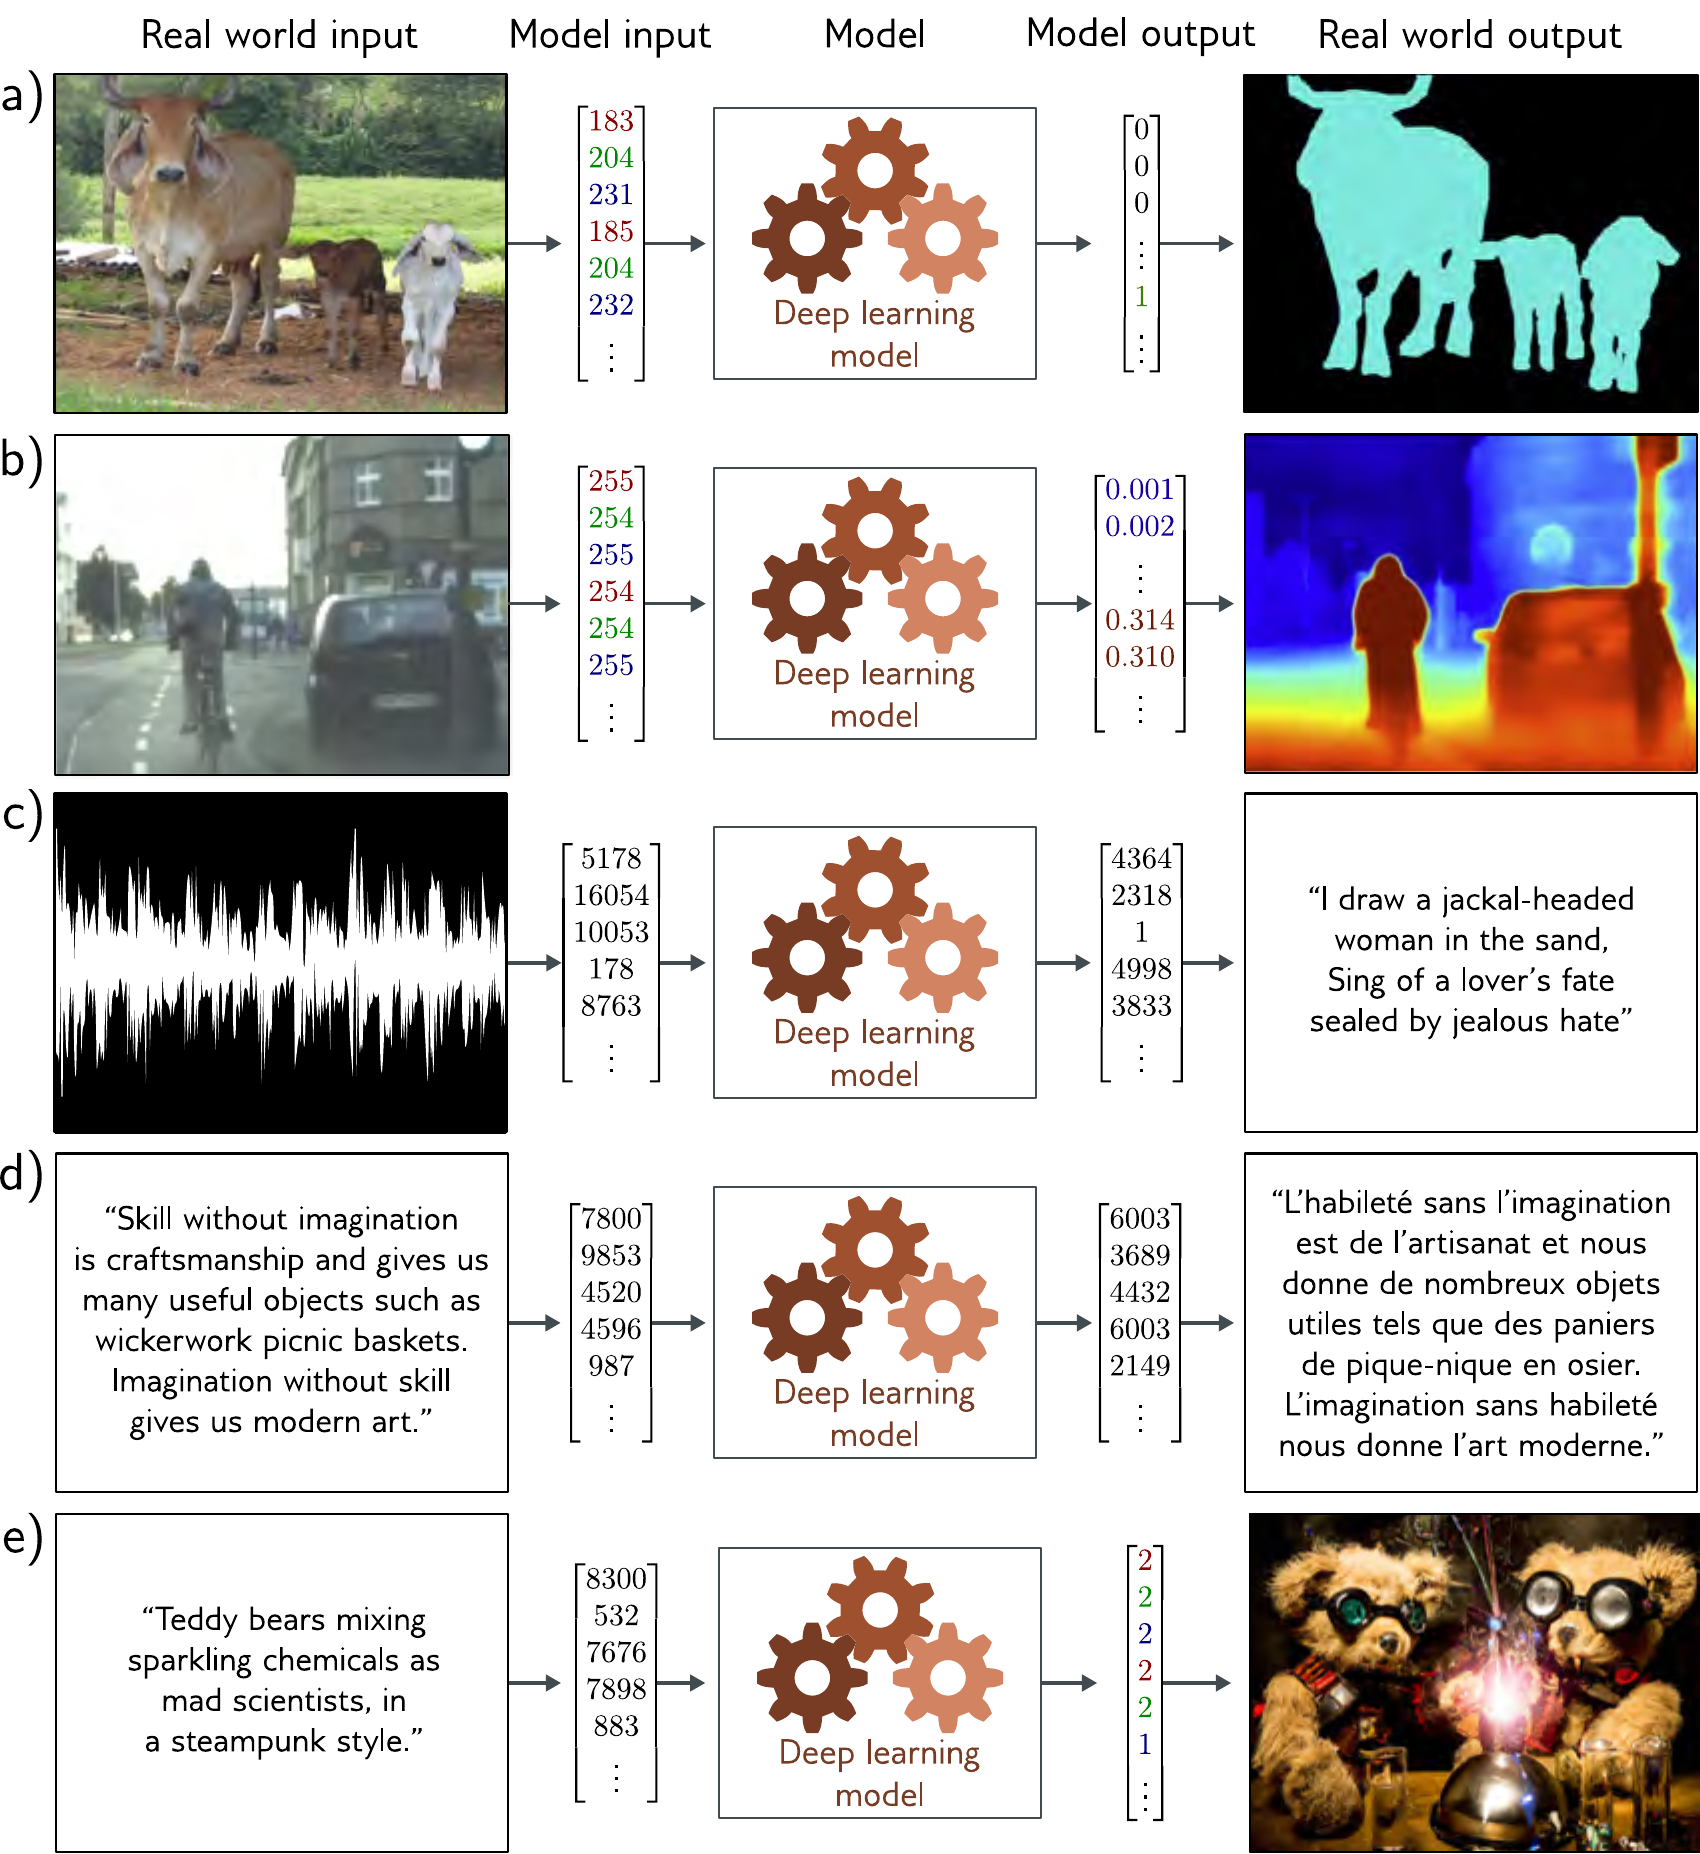
图 1.4 结构化输出。a) 语义分割模型为输入图像的每个像素分配一个二值标签(牛或背景)。b) 该模型为街景图像的每个像素预测一个深度值。c) 语音识别模型接收一段音频波形,输出其文字转录。d) 该模型将英文文本翻译为法文。e) 该模型根据文字描述生成匹配的图像。
1.2 无监督学习
在没有对应输出标签的情况下,从输入数据构建模型的方法称为无监督学习(unsupervised learning);由于缺少输出标签,也就不存在"监督"。与监督学习不同,其目标不是学习从输入到输出的映射,而是描述或理解数据的结构。正如监督学习中的情形一样,数据可能具有截然不同的特征:它可能是离散的或连续的,低维或高维的,固定长度或变长的。
1.2.1 生成模型
本书重点讨论生成式无监督模型(generative unsupervised models),它们学习合成与训练数据在统计上无法区分的新数据样本。一些生成模型显式描述输入数据上的概率分布,新样本通过从该分布中采样生成。另一些则仅学习一种生成新样本的机制,而不显式描述其分布。
最先进的生成模型能够合成极其逼真、但又不同于训练样本的新数据。它们在图像生成(图 1.5)和文本生成(图 1.6)方面尤为成功。它们还能在部分输出被预先确定的约束下合成数据(称为条件生成,conditional generation)。示例包括图像修复(image inpainting,图 1.7)和文本续写(text completion,图 1.8)。事实上,现代文本生成模型非常强大,以至于它们看起来具有智能。给定一段文本后面跟一个问题,模型通常能够通过生成最可能的文档续写来"填入"缺失的答案。然而,实际上模型只是了解了语言的统计规律,并不真正理解其答案的含义。
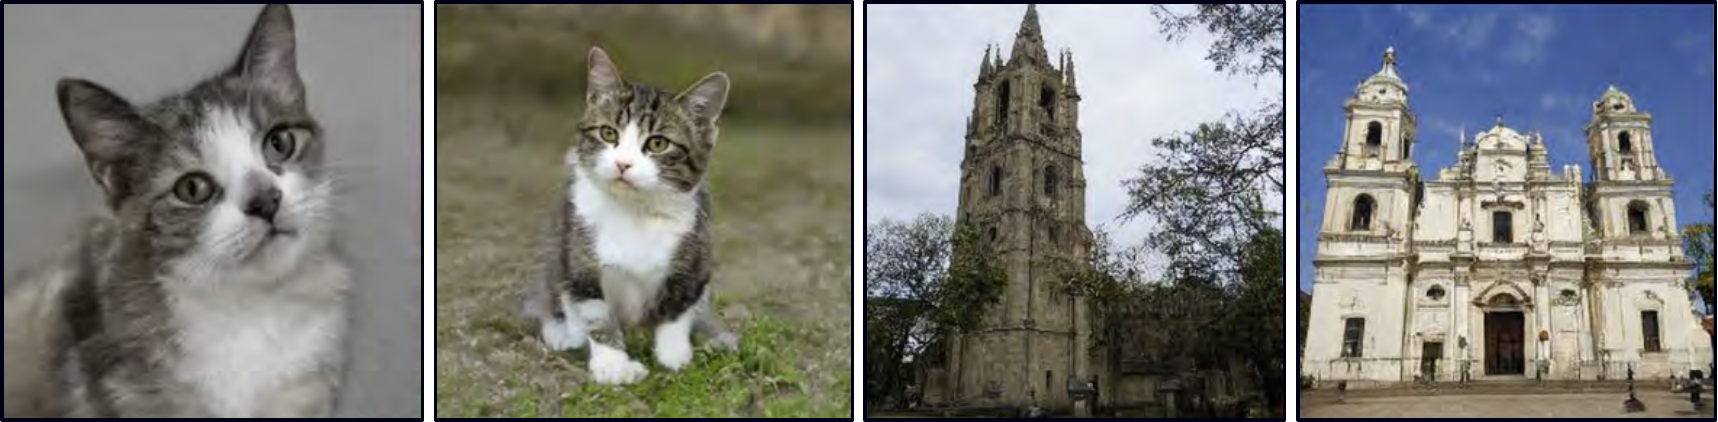
图 1.5 图像生成模型。左侧:由在猫的图片上训练的模型生成的两张图像。这些不是真正的猫,而是从概率模型中采样的结果。右侧:由在建筑物图片上训练的模型生成的两张图像。改编自 Karras et al. (2020b)。
生成文本示例
The moon had risen by the time I reached the edge of the forest, and the light that filtered through the trees was silver and cold. I shivered, though I was not cold, and quickened my pace. I had never been so far from the village before, and I was not sure what to expect. I had been walking for hours, and I was tired and hungry. I had left in such a hurry that I had not thought to pack any food, and I had not thought to bring a weapon. I was unarmed and alone in a strange place, and I did not know what I was doing.
I had been walking for so long that I had lost all sense of time, and I had no idea how far I had come. I only knew that I had to keep going. I had to find her. I was getting close. I could feel it. She was nearby, and she was in trouble. I had to find her and help her, before it was too late.
图 1.6 从文本数据生成模型中合成的短篇小说。该模型描述了一个概率分布,为每个可能的输出字符串赋予一个概率。从模型中采样所生成的字符串遵循训练数据(此处为短篇小说)的统计规律,但从未出现过。
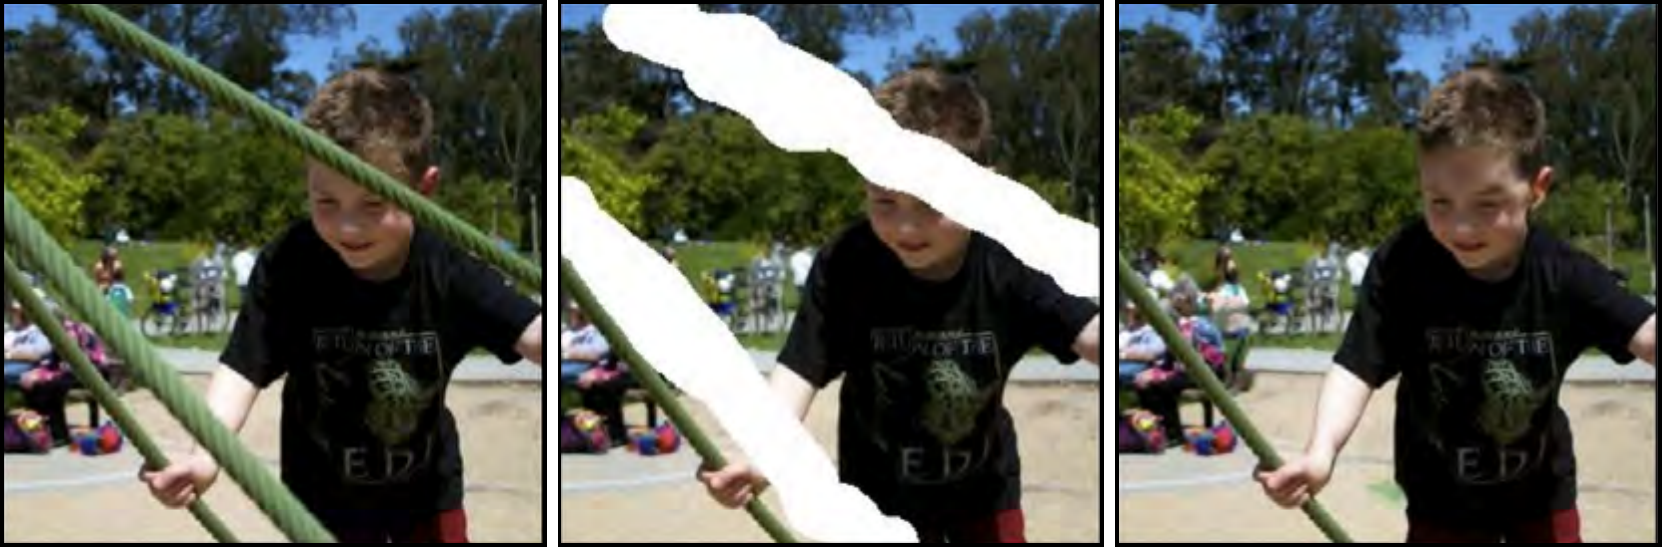
图 1.7 图像修复。在原始图像(左)中,男孩被金属线缆遮挡。去除这些不需要的区域后(中),生成模型在保持其余像素不变的约束下合成了新图像(右)。改编自 Saharia et al. (2022a)。
条件文本生成示例
I was a little nervous before my first lecture at the University of Bath. It seemed like there were hundreds of students and they looked intimidating. I stepped up to the lectern and was about to speak when something bizarre happened.
Suddenly, the room was filled with a deafening noise, like a giant roar. It was so loud that I couldn't hear anything else and I had to cover my ears. I could see the students looking around, confused and frightened. Then, as quickly as it had started, the noise stopped and the room was silent again.
I stood there for a few moments, trying to make sense of what had just happened. Then I realized that the students were all staring at me, waiting for me to say something. I tried to think of something witty or clever to say, but my mind was blank. So I just said, "Well, that was strange," and then I started my lecture.
图 1.8 条件文本合成。给定一段初始文本(黑色部分),文本生成模型可以通过合成"缺失"的后续部分来合理地续写该字符串。由 GPT3 (Brown et al., 2020) 生成。
1.2.2 潜变量
部分(但非全部)生成模型利用了这样一个事实:数据的实际维度可能远低于观测变量的原始数量所暗示的维度。例如,有效且有意义的英语句子的数量远少于随机拼凑单词所能产生的字符串数量。同样,真实世界的图像只是为每个像素随机选取红、绿、蓝(RGB)值所能产生的全部图像的极小子集。这是因为图像是由物理过程生成的(见图 1.9)。
这引出了一个理念:我们可以用较少数量的底层潜变量(latent variables)来描述每一个数据样本。在此框架下,深度学习的作用是描述潜变量与数据之间的映射关系。潜变量在设计上通常具有简单的概率分布。通过从该简单分布中采样,再将采样结果通过深度学习模型映射,我们便能生成新的样本(图 1.10)。
这些模型还催生了操控真实数据的新方法。例如,考虑找到两个真实样本所对应的潜变量,我们可以在它们的潜在表示之间进行插值,并将中间位置映射回数据空间,从而在两个样本之间实现平滑过渡(图 1.11)。
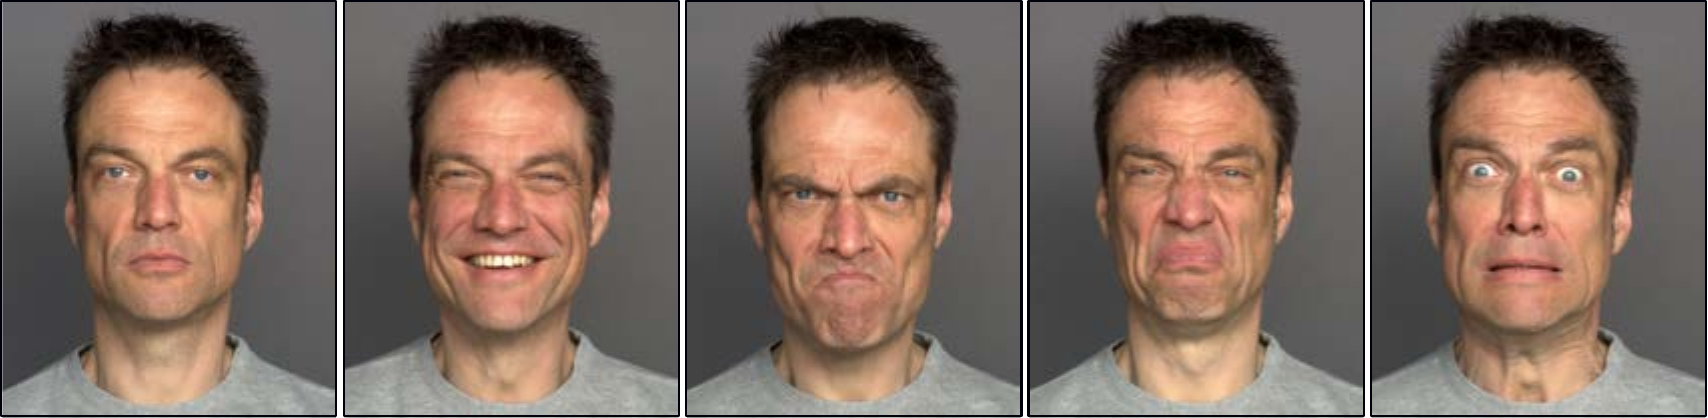
图 1.9 人脸的变化。人脸大约包含 42 块肌肉,因此仅用 42 个数字就可以描述同一人在相同光照下的面部图像的大部分变化。一般来说,图像、音乐和文本等数据集可以用相对较少的底层变量来描述,尽管将这些变量与特定的物理机制对应起来通常更加困难。图像来自 Dynamic FACES 数据库 (Holland et al., 2019)。
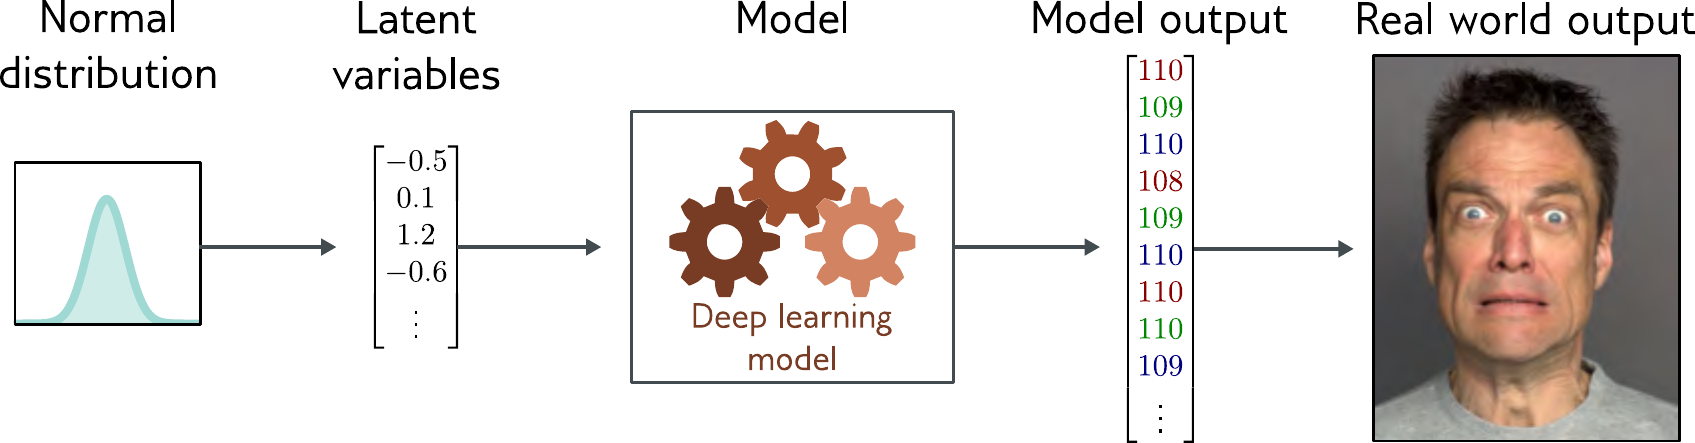
图 1.10 潜变量。许多生成模型使用深度学习模型来描述低维"潜"变量与观测到的高维数据之间的关系。潜变量在设计上具有简单的概率分布。因此,可以通过从简单分布中采样潜变量,然后利用深度学习模型将采样映射到观测数据空间来生成新样本。
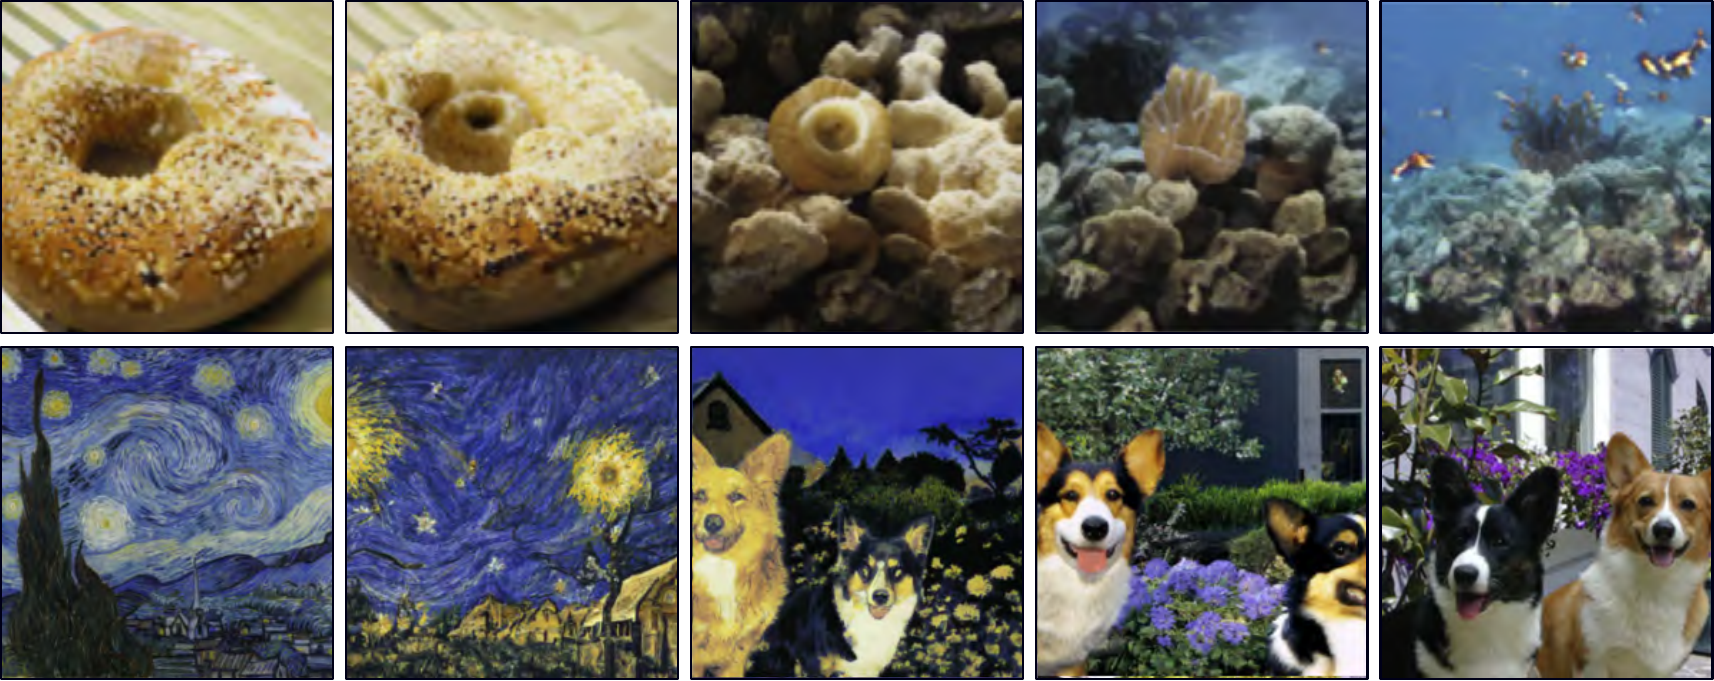
图 1.11 图像插值。每行中左右两端的图像是真实图像,中间的三幅图像是由生成模型创建的插值序列。支撑这些插值的生成模型已经学习到,所有图像都可以由一组底层潜变量生成。通过找到两幅真实图像对应的潜变量值,对其进行插值,然后利用中间变量生成新图像,我们可以产生既视觉逼真又融合了两幅原始图像特征的中间结果。上行改编自 Sauer et al. (2022)。下行改编自 Ramesh et al. (2022)。
1.2.3 连接监督学习与无监督学习
具有潜变量的生成模型还能增强输出具有结构的监督学习模型(图 1.4)。例如,考虑学习根据文字描述预测对应图像的任务。与其直接将文本输入映射为图像,不如学习解释文本的潜变量与解释图像的潜变量之间的关系。
这样做有三个优势。首先,由于输入和输出现在都是低维的,学习该映射所需的文本/图像对可能更少。其次,生成逼真图像的可能性更大;潜变量的任何合理取值都应该能生成像样的样本。第三,如果我们在两组潜变量之间的映射或从潜变量到图像的映射中引入随机性,就能生成多幅均与文字描述很好匹配的不同图像(图 1.12)。
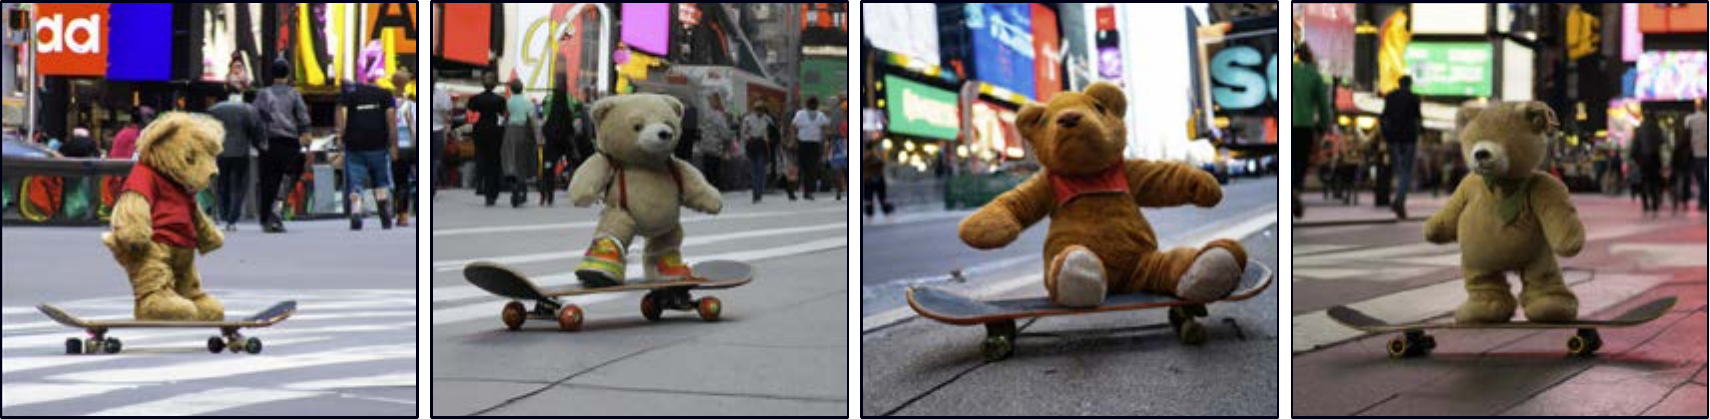
图 1.12 根据描述"时代广场上骑滑板的泰迪熊"生成的多幅图像。由 DALL·E-2 (Ramesh et al., 2022) 生成。
1.3 强化学习
机器学习的第三大领域是强化学习。该范式引入了智能体(agent)的概念:智能体存在于一个环境中,在每个时间步可以执行某些动作。这些动作改变系统状态,但不一定以确定性的方式。执行动作还可能产生奖励,强化学习的目标是让智能体学会选择能平均获得高奖励的动作。
一个复杂之处在于,奖励可能在动作执行之后的一段时间才出现,因此将奖励与具体动作关联起来并不直接。这被称为时间信用分配问题(temporal credit assignment problem)。在学习过程中,智能体必须在探索(exploration)和利用(exploitation)之间权衡取舍:也许智能体已经学会了获取适度奖励的方法,它是应该继续执行已知的策略(利用已有知识),还是应该尝试不同的动作以寻求可能的改进(探索其他机会)?
1.3.1 两个示例
考虑教一个人形机器人行走。机器人在任意时刻可以执行有限数量的动作(移动各个关节),这些动作会改变世界的状态(即机器人的姿态)。我们可以奖励机器人在障碍物训练场中到达各个检查点。为了到达每个检查点,机器人必须执行大量动作,但在获得奖励时,哪些动作起了关键作用、哪些无关紧要并不清楚。这就是时间信用分配问题的一个实例。
第二个示例是学习下棋。同样,智能体在任意时刻拥有一组有效动作(棋步)。然而,这些动作以非确定性的方式改变系统状态——对于任何走法,对手都可能做出多种不同的回应。我们可以设置一个基于吃子的奖励结构,或者仅在赢棋时给予一个奖励。在后一种情况下,时间信用分配问题尤为突出:系统必须判断它所走的众多棋步中,哪些对最终的胜利或失败起了关键作用。
探索与利用的权衡同样在这两个示例中有所体现。机器人可能发现它可以侧身趴下、用一条腿推进前行。这种策略确实能让机器人移动并获得奖励,但速度远不如最优方案——靠双腿站立行走。因此,它面临着在利用已知策略(如何笨拙地在地板上滑行)和探索动作空间(可能发现快得多的运动方式)之间的选择。同样,在国际象棋中,智能体可能学会了一套合理的开局走法,它应该利用这些知识还是去探索不同的开局序列?
深度学习如何融入强化学习框架或许并不显而易见。有多种可能的方法,其中一种技术是使用深度网络来构建从观测到的世界状态到动作的映射。这被称为策略网络(policy network)。在机器人的例子中,策略网络会学习从传感器测量值到关节运动的映射。在国际象棋的例子中,网络会学习从棋盘当前状态到走法选择的映射(图 1.13)。
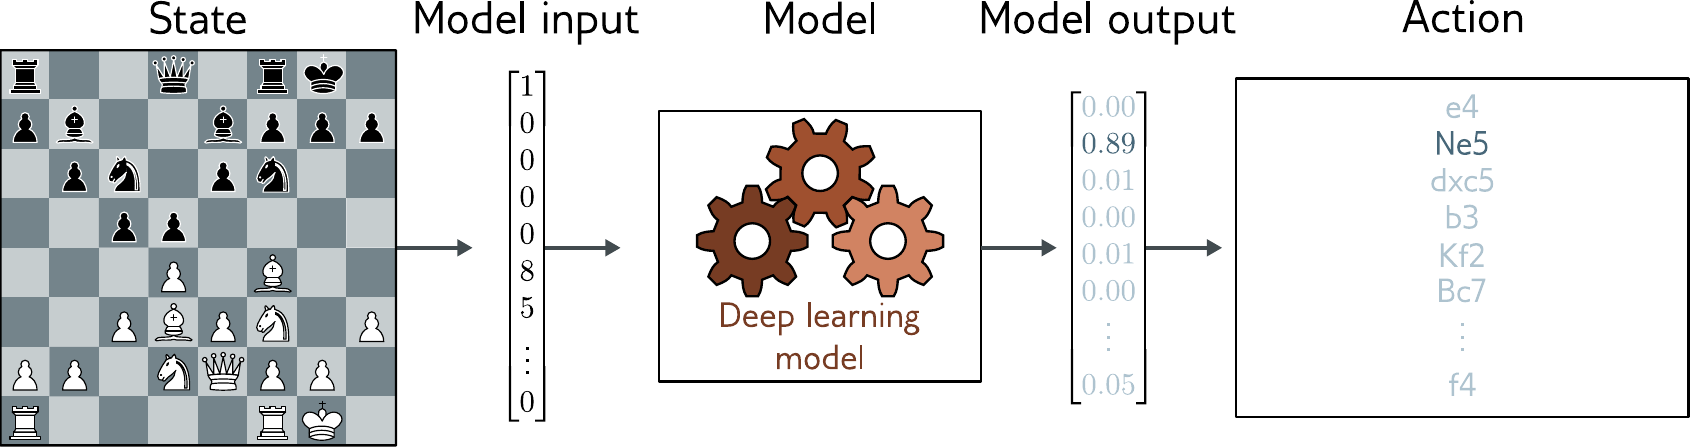
图 1.13 强化学习中的策略网络。将深度神经网络融入强化学习的一种方式是用它来定义从状态(此处为棋盘局面)到动作(可能的走法)的映射。这种映射称为策略(policy)。
1.4 伦理
如果不讨论人工智能的伦理影响,写这本书将是不负责任的。这项强大的技术将至少在与电力、内燃机、晶体管或互联网相同的程度上改变世界。它在医疗、设计、娱乐、交通、教育以及几乎所有商业领域的潜在益处是巨大的。然而,科学家和工程师往往对自己工作的成果过于乐观,而造成危害的潜在风险同样巨大。以下段落列举了五个值得关注的问题。
偏见与公平性: 如果我们基于历史数据训练一个预测个人薪资水平的系统,该系统将重现历史偏见——例如,它可能预测女性应该比男性获得更低的薪酬。此类案例已经多次成为国际新闻:一个用于超分辨率人脸恢复的 AI 系统将非白人面孔变得更白;一个用于生成律师图片的系统只产生男性图像。粗暴地应用 AI 进行算法决策可能会固化甚至加剧现有偏见。详见 Binns (2018)。
可解释性: 深度学习系统能够做出决策,但我们通常不知道它们究竟是如何做出决策的,也不知道依据了哪些信息。这些系统可能极其庞大,且无法通过检查来理解其工作原理。这催生了可解释 AI(explainable AI)这一子领域。一个取得一定成功的方向是产生局部解释(local explanations):虽然我们无法解释整个系统,但可以为某一特定决策生成可理解的解释。然而,是否真的有可能构建对用户甚至其创建者完全透明的复杂决策系统,仍是一个未知数。详见 Grennan et al. (2022)。
AI 武器化: 所有重大技术都曾被直接或间接地应用于战争。遗憾的是,暴力冲突似乎是人类行为中不可避免的一部分。AI 无疑是人类有史以来构建的最强大技术,并且毫无疑问将被广泛部署于军事领域。事实上,这已经在发生了(Heikkilä, 2022)。
权力集中: 世界上最强大的公司大力投资人工智能,并非出于改善人类命运的仁慈之心。它们深知这些技术将带来巨额利润。与任何先进技术一样,深度学习很可能将权力集中在控制它的少数组织手中。目前由人类完成的工作的自动化将改变经济环境,并不成比例地影响薪资较低、技能较少的劳动者的生计。乐观者认为工业革命时期也发生过类似的颠覆,最终带来了工时的缩短。事实是,我们根本不知道 AI 的大规模应用将对社会产生怎样的影响(见 David, 2015)。
存在性风险: 技术给人类带来的重大存在性风险概莫能外。气候变化源于工业化。核武器源于物理学研究。大规模传染病之所以更加频繁和迅速传播,是因为交通、农业和建筑领域的创新使人口变得更大、更密集、更互联。人工智能带来了新的存在性风险。我们应该对构建比人类更有能力且可无限扩展的系统保持高度警惕。在最乐观的情形下,它将把巨大的权力集中在少数人手中;在最悲观的情形下,我们将无法控制它,甚至无法理解它的意图(见 Tegmark, 2018)。
以上清单远非详尽。AI 还可能助长监控、虚假信息传播、隐私侵犯、欺诈、金融市场操纵,训练 AI 系统所需的能源也在加剧气候变化。更重要的是,这些担忧并非空穴来风——已经有许多在伦理上存疑的 AI 应用案例(参阅 Dao, 2021 获取部分列表)。此外,互联网的近代历史表明新技术可能以意想不到的方式造成危害。上世纪八九十年代的网络社区几乎不可能预见到假新闻、垃圾邮件、网络骚扰、欺诈、网络霸凌、非自愿色情、政治操纵、人肉搜索、网络激进化和报复色情的泛滥。
每一位研究或学习(或撰写相关书籍的)AI 从业者都应当思考,科学家在多大程度上应为其技术的使用负责。我们应当认识到,资本主义主要驱动着 AI 的发展,而法律法规和面向社会公益的部署很可能会显著滞后。我们应当反思,作为科学家和工程师,是否有可能控制该领域的进展以减少危害。我们应当考虑愿意为怎样的组织工作。它们在减少 AI 潜在危害方面有多认真?它们只是为了降低声誉风险而做"伦理粉饰",还是真正实施了机制来叫停伦理上存疑的项目?
鼓励所有读者进一步研究这些问题。在线课程 https://ethics-of-ai.mooc.fi/ 是一个有益的入门资源。如果你是使用本书授课的教授,请积极在课堂上讨论这些议题。如果你是尚未在课程中接触到这些话题的学生,请推动你的教授将其纳入教学。如果你在企业环境中部署或研究 AI,请审视你的雇主的价值观,并积极推动改变(如果它们有所欠缺的话——或者选择离开)。
1.5 本书结构
本书的结构呼应了本章引言的结构。第 2–9 章贯穿监督学习的完整流程:我们介绍浅层和深层神经网络,讨论如何训练它们、评估其性能并加以改进。第 10–13 章介绍深度神经网络的常见架构变体,包括卷积网络、残差连接和 Transformer。这些架构在监督学习、无监督学习和强化学习中均有应用。
第 14–18 章探讨利用深度神经网络进行无监督学习。我们为四种现代深度生成模型各设专章:生成对抗网络、变分自编码器、归一化流和扩散模型。第 19 章简要介绍深度强化学习。这一主题本身就足以单独成书,因此处理不可避免地较为简略。不过,该介绍旨在为不熟悉该领域的读者提供一个良好的起点。
尽管以"理解深度学习"为书名,深度学习的一些方面至今仍未被充分理解。第 20 章提出了一些基本问题:为什么深度网络如此容易训练?为什么它们的泛化能力如此之好?为什么需要如此庞大?它们真的需要很"深"吗?在探索这些问题的过程中,我们还会遇到一些出人意料的现象,如损失函数的结构、双重下降(double descent)、突现理解(grokking)和彩票假说(lottery tickets)。本书以第 21 章收尾,讨论伦理与深度学习。
1.6 其他书籍
本书是自含的,但内容仅限于深度学习。本书在精神上是 Deep Learning(Goodfellow et al., 2016)的继承者,该书是极好的资源,但未涵盖近期的进展。若想更广泛地了解机器学习,目前最全面和前沿的参考是 Probabilistic Machine Learning(Murphy, 2022, 2023)。此外,Pattern Recognition and Machine Learning(Bishop, 2006)依然是一本优秀且切题的著作。
如果你喜欢本书,我的前一本书 Computer Vision: Models, Learning, and Inference(Prince, 2012)也值得一读。书中部分内容已经过时,但它包含了对概率论的全面介绍,涵盖贝叶斯方法,以及对潜变量模型、计算机视觉中的几何、高斯过程和图模型的良好入门内容。它使用与本书完全相同的符号体系,且可在网上找到。图模型的详细处理可参见 Probabilistic Graphical Models: Principles and Techniques(Koller & Friedman, 2009),高斯过程可参见 Gaussian Processes for Machine Learning(Williams & Rasmussen, 2006)。
数学背景方面,请参阅 Mathematics for Machine Learning(Deisenroth et al., 2020)。若需更偏重编码的方法,请参阅 Dive into Deep Learning(Zhang et al., 2023)。计算机视觉方面的最佳概览是 Computer Vision: Algorithms and Applications(Szeliski, 2022)和 Foundations of Computer Vision(Torralba et al., 2024)。学习图神经网络的良好起点是 Graph Representation Learning(Hamilton, 2020)。强化学习的权威著作是 Reinforcement Learning: An Introduction(Sutton & Barto, 2018)。深度强化学习的优秀入门资源是 Foundations of Deep Reinforcement Learning(Graesser & Keng, 2019)。
1.7 如何阅读本书
本书后续大多数章节包含正文、注释部分和一组习题。正文是自含的,无需参考章节的其他部分即可阅读。背景数学知识尽可能融入正文。对于较大的、可能分散主线论证注意力的主题,背景材料被放入附录中,并在页边注中提供参考。本书中的大部分符号记法是标准的。然而,某些约定较少被使用,建议读者在阅读前参阅附录 A。
正文中包含了大量新颖的插图和深度学习模型与结果的可视化。我努力提供对现有思想的新颖解读,而不仅仅是策展他人的工作。深度学习是一个年轻的领域,某些现象尚未被充分理解。在需要的地方,我会明确指出哪些是确知的,以及何时应对我的解释持审慎态度。
参考文献仅在正文中引用描绘了结果的图片时才出现在正文中。其余引用位于每章末尾的注释部分。我一般不在正文中严格遵循历史先后;如果某一当前技术的前身已不再有用,我便不会提及。不过,该领域的历史发展在注释部分有所描述,且功劳的归属力求公正。注释按段落组织,并提供进一步阅读的指引。它们帮助读者在该子领域中定位自己,并理解其与机器学习其他部分的关联。注释部分的自含性不如正文。根据你的背景知识和兴趣,你可能觉得这些部分或多或少有用。
每章还配有若干习题。它们在正文的页边注中被标注在建议尝试的位置。正如 George Pólya 所言:"数学不是旁观者的运动。"他说得很对,我强烈建议你在阅读过程中尝试做这些习题。在某些情况下,它们提供的洞见将帮助你理解正文。答案可在配套网站(http://udlbook.com)上找到的习题用星号标注。此外,帮助你理解书中思想的 Python 笔记本也可通过该网站获取,并在正文页边注中引用。如果你觉得自己的数学功底有些生疏,现在就值得翻阅一下关于数学基础的笔记本。
不幸的是,AI 领域的研究步伐之快决定了本书将是一项持续进行的工作。如果有你觉得难以理解的部分、明显的遗漏,或看似多余的章节,请通过配套网站与我联系。我们可以一起把下一版做得更好。