
第19章 强化学习
前几章介绍了生成模型,这些模型从一组无标签样本中学习。本章考虑强化学习(reinforcement learning),其中模型通过与环境的一系列交互来学习。在每个时间步,模型接收关于环境状态的信息,并据此选择一个动作。这个动作改变环境的状态并产生奖励。我们的目标是学习一种策略(即选择动作的规则),使得期望的累积奖励最大化。
强化学习在研发能够击败人类玩家的 Atari 游戏代理和 AlphaGo 围棋系统方面发挥了重要作用。它也被用于训练大型语言模型聊天机器人,其中奖励来自人类反馈,目标是使模型生成更有帮助的回复。
本章首先形式化强化学习问题并描述其关键概念——马尔可夫决策过程、回报、策略和值函数。然后分别讨论表格方法(动态规划、蒙特卡洛方法和时序差分方法)、拟合 Q 学习(使用深度网络近似值函数)、策略梯度方法以及 Actor-Critic 方法。最后简要介绍离线强化学习。
19.1 马尔可夫决策过程、回报和策略
我们从马尔可夫决策过程的组成部分入手,逐步构建完整框架。
19.1.1 马尔可夫过程
马尔可夫过程(Markov process)或马尔可夫链(Markov chain)产生一个随机的状态序列
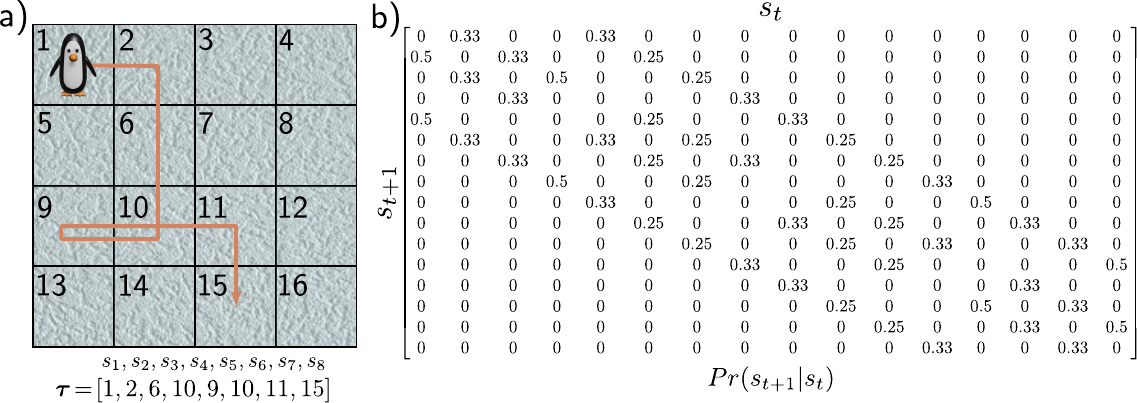
图 19.1 马尔可夫过程。a) 企鹅从左上角出发,在
网格上随机行走。在每个时间步,它以相等概率移动到相邻的格子。b) 转移概率 ;以状态 6 为例,它有四个邻居(状态 2、5、7 和 10),各有 0.25 的概率。c-d) 从左上角出发的两条可能的轨迹。
19.1.2 马尔可夫奖励过程
马尔可夫奖励过程(Markov reward process)为马尔可夫过程增加了奖励
其中
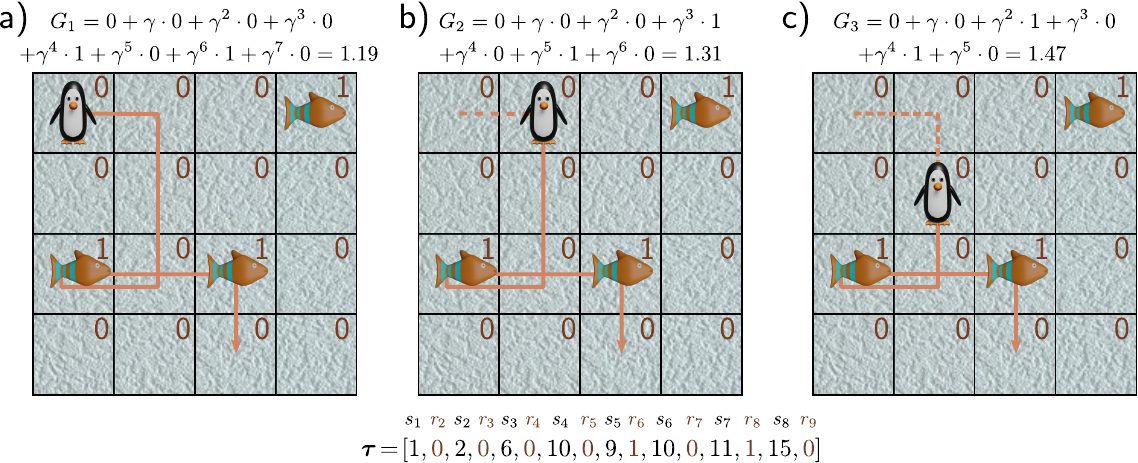
图 19.2 马尔可夫奖励过程。a) 企鹅在网格上行走。有些格子包含洞(奖励
)和鱼(奖励 ),空格子的奖励为零。b) 一条可能的轨迹。c) 该轨迹的回报是折扣奖励之和。
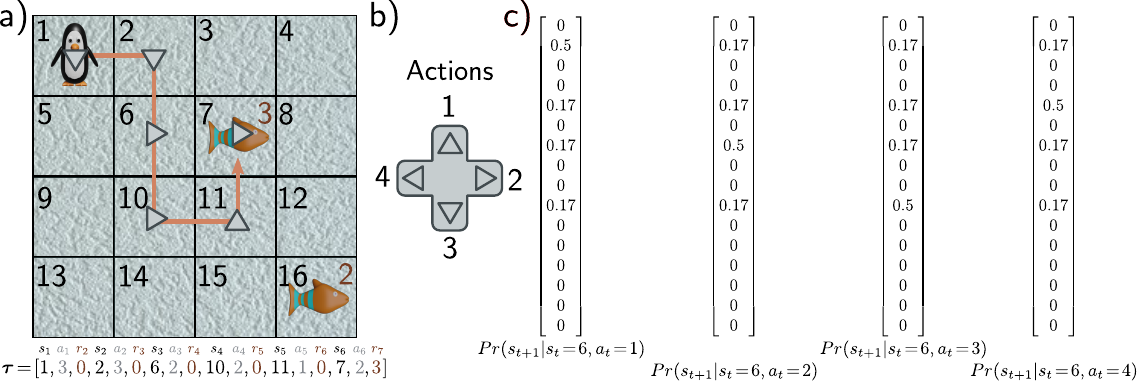
图 19.3 马尔可夫决策过程(MDP)。企鹅现在可以选择动作(上、下、左、右),但网格是湿滑的,所以它只有概率 0.5 按照选择的方向移动,其余概率均匀分配给其他有效方向。MDP 产生一个由状态、动作和奖励组成的序列。
19.1.3 马尔可夫决策过程
马尔可夫决策过程(Markov decision process)或 MDP 在每个时间步增加了一组可能的动作(actions)。动作
19.1.4 部分可观测马尔可夫决策过程
在部分可观测马尔可夫决策过程(partially observable Markov decision process)或 POMDP 中,状态不是直接可见的(图 19.4)。智能体接收的是从
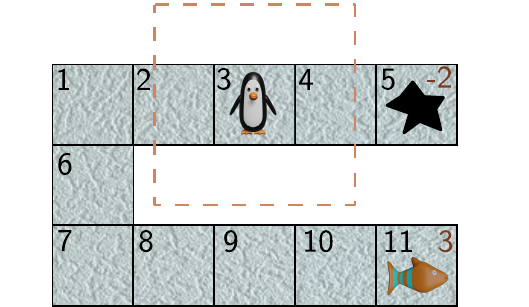
图 19.4 部分可观测马尔可夫决策过程(POMDP)。在 POMDP 中,智能体无法获得完整的状态信息。这里,企鹅不知道当前状态,只能看到附近的格子(虚线框)。不幸的是,真实状态(3)与状态 9 中看到的情况无法区分。在第一种情况下,向右移动会导致掉入洞中(奖励
),而在后一种情况下,会到达鱼(奖励 )。
19.1.5 策略
确定智能体在每个状态下的动作的规则被称为策略(policy)(图 19.5)。策略可以是随机的(stochastic,策略为每个状态的动作定义一个分布)或确定性的(deterministic,智能体在给定状态下总是采取相同的动作)。随机策略
环境和智能体形成一个循环(图 19.6)。智能体接收上一时间步的状态
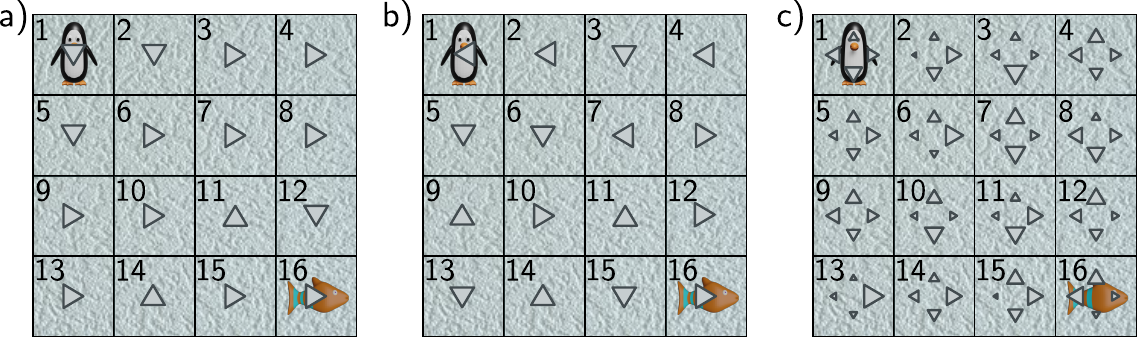
图 19.5 策略。a) 确定性策略在每个状态下总是选择相同的动作(由箭头指示)。有些策略比其他策略更好。这个策略不是最优的,但总体上能将企鹅从左上角引导到右下角的奖励处。b) 这个策略更加随机。c) 随机策略为每个状态的动作定义一个概率分布(由箭头大小表示概率)。这样的优势是智能体能更充分地探索各个状态,在部分可观测的 MDP 中可能是最优性能所必需的。
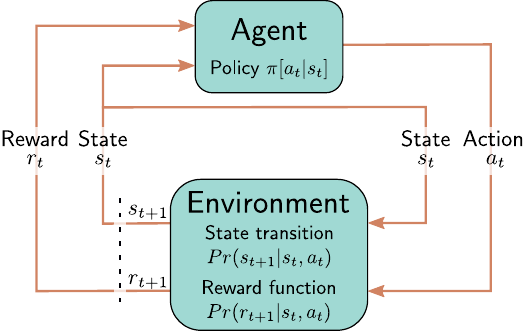
图 19.6 强化学习循环。智能体在时间
根据状态 按照策略 采取动作 。这触发了新状态 的生成(通过状态转移函数)和奖励 (通过奖励函数)的产生。两者都反馈给智能体,然后智能体选择新的动作。
19.2 期望回报
上一节介绍了马尔可夫决策过程和智能体按照策略执行动作的概念。我们希望选择一个使期望回报最大化的策略。在本节中,我们将这个概念精确化。为此,我们为每个状态
19.2.1 状态值和动作值
回报
我们可以通过考虑期望回报
非形式化地说,状态值告诉我们如果从这个状态开始并此后遵循指定策略,平均能期望获得的长期奖励。对于即将带来大奖励的后续转移的状态,它的值最高(假设折扣因子
类似地,动作值(action value)或状态-动作值函数(state-action value function)
动作值告诉我们如果从这个状态开始、采取这个动作、然后此后遵循指定策略,平均能期望获得的长期奖励。通过这个量,强化学习算法将未来奖励与当前动作联系起来(即解决时间信用分配问题)。
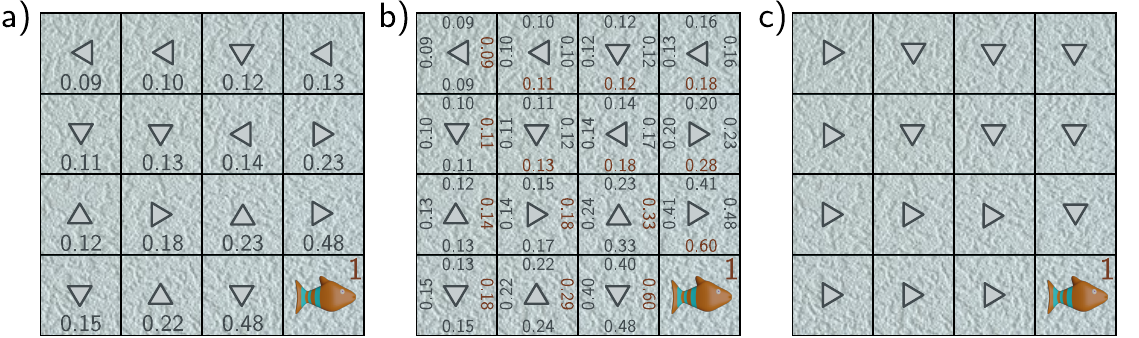
图 19.7 状态值和动作值。a) 状态
的值 (每个位置处的数字)是该状态在给定策略 (灰色箭头)下的期望回报。它是从该状态出发的多条轨迹上获得的折扣奖励的平均和。这里,离鱼越近的状态越有价值。b) 状态 中动作 的值 (每个位置/状态对应四个数字,对应四个动作)是在该特定动作被采取的条件下的期望回报。在这种情况下,离鱼越近值越大,朝向鱼的方向的动作值也越大。c) 如果我们知道一个状态的动作值,就可以修改策略使其选择这些值的最大值对应的动作(面板 b 中的红色数字)。
19.2.2 最优策略
我们希望找到使期望回报最大化的策略。对于 MDP(但不适用于 POMDP),总存在一个确定性的平稳策略能最大化每个状态的值。如果我们知道这个最优策略,就能得到最优状态-值函数
类似地,最优状态-动作值函数在最优策略下获得:
反过来,如果我们知道最优动作值
实际上,一些强化学习算法就是基于交替估计动作值和策略的(参见 19.3 节)。
19.2.3 贝尔曼方程
我们可能不知道任何策略的状态值
类似地,一个动作的值是采取该动作产生的即时奖励
将公式 19.8 代入公式 19.7,得到时间
类似地,将公式 19.7 代入公式 19.8,得到时间
后面两个关系就是贝尔曼方程(Bellman equations),是许多强化学习方法的基础。简而言之,它们要求状态(动作)值必须是自洽的。因此,当我们更新一个状态(动作)值的估计时,会产生连锁反应,导致对所有其他值的修改。
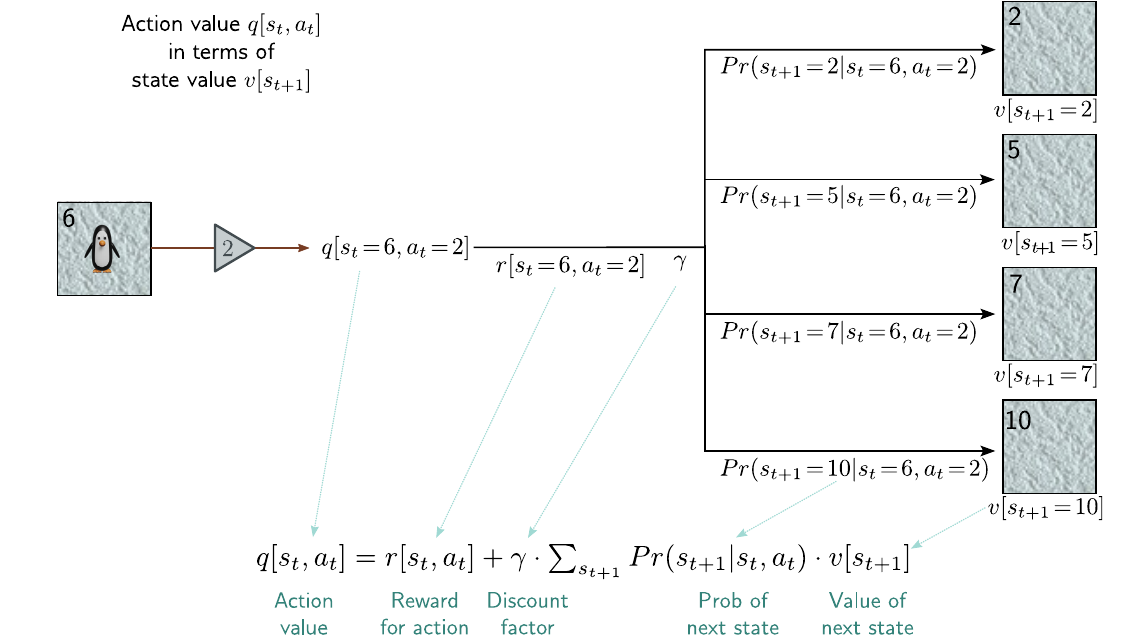
图 19.8 状态值和动作值之间的关系。状态 6 的值
是状态 6 处动作值 的加权和,权重是策略概率 。
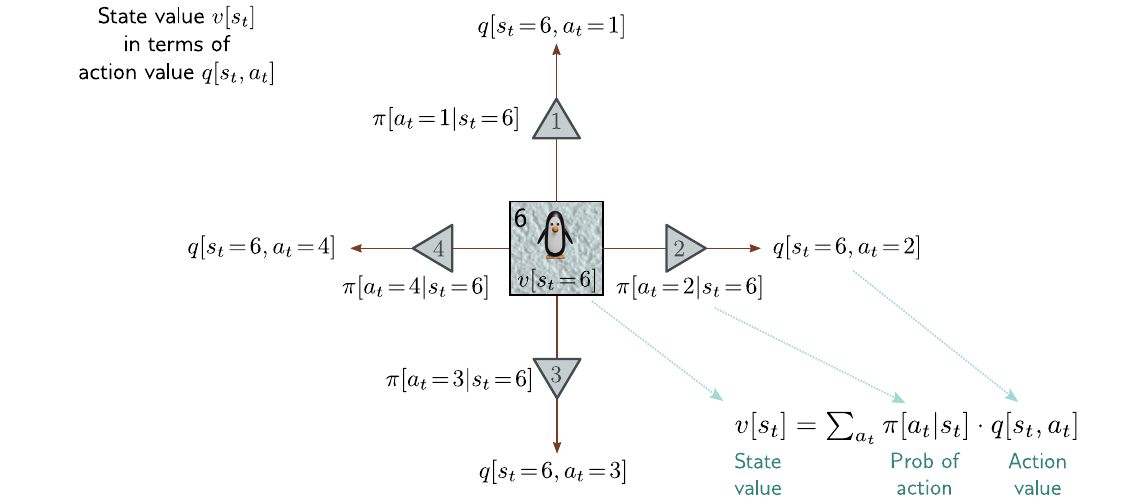
图 19.9 动作值和状态值之间的关系。在状态 6 采取动作 2 的值
是采取该动作的奖励 加上后续状态中折扣值 的加权和,权重是转移概率 。贝尔曼方程将这个关系与图 19.8 的关系串联起来,将当前和下一时刻的 (i) 状态值和 (ii) 动作值联系起来。
19.3 表格强化学习
表格强化学习算法(tabular RL algorithms,即不依赖函数近似的算法)分为基于模型的(model-based)方法和无模型的(model-free)方法。基于模型的方法显式使用 MDP 结构(转移矩阵
相反,无模型方法假设底层 MDP 的转移矩阵和奖励结构是未知的。这些方法分为两类:
- 值估计(value estimation)方法估计最优状态-动作值函数,然后根据每个状态中具有最大值的动作来分配策略。
- 策略估计(policy estimation)方法使用梯度下降技术直接估计最优策略,不需要估计模型或值函数的中间步骤。
在每个类别中,蒙特卡洛(Monte Carlo)方法通过模拟策略在 MDP 中的多条轨迹来收集如何改进该策略的信息。有时在更新策略之前模拟很多轨迹是不可行或不实际的。时序差分(temporal difference, TD)方法在智能体遍历 MDP 的同时更新策略。
我们现在简要描述动态规划方法、蒙特卡洛值估计方法和 TD 值估计方法。第 19.4 节描述了深度网络如何用于 TD 值估计方法。我们在第 19.5 节回到策略估计。
19.3.1 动态规划
动态规划算法假设我们拥有转移和奖励结构的完美知识。在这方面,它们区别于大多数观察智能体与环境交互以间接收集这些信息的强化学习算法。
状态值
策略评估: 我们遍历所有状态
其中
策略改进: 为了更新策略,我们贪心地选择使每个状态的值最大化的动作:
根据策略改进定理,这保证能改进策略。这两个步骤迭代直到策略收敛(图 19.10)。
这种方法有许多变体。在策略迭代(policy iteration)中,策略评估步骤迭代到收敛后再进行策略改进。值可以就地更新也可以同步更新。在值迭代(value iteration)中,策略评估过程只遍历一次值就进行策略改进。异步(asynchronous)动态规划算法不需要在每一步系统地遍历所有值,而是可以按任意顺序更新状态子集。
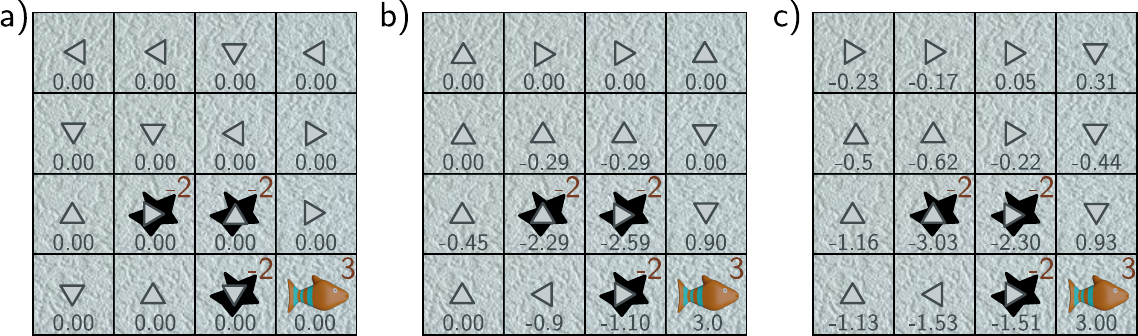
图 19.10 动态规划。a) 状态值初始化为零,策略(箭头)随机选择。b) 状态值更新为与其邻居一致(公式 19.11,显示两次迭代后的结果)。策略更新为将智能体移向具有最高值的状态(公式 19.12)。c) 经过多次迭代,算法收敛到最优策略,其中企鹅试图避开洞并到达鱼。
19.3.2 蒙特卡洛方法
与动态规划算法不同,蒙特卡洛方法不需要知道 MDP 的转移概率和奖励结构。相反,它们通过从 MDP 中重复采样轨迹并观察奖励来获取经验。它们交替进行动作值的计算(基于这些经验)和策略的更新(基于动作值)。
为了估计动作值
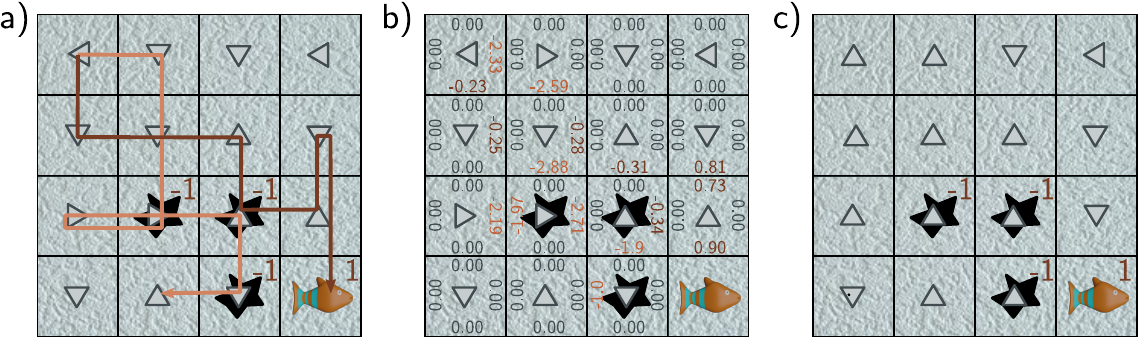
图 19.11 蒙特卡洛方法。a) 策略(箭头)随机初始化。MDP 被反复模拟,这些回合的轨迹被存储(橙色和棕色路径代表两条轨迹)。b) 动作值基于这些轨迹上观察到的回报的平均值来经验性估计。在这种情况下,动作值初始都为零,且仅在观察到某动作的地方进行了更新。c) 然后可以根据获得最好(或最不差)奖励的动作来更新策略。
这是一种在策略(on-policy)方法;当前最优策略被用来引导智能体通过环境。这个策略基于观测到的动作值,但当然,无法估计那些从未使用过的动作的值,也没有什么能鼓励算法去探索这些动作。一种解决方案是使用探索性起始(exploring starts),即以所有可能的状态-动作对发起回合,使得每种组合至少被观察一次。然而,如果状态数量很大或起始点不可控制,这是不切实际的。另一种方法是使用
相反,在离策略(off-policy)方法中,最优策略
19.3.3 时序差分方法
动态规划方法使用自举过程来更新值,使其在当前策略下自洽。蒙特卡洛方法通过采样 MDP 来获取信息。时序差分(temporal difference, TD)方法结合了自举和采样。然而,与蒙特卡洛方法不同的是,它们在智能体遍历 MDP 的过程中而不是之后更新值和策略。
SARSA(State-Action-Reward-State-Action)是一种在策略算法,更新规则为:
其中
相反,Q 学习(Q-Learning)是一种离策略算法,更新规则为(图 19.12):
其中每一步的动作选择来自不同的行为策略
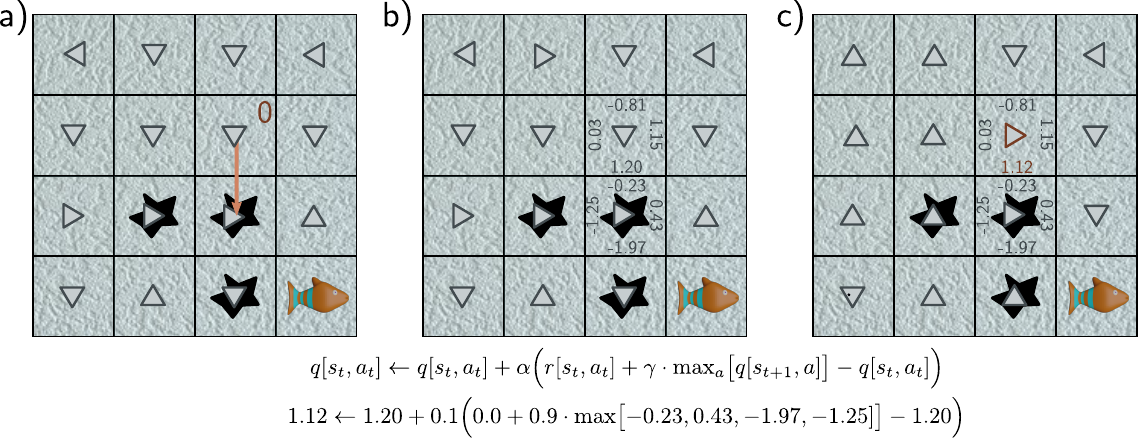
图 19.12 Q 学习。a) 智能体从状态
开始,按照策略采取动作 。它没有在冰上滑倒,所以向下移动,离开原始状态获得奖励 。b) 新状态的最大动作值(这里为 0.43)。c) 原始状态中动作 2 的动作值根据后续状态最大动作值的当前估计、奖励、折扣因子 和学习率 更新为 1.12。这改变了原始状态处最高的动作值,因此策略也随之改变。
19.4 拟合 Q 学习
上述表格蒙特卡洛和 TD 算法反复遍历整个 MDP 并更新动作值。然而,这仅在状态-动作空间较小时才可行。不幸的是,这种情况很少出现;即使在棋盘这样受约束的环境中,也有超过
在拟合 Q 学习(fitted Q-learning)中,动作值的离散表示
由此得到更新规则:
拟合 Q 学习与 Q 学习的不同之处在于不再保证收敛。参数的改变同时影响目标
19.4.1 用于玩 ATARI 游戏的深度 Q 网络
深度网络非常适合从高维状态空间进行预测,因此是拟合 Q 学习中模型的自然选择。原则上,它们可以同时接受状态和动作作为输入来预测值,但在实践中,网络只接受状态并同时预测每个动作的值。
深度 Q 网络(Deep Q-Network)是一个突破性的强化学习架构,利用深度网络学习玩 ATARI 2600 游戏。观测数据包括
对标准训练过程做了几项修改。首先,奖励(由游戏分数驱动)被裁剪为负变化
最后,拟合 Q 网络中的收敛问题通过将目标参数固定为值
现在网络不再追逐一个移动的目标,更不容易发生振荡。
使用这些启发式方法和
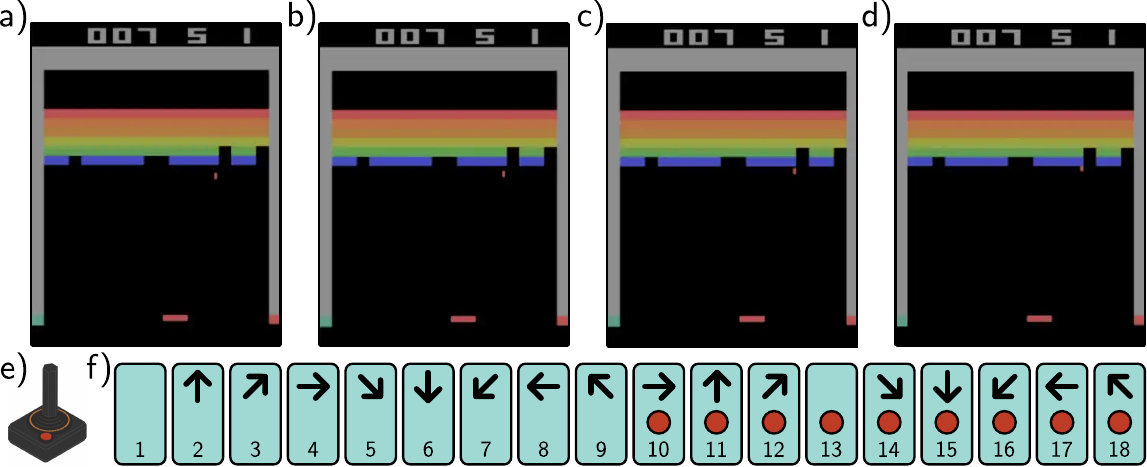
图 19.13 Atari 基准测试。Atari 基准测试由 49 个 Atari 2600 游戏组成,包括 Breakout(图中所示)、Pong 以及各种射击、平台和其他类型的游戏。a-d) 即使是单屏游戏,由于物体速度未知,状态也不是完全可观测的。因此,通常使用多个相邻帧(这里为四帧)来表示状态。e) 动作模拟用户通过摇杆的输入。f) 有 18 个动作,对应八个移动方向或不移动,以及每种情况下按钮是否按下。
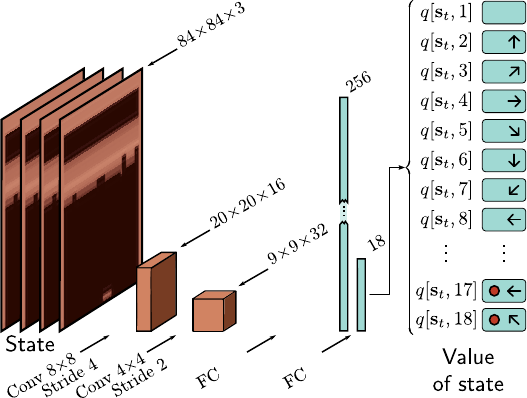
图 19.14 深度 Q 网络架构。输入
由 ATARI 游戏的四个相邻帧组成。每帧调整为 并转换为灰度。这些帧作为四个通道表示,经过 步长 4 的卷积处理,然后是 步长 2 的卷积,再接两个全连接层。最终输出预测该状态下 18 个动作中每个动作的动作值 。
19.4.2 双重 Q 学习和双重深度 Q 网络
Q 学习的一个潜在缺陷是更新中对动作的最大化操作:
会导致估计的动作值
根本问题是同一个网络既选择目标(通过最大化操作)又更新值。双重 Q 学习(Double Q-Learning)通过同时训练两个模型
现在目标的选择和目标本身被解耦,这有助于防止这些偏差。在实践中,新的元组
19.5 策略梯度方法
Q 学习先估计动作值,然后利用它们来更新策略。相反,基于策略的方法(policy-based methods)直接学习随机策略
- 随机策略自然有助于空间的探索;我们不必在每个时间步都采取最优动作。
- 当我们修改随机策略时,损失平滑变化。这意味着即使奖励是离散的,我们也可以使用梯度下降方法。这类似于在(离散的)分类问题中使用最大似然。当模型参数改变时,损失平滑变化以使真实类别更可能。
- MDP 假设通常是不正确的;我们通常不具有状态的完整知识。例如,考虑一个智能体在只能观察附近位置的环境中导航(例如,图 19.4)。如果两个位置看起来相同但附近的奖励结构不同,随机策略允许采取不同动作的可能性,直到这种模糊性被消除。
19.5.1 梯度更新的推导
考虑通过 MDP 的一条轨迹
策略梯度算法旨在最大化许多此类轨迹上的期望回报。这些轨迹从分布
其中
其中
这个方程有一个简单的解释(图 19.15);更新改变参数
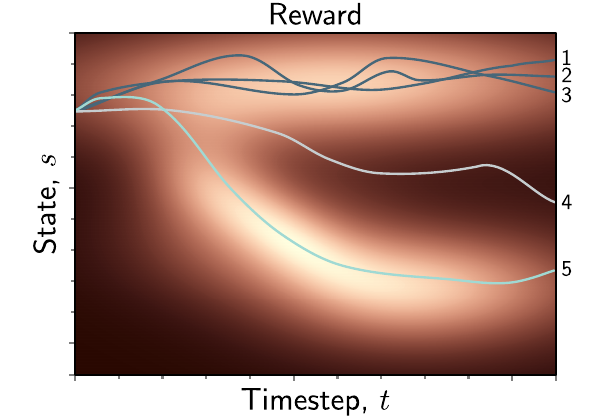
图 19.15 策略梯度。同一策略的五个回合(更亮表示更高奖励)。轨迹 1、2 和 3 持续产生较高的奖励,但类似轨迹在这个策略下已经频繁出现,所以无需改变。相反,轨迹 4 获得的奖励很低,因此应该修改策略以避免产生类似轨迹。轨迹 5 获得了高奖励且不常见。这将导致公式 19.25 下策略的最大变化。
我们可以使用似然比恒等式(likelihood ratio identity)来简化这个表达式:
由此得到更新:
轨迹的对数概率
注意到只有中间项依赖于
其中
我们可以进一步注意到:
其中
19.5.2 REINFORCE 算法
REINFORCE 是一种早期的策略梯度算法,利用了上述结果并引入了折扣。它是一种蒙特卡洛方法,基于当前策略
对于每个回合
然后我们对每条轨迹中的每个时间步
其中
19.5.3 基线
策略梯度方法具有高方差;可能需要很多回合才能获得稳定的导数估计。减少方差的一种方法是从轨迹回报
只要基线
期望值不会改变。然而,如果基线与增加不确定性的无关因素协变,则减去它可以降低方差(图 19.16)。这是控制变量(control variates)方法的一个特例。
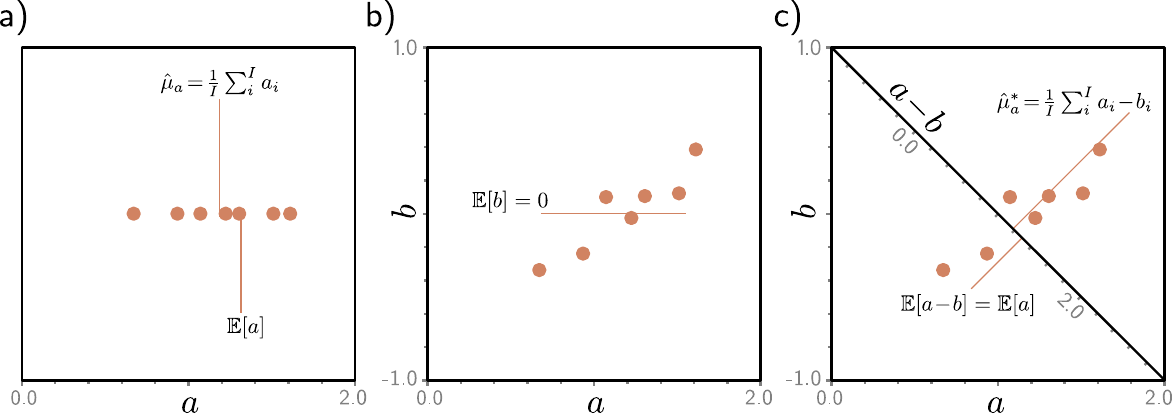
图 19.16 使用控制变量降低估计方差。a) 考虑从少量样本估计
。估计值(样本均值)会因样本数量和方差而变化。b) 现在考虑观察另一个与 协变的变量 ,且 ,方差与 相同。c) 的样本方差远小于 ,但期望值 ,所以我们得到了一个方差更低的估计量。
这引出了一个问题:我们应该如何选择
在实践中,这通常被近似为:
减去这个基线可以消除以下情况引起的方差:所有轨迹的回报
19.5.4 状态相关基线
一个更好的选择是使用依赖于当前状态
在这里,我们补偿的是由于某些状态具有更大的总体回报而引入的方差,而不管我们采取什么动作。
一个明智的选择是基于当前状态的期望未来奖励,即状态值
19.6 Actor-Critic 方法
Actor-Critic 算法是时序差分(TD)策略梯度算法。它们可以在每一步更新策略网络的参数。这与蒙特卡洛 REINFORCE 算法形成对比,后者必须等待一个或多个回合完成后才能更新参数。
在 TD 方法中,我们无法获得未来奖励
这里值
同时,我们通过自举更新参数
预测
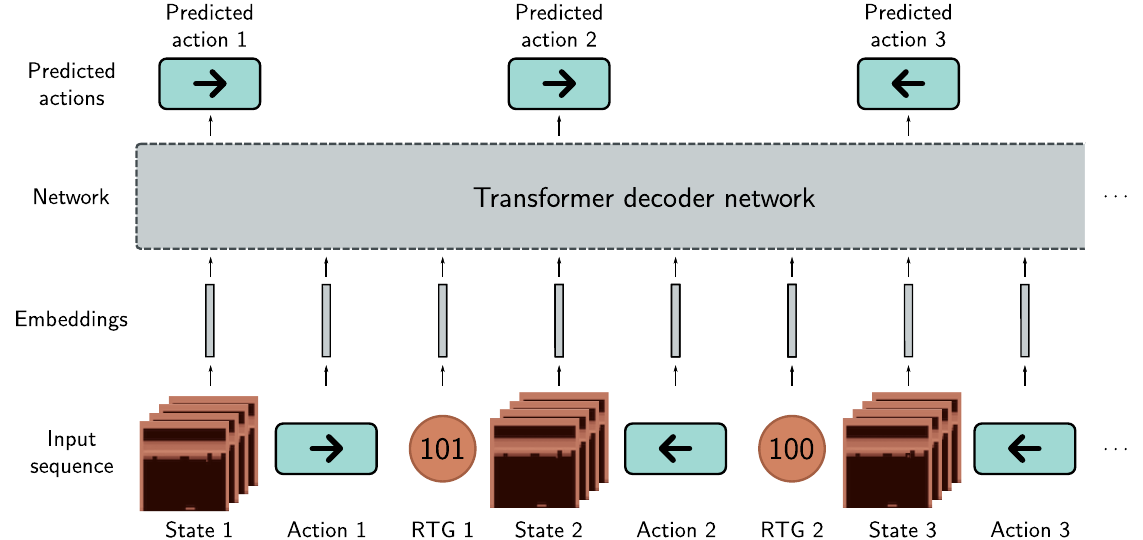
图 19.17 决策 Transformer。决策 Transformer 将离线强化学习视为序列预测任务。输入是状态、动作和剩余回报(回合中剩余的奖励)的序列,每个都映射到固定大小的嵌入。在每个时间步,网络预测下一个动作。在测试时,剩余回报是未知的;实际中使用一个初始估计,然后减去后续观测到的奖励。
19.7 离线强化学习
与环境的交互是强化学习的核心。然而,有些场景下将一个幼稚的智能体送入环境中探索不同动作的效果是不切实际的。这可能是因为环境中的错误行为是危险的(例如,驾驶自动驾驶汽车),或者因为数据收集耗时或成本高昂(例如,进行金融交易)。
然而,在这两种情况下都可以从人类代理中收集历史数据。离线强化学习(offline RL)或批量强化学习(batch RL)旨在通过观察过去的序列
虽然有基于 Q 学习和策略梯度的离线强化学习方法,但这一范式开启了新的可能性。特别是,我们可以将其视为一个序列学习问题,其中目标是在给定状态、奖励和动作的历史的情况下预测下一个动作。决策 Transformer(decision transformer)利用 Transformer 解码器框架(第 12.7 节)来做出这些预测(图 19.17)。
然而,目标是基于未来奖励来预测动作,而这些在标准的
这种方法在训练时很自然,但在推理时会遇到困难,因为我们不知道剩余回报。这可以通过使用期望的总回报在第一步初始化,然后随着奖励的获得递减来解决。例如,在 Atari 游戏中,期望的总回报就是获胜所需的总分。
决策 Transformer 还可以从在线经验中进行微调,因此可以随时间学习。它们的优势在于可以摒弃大部分强化学习机制及其相关的不稳定性,用标准的监督学习替代。Transformer 可以从海量数据中学习并整合长时间上下文中的信息(使时间信用分配问题更加可控)。这代表了强化学习的一个引人入胜的新方向。
19.8 总结
强化学习是一种针对马尔可夫决策过程和类似系统的顺序决策框架。本章回顾了表格方法的强化学习,包括动态规划(环境模型已知的情况)、蒙特卡洛方法(运行多个回合,随后根据获得的奖励更新动作值和策略)以及时序差分方法(在回合进行中更新值)。
深度 Q 学习是一种时序差分方法,使用深度神经网络预测每个状态的动作值。它可以训练智能体在 Atari 2600 游戏上达到接近人类的水平。策略梯度方法直接优化策略而非为动作赋值。它们产生随机策略,这在环境部分可观测时非常重要。更新是有噪声的,已经引入了许多改进来降低其方差。
离线强化学习用于无法与环境交互但必须从历史数据中学习的场景。决策 Transformer 利用深度学习的最新进展来构建状态-动作-奖励序列的模型,并预测能最大化奖励的动作。