
第2章 监督学习
监督学习模型(supervised learning model)定义了一种从一个或多个输入到一个或多个输出的映射。例如,输入可以是一辆二手丰田 Prius 的车龄和里程数,输出则是该车的估价(以美元计)。
模型本质上就是一个数学函数(即一个方程);当输入通过该函数时,它计算出输出,这一过程称为推断(inference)。模型方程还包含参数(parameters)。不同的参数值会改变计算的结果;模型方程描述了输入与输出之间一族可能的关系,而参数则指定了其中某一特定的关系。
当我们说训练(train)或学习(learn)一个模型时,意思是找到能够描述输入与输出之间真实关系的参数。学习算法接收一个输入/输出对的训练集,并调整参数,直到输入能够尽可能准确地预测其对应的输出。如果模型在训练集上表现良好,我们便期望它对于真实输出未知的新输入也能做出好的预测。
本章的目标是更正式地阐述这些思想并引入一些符号记法。然后,我们通过一个简单的例子——用一条直线来描述输入与输出之间的关系——来进行实际操练。这种线性模型既熟悉又易于可视化,同时充分展示了监督学习的所有核心思想。
2.1 监督学习概述
在监督学习中,我们的目标是建立一个模型,接收输入
为了进行预测,我们需要一个模型
当我们根据输入
模型只是一个具有固定形式的数学方程。它表示输入与输出之间一族不同的关系。模型还包含参数
当我们说学习或训练一个模型时,指的是尝试找到使输入能够产生合理输出预测的参数
我们可以将损失视为参数的函数
如果最小化后损失很小,说明我们找到了能够从训练输入
训练完模型后,我们必须评估其性能;我们在单独的测试数据上运行模型,以检验预测精度能否泛化(generalize)到训练期间未见过的样本。如果性能足够好,我们就可以部署该模型。
2.2 线性回归示例
现在让我们用一个简单的例子来具体化这些思想。考虑一个模型
2.2.1 一维线性回归模型
一维线性回归模型(1D linear regression model)将输入
该模型有两个参数
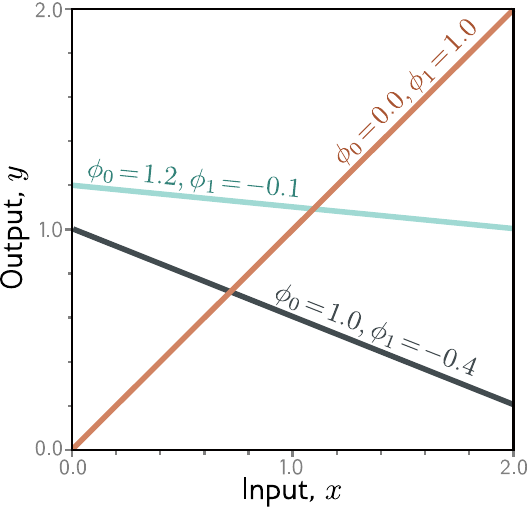
图 2.1 线性回归模型。对于给定的参数选择
,模型基于输入(x 轴)做出对输出(y 轴)的预测。不同的 y 轴截距 和斜率 选择会改变预测(青色、橙色和灰色直线)。线性回归模型(方程 2.4)定义了一族输入/输出关系(直线),参数决定了该族中的具体成员(特定的线)。
2.2.2 损失
对于该模型,训练数据集(图 2.2a)由
不匹配度通过模型预测
由于最佳参数使该表达式最小化,我们称之为最小二乘损失(least-squares loss)。使用平方运算意味着偏差的方向(即直线在数据点的上方还是下方)无关紧要。我们在第 5 章还会讨论这一选择的理论依据。
损失
由于只有两个参数(y 轴截距
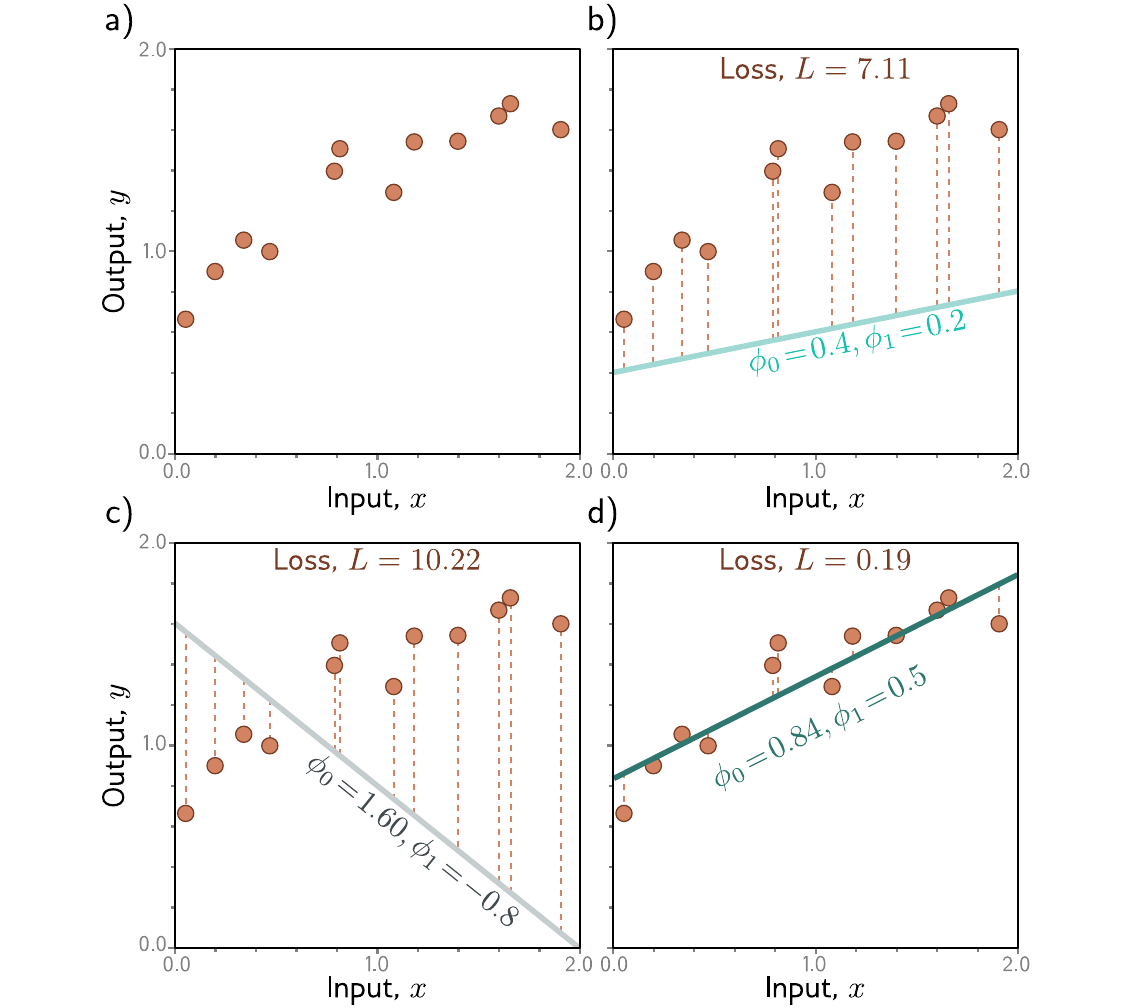
图 2.2 线性回归的训练数据、模型与损失。a) 训练数据(橙色点)由
个输入/输出对 组成。b–d) 每个面板展示了不同参数下的线性回归模型。根据 y 轴截距和斜率参数 的选择,模型误差(橙色虚线)可能较大或较小。损失 是这些误差的平方和。面板 (b) 和 (c) 中定义直线的参数损失分别为 和 ,因为模型拟合很差。面板 (d) 中的损失 较小,因为模型拟合良好;事实上,这是所有可能直线中损失最小的,因此这些参数就是最优参数。
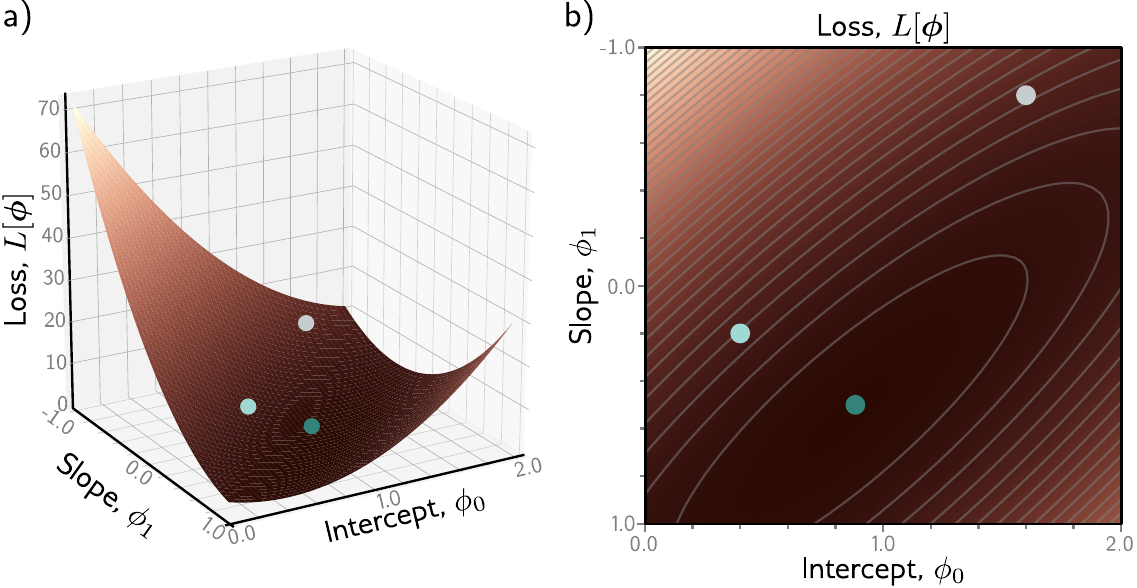
图 2.3 线性回归模型在图 2.2a 数据集上的损失函数。a) 每种参数组合
都对应一个损失值。由此产生的损失函数 可以被可视化为一个曲面。三个圆圈分别对应图 2.2b–d 中的直线。b) 损失也可以可视化为热力图;这里我们从正上方俯视 (a) 中的曲面,灰色椭圆表示等值线。最佳拟合线(图 2.2d)对应损失最小的参数(绿色圆圈)。
2.2.3 训练
寻找使损失最小化的参数的过程称为模型拟合(model fitting)、训练(training)或学习(learning)。基本方法是随机初始化参数,然后通过在损失函数曲面上"下坡行走"来逐步改进,直至到达最低点(图 2.4)。一种实现方式是计算当前位置处曲面的梯度,然后沿最陡下降方向迈出一步。我们反复执行此过程,直到梯度为零,无法再改进为止。
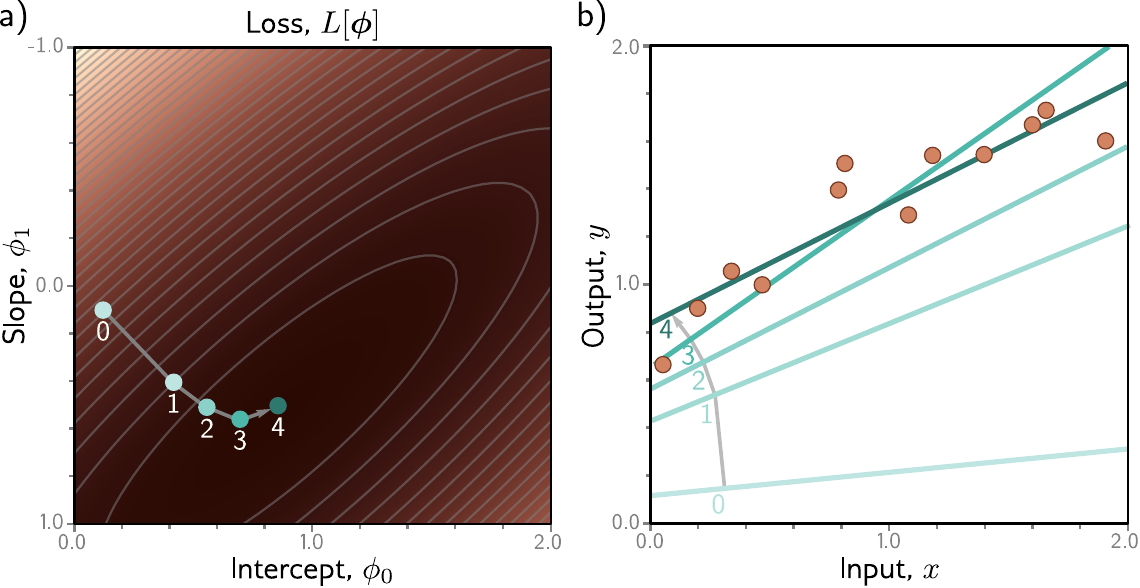
图 2.4 线性回归训练。目标是找到对应最小损失的 y 轴截距和斜率参数。a) 迭代训练算法随机初始化参数,然后通过"下坡行走"逐步改进,直至无法再改进。此处从位置 0 开始,沿下坡方向(垂直于等值线)移动到位置 1。然后重新计算下坡方向并移动到位置 2。最终到达函数的最小值(位置 4)。b) 面板 (a) 中的每个位置 0–4 对应不同的截距和斜率,因而代表不同的直线。随着损失递减,直线对数据的拟合越来越好。
2.2.4 测试
训练完模型后,我们想知道它在真实世界中的表现如何。为此,我们在单独的测试数据集上计算损失。预测精度能否泛化到测试数据取决于训练数据的代表性以及模型的表达能力。一个简单的模型(如直线)可能无法捕捉输入与输出之间的真实关系。这被称为欠拟合(underfitting)。相反,一个表达能力很强的模型可能会描述训练数据中的非典型统计特征,导致对新数据的预测异常。这被称为过拟合(overfitting)。
2.3 总结
监督学习模型是一个函数
第 3–9 章对这些思想进行扩展。首先,我们探讨模型本身:一维线性回归有一个明显的缺陷——它只能将输入与输出之间的关系描述为一条直线。浅层神经网络(第 3 章)仅比线性回归稍复杂,但能描述更大范围的输入/输出关系族。深度神经网络(第 4 章)同样具有强大的表达能力,但参数更少,且在实践中表现更好。
第 5 章研究适用于不同任务的损失函数,并揭示最小二乘损失背后的理论基础。第 6 章和第 7 章讨论训练过程。第 8 章讨论如何度量模型性能。第 9 章考察正则化(regularization)技术,旨在提高模型性能。