Skip to content

第18章 扩散模型

第 15 章介绍了生成对抗模型,它可以产生看起来合理的样本但不定义数据上的概率分布。第 16 章讨论了归一化流,它确实定义了概率分布但必须对网络施加架构约束;每一层必须是可逆的,且其雅可比行列式必须易于计算。第 17 章介绍了变分自编码器,它也有坚实的概率基础但似然的计算是不可处理的,必须用下界来近似。

本章介绍扩散模型(diffusion models)。与归一化流类似,它们是定义从潜变量到观测数据的非线性映射的概率模型,其中两者具有相同的维度。与变分自编码器类似,它们使用基于编码器映射到潜变量的下界来近似数据似然。然而,在扩散模型中,这个编码器是预设的;目标是学习一个解码器,它是编码过程的逆过程,可以用来产生样本。扩散模型易于训练,能够产生非常高质量的样本,其真实感超过 GAN 产生的样本。读者在阅读本章前应熟悉变分自编码器(第 17 章)。

18.1 概述

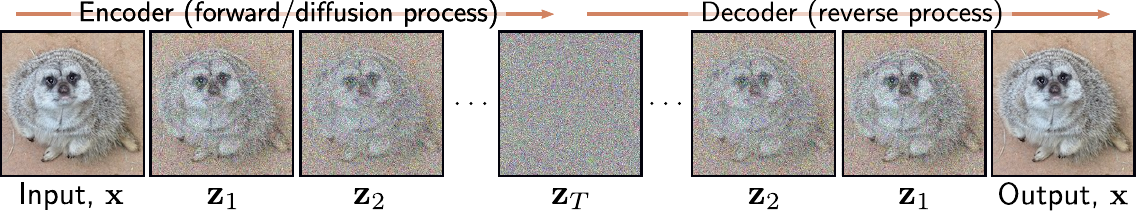
扩散模型由一个编码器(encoder)和一个解码器(decoder)组成。编码器接收一个数据样本 x,将其映射到一系列中间潜变量 z1zT。解码器反转这个过程;它从 zT 开始,映射回 zT1,,z1,直到最终(重新)创建一个数据点 x。在编码器和解码器中,映射都是随机的而非确定性的。

编码器是预先设定的;它逐渐将输入与白噪声样本混合(图 18.1)。经过足够多的步骤,条件分布 q(zT|x) 和边缘分布 q(zT) 都变成标准正态分布。由于这个过程是预设的,所有学习到的参数都在解码器中。

在解码器中,一系列网络被训练来学习每对相邻潜变量 ztzt1 之间的反向映射。损失函数鼓励每个网络反转相应的编码器步骤。结果是噪声从表示中被逐渐去除,直到剩下一个看起来真实的数据样本。为了生成新的数据样本 x,我们从 q(zT) 中抽取一个样本并通过解码器传递。

图 18.1

图 18.1 扩散模型。编码器(前向或扩散过程)将输入 x 映射到一系列潜变量 z1zT。这个过程是预设的,逐渐将数据与噪声混合直到只剩噪声。解码器(逆过程)是学习的,将数据通过潜变量传回,在每个阶段去除噪声。训练后,通过采样噪声向量 zT 并通过解码器传递来生成新样本。

在第 18.2 节中,我们详细考虑编码器。它的性质虽不显而易见但对学习算法至关重要。在第 18.3 节中,我们讨论解码器。第 18.4 节推导训练算法,第 18.5 节将其重新表述为更实用的形式。第 18.6 节讨论实现细节,包括如何使生成以文本提示为条件。

18.2 编码器(前向过程)

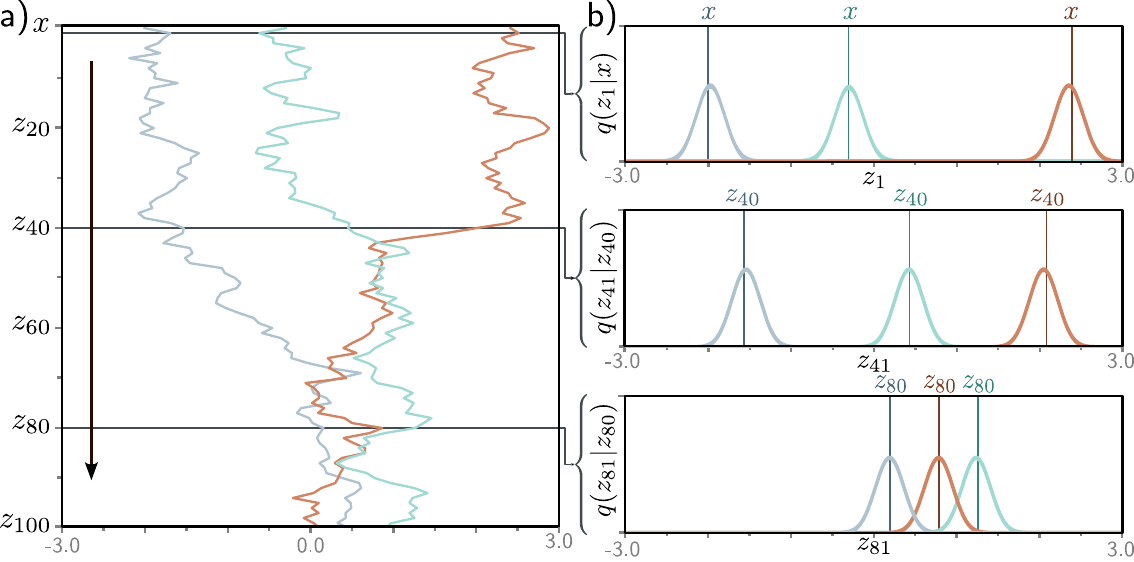
扩散(diffusion)或前向过程(forward process)(图 18.2)将数据样本 x 映射到一系列与 x 相同大小的中间变量 z1,z2,,zT,按照以下规则:

(18.1)z1=1β1x+β1ϵ1zt=1βtzt1+βtϵtt2,,T,

其中 ϵt 是从标准正态分布中抽取的噪声。第一项衰减到目前为止的数据加上任何已添加的噪声,第二项添加更多噪声。超参数 βt[0,1] 决定噪声混合的速度,统称为噪声调度(noise schedule)。前向过程也可以等价地写为:

(18.2)q(z1|x)=Normz1[1β1x,β1I]q(zt|zt1)=Normzt[1βtzt1,βtI]t{2,,T}.

这是一个马尔可夫链(Markov chain),因为 zt 的概率完全由紧邻的前一个变量 zt1 的值决定。经过足够多的步骤 T,原始数据的所有痕迹都被去除,q(zT|x)=q(zT) 变为标准正态分布。

给定输入 x 时,所有潜变量 z1,z2,,zT 的联合分布是:

(18.3)q(z1T|x)=q(z1|x)t=2Tq(zt|zt1).

图 18.2

图 18.2 前向过程。a) 考虑一维数据 x,有 T=100 个潜变量 z1,,z100β=0.03。三个 x 值(灰色、青色和橙色)被初始化(顶行),传播经过 z1,,z100。在每一步,变量通过将其值衰减 1β 并添加均值为零、方差为 β 的噪声来更新(等式 18.1)。因此,三个样本带噪声地向零移动。b) 条件概率 Pr(z1|x)Pr(zt|zt1) 是正态分布,均值略微比当前点更接近零,方差固定为 βt(等式 18.2)。

18.2.1 扩散核 q(zt|x)

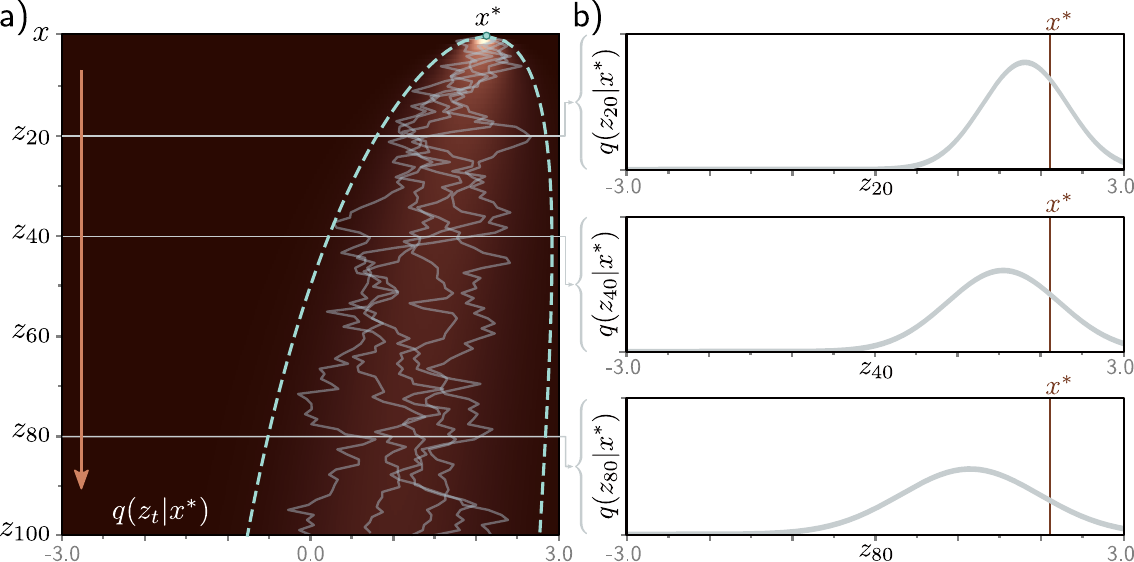
为了训练解码器反转这个过程,我们需要在同一数据样本 x 的时间 t 处使用多个样本 zt。然而,当 t 很大时,使用等式 18.1 按顺序生成这些样本很耗时。幸运的是,存在 q(zt|x) 的封闭形式表达式,允许我们在给定初始数据点 x 时直接抽取样本 zt,而无需计算中间变量 z1zt1。这被称为扩散核(diffusion kernel)(图 18.3)。

为了推导 q(zt|x) 的表达式,考虑前向过程的前两步:

(18.4)z1=1β1x+β1ϵ1z2=1β2z1+β2ϵ2.

将第一个等式代入第二个,得到:

(18.5)z2=1β2(1β1x+β1ϵ1)+β2ϵ2=(1β2)(1β1)x+1β2(1β2)(1β1)ϵ1+β2ϵ2.

最后两项是均值为零的独立正态分布的样本,方差分别为 1β2(1β2)(1β1)β2。这个和的均值为零,方差是各分量方差之和,因此:

(18.6)z2=(1β2)(1β1)x+1(1β2)(1β1)ϵ,

其中 ϵ 也是标准正态分布的样本。

如果我们继续将这个等式代入 z3 的表达式,依此类推,可以证明:

(18.7)zt=αtx+1αtϵ,

其中 αt=s=1t(1βs)。我们可以等价地将其写成概率形式:

(18.8)q(zt|x)=Normzt[αtx,(1αt)I].

对于任何起始数据点 x,变量 zt 是具有已知均值和方差的正态分布。因此,如果我们不关心通过中间变量 z1zt1 的演化历史,就可以很容易地从 q(zt|x) 生成样本。

图 18.3

图 18.3 扩散核。a) 点 x=2.0 通过等式 18.1 传播经过潜变量(五条路径以灰色显示)。扩散核 q(zt|x) 是在给定从 x 出发时变量 zt 上的概率分布。它可以以封闭形式计算,是一个均值趋向零且方差随 t 增大而增大的正态分布。热力图显示了每个变量的 q(zt|x)。青色线显示均值偏离 ±2 个标准差。b) 明确显示了 t=20,40,80 时的扩散核 q(zt|x)。实际上,扩散核允许我们在给定 x 时采样对应于任意时间 t 的潜变量 zt,而无需计算中间变量 z1,,zt1。当 t 变得很大时,扩散核趋近于标准正态分布。

18.2.2 边缘分布 q(zt)

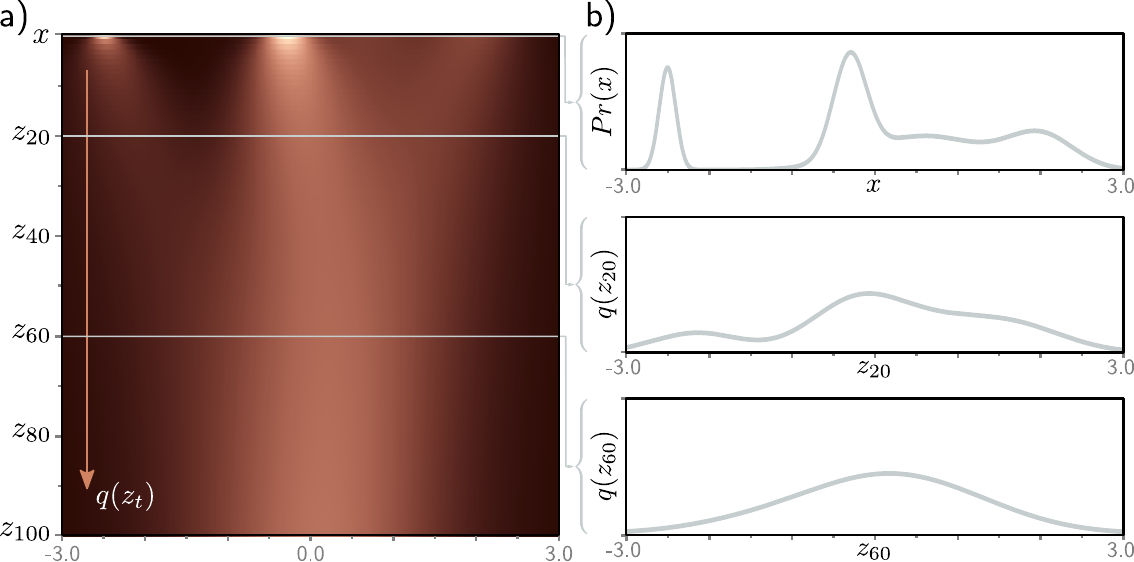
边缘分布 q(zt) 是在给定可能的起始点 x 的分布和每个起始点的可能扩散路径下,观察到 zt 值的概率(图 18.4)。它可以通过考虑联合分布 q(x,z1t) 并对除 zt 以外的所有变量进行边缘化来计算:

(18.9)q(zt)=q(z1t,x)dz1t1dx=q(z1t|x)Pr(x)dz1t1dx,

然而,由于我们有一个"跳过"中间变量的扩散核 q(zt|x) 的表达式,可以等价地写为:

(18.10)q(zt)=q(zt|x)Pr(x)dx.

因此,如果我们反复从数据分布 Pr(x) 采样并在每个样本上叠加扩散核 q(zt|x),得到的就是边缘分布 q(zt)(图 18.4)。然而,边缘分布无法写成封闭形式,因为我们不知道原始数据分布 Pr(x)

图 18.4

图 18.4 边缘分布。a) 给定初始密度 Pr(x)(顶行),扩散过程在通过潜变量 zt 时逐渐模糊分布并将其移向标准正态分布。每一行热力图代表一个边缘分布 q(zt)。b) 顶部图显示初始分布 Pr(x)。另外两个图分别显示边缘分布 q(z20)q(z60)

18.2.3 条件分布 q(zt1|zt)

我们将条件概率 q(zt|zt1) 定义为混合过程(等式 18.2)。为了反转这个过程,我们应用贝叶斯法则:

(18.11)q(zt1|zt)=q(zt|zt1)q(zt1)q(zt).

这是不可处理的,因为我们无法计算边缘分布 q(zt1)

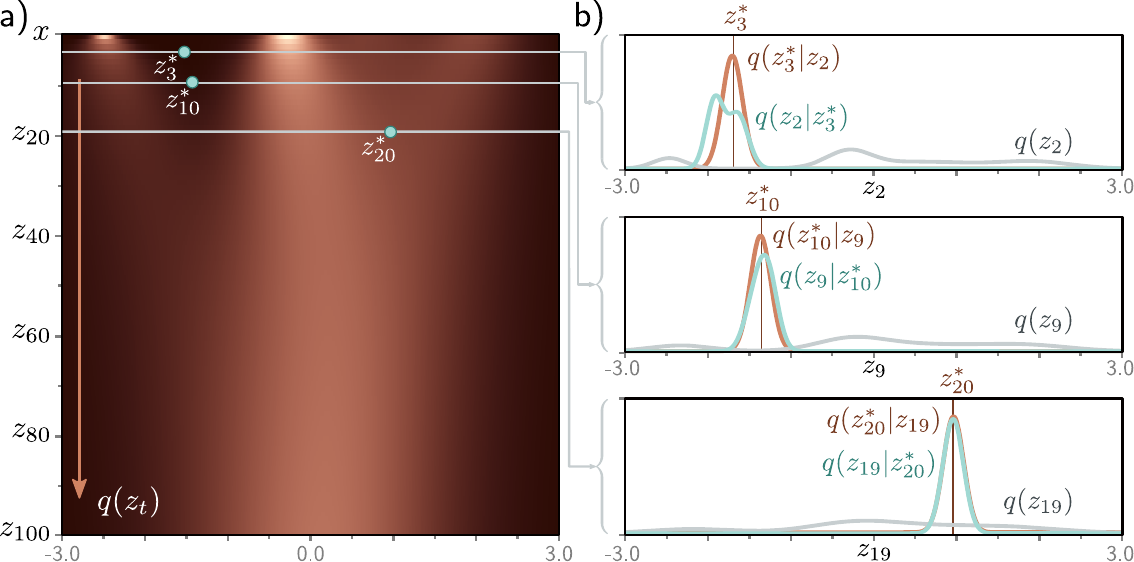
对于简单的一维示例,可以数值地评估 q(zt1|zt)(图 18.5)。一般来说,它的形式是复杂的,但在许多情况下,它可以被正态分布很好地近似。这很重要,因为当我们构建解码器时,将使用正态分布来近似逆过程。

图 18.5

图 18.5 条件分布 q(zt1|zt)。a) 边缘密度 q(zt) 中高亮三个点 zt。b) 概率 q(zt1|zt)(青色曲线)通过贝叶斯法则计算,与 q(zt|zt1)q(zt1) 成正比。一般来说,它不是正态分布(顶部图),但通常正态分布是一个好的近似(底部两个图)。

18.2.4 条件扩散分布 q(zt1|zt,x)

还有与编码器相关的最后一个分布需要考虑。我们注意到无法求得条件分布 q(zt1|zt),因为我们不知道边缘分布 q(zt1)。然而,如果我们知道起始变量 x,那么我们就知道前一时刻的分布 q(zt1|x)。这就是扩散核(图 18.3),它是正态分布的。

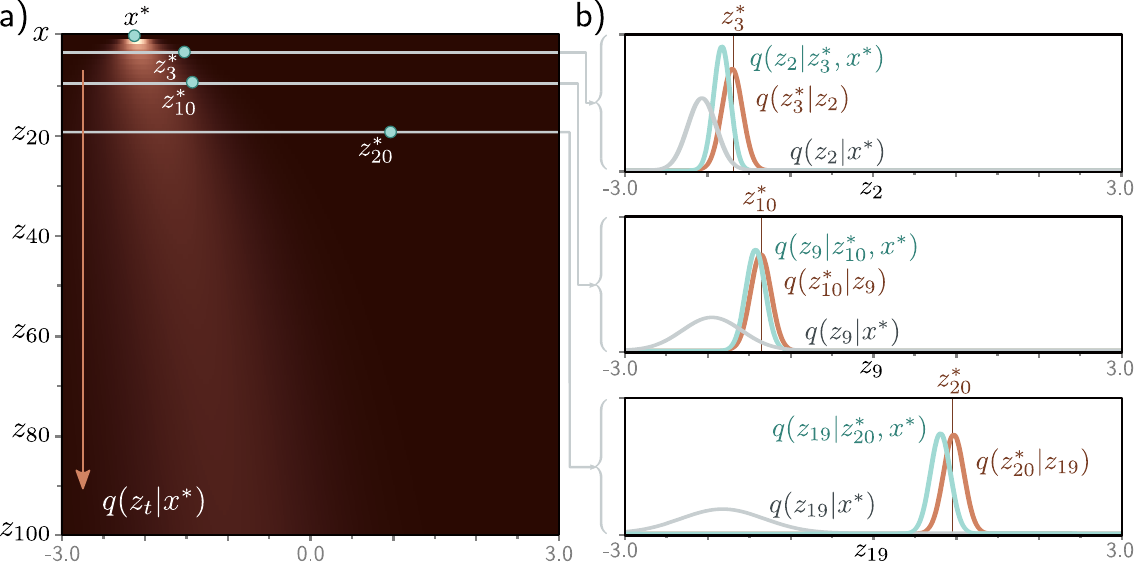
因此,可以以封闭形式计算条件扩散分布 q(zt1|zt,x)(图 18.6)。这是当我们知道当前潜变量 zt 和训练数据样本 x 时,zt1 上的分布。为了计算 q(zt1|zt,x) 的表达式,我们从贝叶斯法则出发:

(18.12)q(zt1|zt,x)=q(zt|zt1,x)q(zt1|x)q(zt|x)Normzt[1βtzt1,βtI]Normzt1[αt1x,(1αt1)I]

其中第一行和第二行之间,我们利用了 q(zt|zt1,x)=q(zt|zt1) 这一事实,因为扩散过程是马尔可夫的,关于 zt 的所有信息都包含在 zt1 中。利用高斯变量替换恒等式:

(18.13)Normv[Aw,B]Normw[(ATB1A)1ATB1v,(ATB1A)1],

以及两个高斯乘积的恒等式:

(18.14)Normw[a,A]Normw[b,B]Normw[(A1+B1)1(A1a+B1b),(A1+B1)1],

得到:

(18.15)q(zt1|zt,x)=Normzt1[(1αt1)1αt1βtzt+αt1βt1αtx,βt(1αt1)1αtI].

图 18.6

图 18.6 条件扩散分布 q(zt1|zt,x)。a) 对于 x=2.1 的扩散核 q(zt|x),高亮三个点 zt。b) 概率 q(zt1|zt,x) 通过贝叶斯法则计算,与 q(zt|zt1)q(zt1|x) 成正比。这正态分布的,可以以封闭形式计算。

18.3 解码器模型(逆过程)

当我们学习扩散模型时,我们学习一系列从潜变量 zTzT1、从 zT1zT2 的概率映射,依此类推,直到到达数据 x。扩散过程的真实逆分布 q(zt1|zt) 是复杂的多模态分布(图 18.5),取决于数据分布 Pr(x)。我们将它们近似为正态分布:

(18.16)Pr(zT)=NormzT[0,I]Pr(zt1|zt,ϕt)=Normzt1[ft[zt,ϕt],σt2I]Pr(x|z1,ϕ1)=Normx[f1[z1,ϕ1],σ12I],

其中 ft[zt,ϕt] 是一个神经网络,计算从 zt 到前一个潜变量 zt1 估计映射中正态分布的均值。项 {σt2} 是预设的。如果扩散过程中超参数 βt 接近零(且时间步 T 很大),那么这个正态近似将是合理的。

我们使用祖先采样从 Pr(x) 生成新样本。首先从 Pr(zT) 中抽取 zT。然后从 Pr(zT1|zT,ϕT) 中采样 zT1,从 Pr(zT2|zT1,ϕT1) 中采样 zT2,依此类推直到最终从 Pr(x|z1,ϕ1) 生成 x

18.4 训练

观测变量 x 和潜变量 {zt} 的联合分布是:

(18.17)Pr(x,z1T|ϕ1T)=Pr(x|z1,ϕ1)t=2TPr(zt1|zt,ϕt)Pr(zT).

观测数据 Pr(x|ϕ1T) 的似然通过对潜变量边缘化获得:

(18.18)Pr(x|ϕ1T)=Pr(x,z1T|ϕ1T)dz1T.

为了训练模型,我们最大化训练数据 {xi} 关于参数 ϕ 的对数似然:

(18.19)ϕ^1T=argmaxϕ1T[i=1Ilog[Pr(xi|ϕ1T)]].

我们无法直接最大化,因为等式 18.18 中的边缘化是不可处理的。因此,我们使用 Jensen 不等式来定义似然的下界,并像对 VAE 所做的那样(见第 17.3.1 节),关于参数 ϕ1T 优化该下界。

18.4.1 证据下界(ELBO)

为了推导下界,我们将对数似然乘以并除以编码器分布 q(z1T|x),并应用 Jensen 不等式(见第 17.3.2 节):

(18.20)log[Pr(x|ϕ1T)]=log[Pr(x,z1T|ϕ1T)dz1T]=log[q(z1T|x)Pr(x,z1T|ϕ1T)q(z1T|x)dz1T]q(z1T|x)log[Pr(x,z1T|ϕ1T)q(z1T|x)]dz1T.

这给出了证据下界(ELBO):

(18.21)ELBO[ϕ1T]=q(z1T|x)log[Pr(x,z1T|ϕ1T)q(z1T|x)]dz1T.

在 VAE 中,编码器 q(z|x) 近似潜变量上的后验分布以使下界紧致,解码器最大化这个下界(图 17.10)。在扩散模型中,解码器必须做所有工作,因为编码器没有参数。它通过 (i) 改变自身参数使静态编码器确实近似后验 Pr(z1T|x,ϕ1T) 以及 (ii) 关于自身参数优化该下界来使下界更紧致。

18.4.2 化简 ELBO

我们现在将 ELBO 中的对数项操纵为最终优化的形式。首先分别代入等式 18.17 和 18.3 中分子和分母的定义:

(18.22)log[Pr(x,z1T|ϕ1T)q(z1T|x)]=log[Pr(x|z1,ϕ1)t=2TPr(zt1|zt,ϕt)Pr(zT)q(z1|x)t=2Tq(zt|zt1)]

经过展开分母并利用比值 q(zt1|x)/q(zt|x) 的消去,化简后的 ELBO 为:

(18.25)ELBO[ϕ1T]=q(z1T|x)log[Pr(x,z1T|ϕ1T)q(z1T|x)]dz1Tq(z1T|x)(log[Pr(x|z1,ϕ1)]+t=2Tlog[Pr(zt1|zt,ϕt)q(zt1|zt,x)])dz1T=Eq(z1|x)[log[Pr(x|z1,ϕ1)]]t=2TEq(zt,t+1|x)[DKL[q(zt1|zt,x)Pr(zt1|zt,ϕt)]],

其中我们对 q(z1T|x) 中的无关变量进行了边缘化,并使用了 KL 散度的定义。

18.4.3 分析 ELBO

ELBO 中的第一个概率项在等式 18.16 中定义:

(18.26)Pr(x|z1,ϕ1)=Normx[f1[z1,ϕ1],σ12I],

等价于 VAE 中的重构项。如果模型预测与观测数据匹配,ELBO 会更大。与 VAE 一样,我们使用蒙特卡罗估计来近似该量的对数的期望(见等式 17.22-17.23),用 q(z1|x) 的样本来估计。

ELBO 中的 KL 散度项衡量 Pr(zt1|zt,ϕt)q(zt1|zt,x) 之间的距离,它们分别在等式 18.16 和 18.15 中定义:

(18.27)Pr(zt1|zt,ϕt)=Normzt1[ft[zt,ϕt],σt2I]q(zt1|zt,x)=Normzt1[(1αt1)1αt1βtzt+αt1βt1αtx,βt(1αt1)1αtI].

两个正态分布之间的 KL 散度有封闭形式表达式。而且,该表达式中的许多项不依赖于 ϕ,因此简化为均值之间的差的平方加上一个常数 C
(18.28)DKL[q(zt1|zt,x)Pr(zt1|zt,ϕt)]=12σt2(1αt1)1αt1βtzt+αt1βt1αtxft[zt,ϕt]2+C.

图 18.7

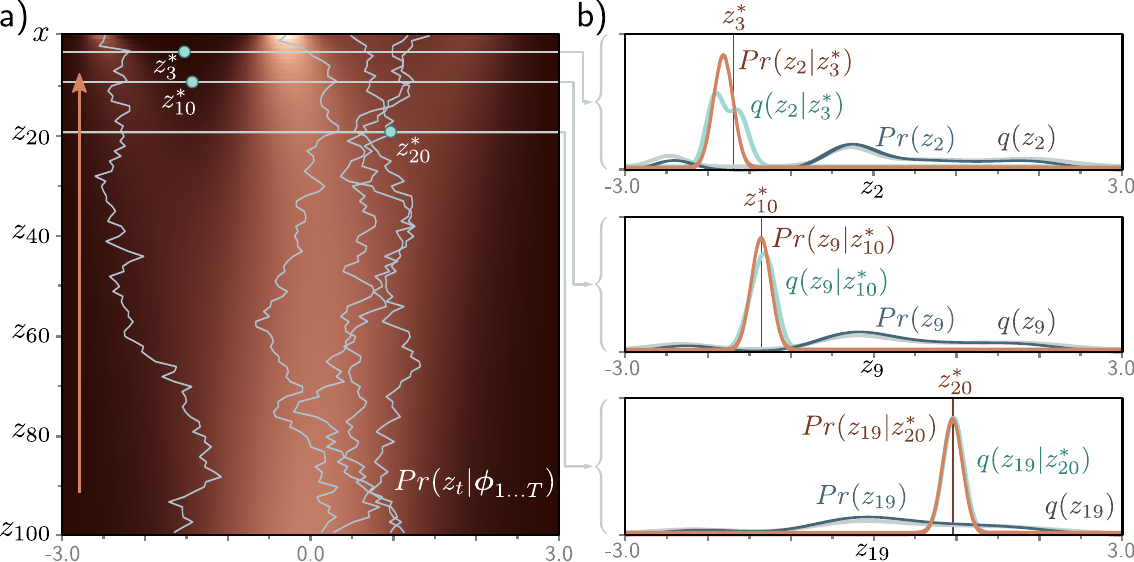
图 18.7 拟合的模型。a) 可以通过从标准正态分布 Pr(zT)(底行)采样生成单个样本,然后从 Pr(zT1|zT)=NormzT1[fT[zT,ϕT],σT2I] 采样 zT1,依此类推直到到达 x(五条路径)。估计的边缘密度(热力图)与图 18.4 中的真实边缘密度相似。b) 估计的分布 Pr(zt1|zt)(棕色曲线)是图 18.5 中扩散模型真实后验 q(zt1|zt)(青色曲线)的合理近似。

18.4.4 扩散损失函数

为了拟合模型,我们关于参数 ϕ1T 最大化 ELBO。我们乘以负一并用样本近似期望,将其重新表述为最小化,得到损失函数:

(18.29)L[ϕ1T]=i=1I(log[Normxi[f1[zi1,ϕ1],σ12I]]+t=2T12σt21αt11αt1βtzit+αt1βt1αtxi目标:q(zt1|zt,x) 的均值ft[zit,ϕt]预测 zt12),

其中 xi 是第 i 个数据点,zit 是扩散步骤 t 处的关联潜变量。

18.4.5 训练过程

这个损失函数可以用来为每个扩散时间步训练一个网络。它最小化隐变量在前一时间步的估计 ft[zt,ϕt] 与给定去噪后真实数据 x 时最可能值之间的差异。
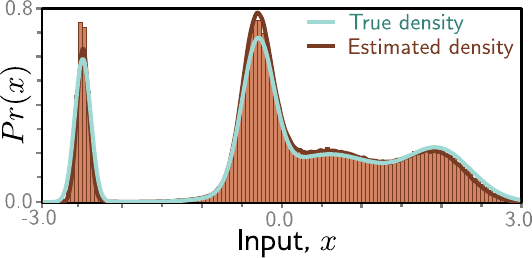
图 18.8

图 18.8 拟合模型的结果。青色和棕色曲线分别是原始和估计密度,分别对应图 18.4 和 18.7 的顶行。垂直条是从模型中分箱的样本,通过从 Pr(zT) 采样并传播回 zT1,zT2, 生成,如图 18.7 中的五条路径所示。

18.5 损失函数的重参数化

虽然等式 18.29 中的损失函数可以使用,但已发现扩散模型在不同的参数化下表现更好;损失函数被修改为让模型预测与原始数据样本混合以产生当前变量的噪声。第 18.5.1 节讨论目标(等式 18.29 第二行的前两项)的重参数化,第 18.5.2 节讨论网络(等式 18.29 第二行的最后一项)的重参数化。

18.5.1 目标的重参数化

原始扩散更新由下式给出:

(18.30)zt=αtx+1αtϵ.

由此得出等式 18.28 中的数据项 x 可以表示为扩散后的图像减去添加的噪声:

(18.31)x=1αtzt1αtαtϵ.

将其代入等式 18.29 的目标项并化简,得到:

(18.33)(1αt1)1αt1βtzt+αt1βt1αtx=11βtztβt1αt1βtϵ,

将其代回损失函数(等式 18.29),得到:

(18.34)L[ϕ1T]=i=1I(log[Normxi[f1[zi1,ϕ1],σ12I]]+t=2T12σt2(11βtzitβt1αt1βtϵit)ft[zit,ϕt]2).

18.5.2 网络的重参数化

现在我们用一个预测与 x 混合以创建 zt 的噪声 ϵ 的新模型 ϵ^=gt[zt,ϕt] 替换模型 z^t1=ft[zt,ϕt]

(18.35)ft[zt,ϕt]=11βtztβt1αt1βtgt[zt,ϕt].

将新模型代入等式 18.34,经过化简,忽略各项的缩放因子(它们在每个时间步可能不同),得到更简洁的表述:

(18.40)L[ϕ1T]=i=1It=1Tgt[zit,ϕt]ϵit2=i=1It=1Tgt[αtxi+1αtϵit,ϕt]ϵit2,

其中第二行使用扩散核(等式 18.30)重写了 zt

18.6 实现

这导出了直观的训练模型(算法 18.1)和采样(算法 18.2)算法。训练算法的优点是 (i) 实现简单,(ii) 自然地增强数据集;我们可以在每个时间步以不同的噪声实例化 ϵ 重复使用每个原始数据点 xi 任意多次。采样算法的缺点是它需要串行处理多个神经网络 gt[zt,ϕt],因此耗时较长。

算法 18.1:扩散模型训练

  • 输入:训练数据 x
  • 输出:模型参数 ϕt
  • 重复:
    • 对批次中的每个训练样本 i
      • 采样随机时间步 tUniform[1,T]
      • 采样噪声 ϵNorm[0,I]
      • 计算个体损失 i=gt[αtxi+1αtϵ,ϕt]ϵ2
    • 累积批次损失并进行梯度步
  • 直到收敛

算法 18.2:采样

  • 输入:模型 gt[,ϕt]
  • 输出:样本 x
  • zTNormz[0,I](采样最后的潜变量)
  • t=T2
    • z^t1=11βtztβt1αt1βtgt[zt,ϕt](预测前一个潜变量)
    • ϵNormϵ[0,I](抽取新的噪声向量)
    • zt1=z^t1+σtϵ(向前一个潜变量添加噪声)
  • x=11β1z1β11α11β1g1[z1,ϕ1](从 z1 生成样本,不加噪声)

18.6.1 应用于图像

扩散模型在建模图像数据方面非常成功。这里,我们需要构建能够接受一个有噪图像并预测在每一步添加了什么噪声的模型。对于这种图像到图像映射,U-Net(图 11.10)是显而易见的架构选择。然而,可能有非常多的扩散步骤,训练和存储多个 U-Net 效率低下。解决方案是训练一个单一的 U-Net,它还接收一个代表时间步的预设向量作为输入(图 18.9)。实际上,这个向量被调整大小以匹配 U-Net 每个阶段的通道数,用于偏移和/或缩放每个空间位置的表示。

需要大量时间步,因为当超参数 βt 接近零时,条件概率 q(zt1|zt) 更接近正态分布,与解码器分布 Pr(zt1|zt,ϕt) 的形式匹配。然而,这使得采样变慢。我们可能需要运行 T=1000 步的 U-Net 模型才能生成好的图像。
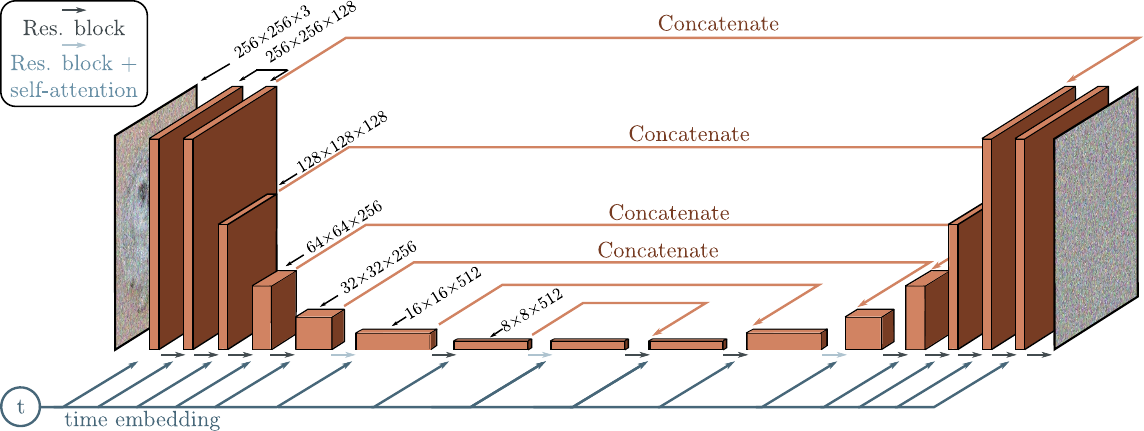
图 18.9

图 18.9 用于图像的扩散模型中的 U-Net。网络旨在预测添加到图像中的噪声。它由一个降低尺度并增加通道数的编码器和一个增加尺度并减少通道数的解码器组成。编码器表示与解码器中的对应部分连接。相邻表示之间的连接由残差块和周期性全局自注意力组成,其中每个空间位置与其他每个空间位置交互。所有时间步使用单一网络,通过将正弦时间嵌入(图 12.5)通过一个浅层神经网络传递并将结果添加到 U-Net 每个阶段每个空间位置的通道上。

18.6.2 提高生成速度

损失函数(等式 18.40)要求扩散核具有形式 q(zt|x)=Norm[αtx,1αtI]。对于任何与此关系兼容的前向过程,相同的损失函数都有效,且存在一族这样的兼容过程。这些过程都通过相同的损失函数来优化,但对前向过程有不同的规则以及在逆过程中如何使用估计的噪声 g[zt,ϕt]zt 预测 zt1 的不同规则(图 18.10)。

其中包括去噪扩散隐式模型(denoising diffusion implicit models),它在从 xz1 的第一步之后不再是随机的,以及加速采样(accelerated sampling)模型,其前向过程仅在时间步的子序列上定义。这允许一个跳过时间步的逆过程,从而使采样更加高效;用 50 个时间步就可以创建好的样本,当前向过程不再是随机时。这比以前快得多,但仍比大多数其他生成模型慢。
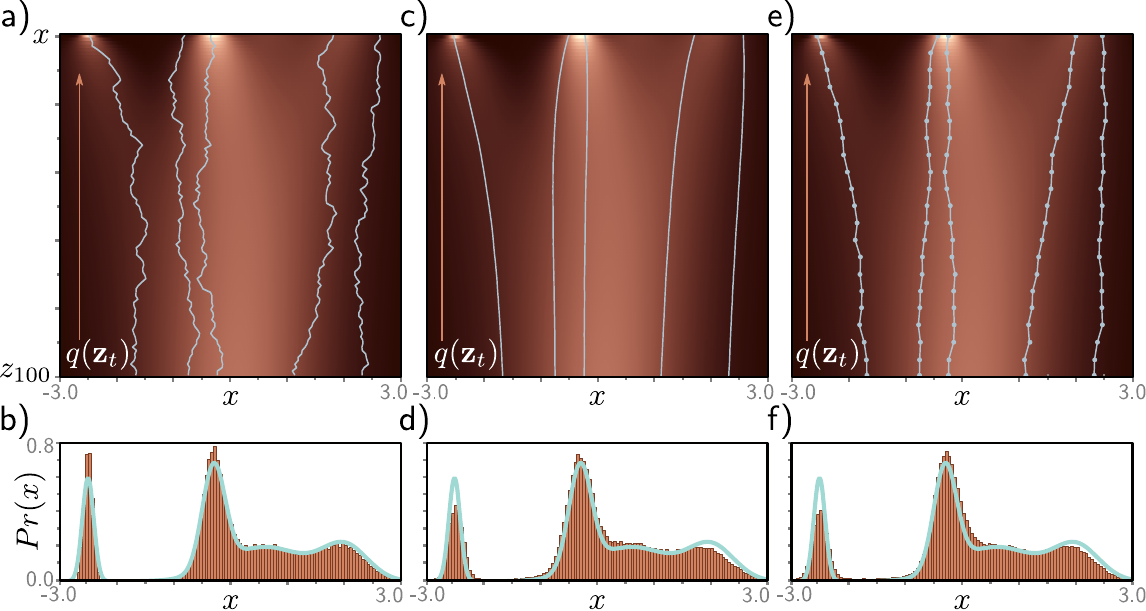
图 18.10

图 18.10 与同一模型兼容的不同扩散过程。a) 重参数化模型的五个采样轨迹。b) 重参数化模型生成的样本直方图。c-d) 去噪扩散隐式模型(DDIM),它是确定性的,在每一步不添加噪声。e-f) 加速扩散模型,跳过推理步骤以提高采样速度。

18.6.3 条件生成

如果数据具有关联标签 c,可以利用它们来控制生成。有时这可以改善 GAN 中的生成结果,我们可能期望扩散模型也是如此;如果你知道图像包含什么,去噪更容易。扩散模型中条件合成的一种方法是分类器引导(classifier guidance)。这修改了从 ztzt1 的去噪更新以考虑类别信息 c。实际上,这意味着在算法 18.2 的最终更新步骤中添加一个额外项:

(18.41)zt1=z^t1+σt2log[Pr(c|zt)]zt+σtϵ.

新项取决于基于潜变量 zt 的分类器 Pr(c|zt) 的梯度。像 U-Net 一样,它通常在所有时间步之间共享并以时间步作为输入。从 ztzt1 的更新现在使类别 c 更可能。

无分类器引导(classifier-free guidance)避免了学习单独的分类器 Pr(c|zt),而是将类别信息直接整合到主模型 gt[zt,ϕt,c] 中。实际上,这通常采用将基于 c 的嵌入以与添加时间步类似的方式添加到 U-Net 各层的形式(见图 18.9)。该模型在训练期间通过随机丢弃类别信息来联合训练条件和无条件目标。因此,它可以在测试时生成无条件或条件数据样本,或者两者的任意加权组合。这带来了一个令人惊讶的优势;如果条件信息被过度加权,模型倾向于产生非常高质量但略为刻板的样本。这在某种程度上类似于 GAN 中使用截断的做法(图 15.10)。
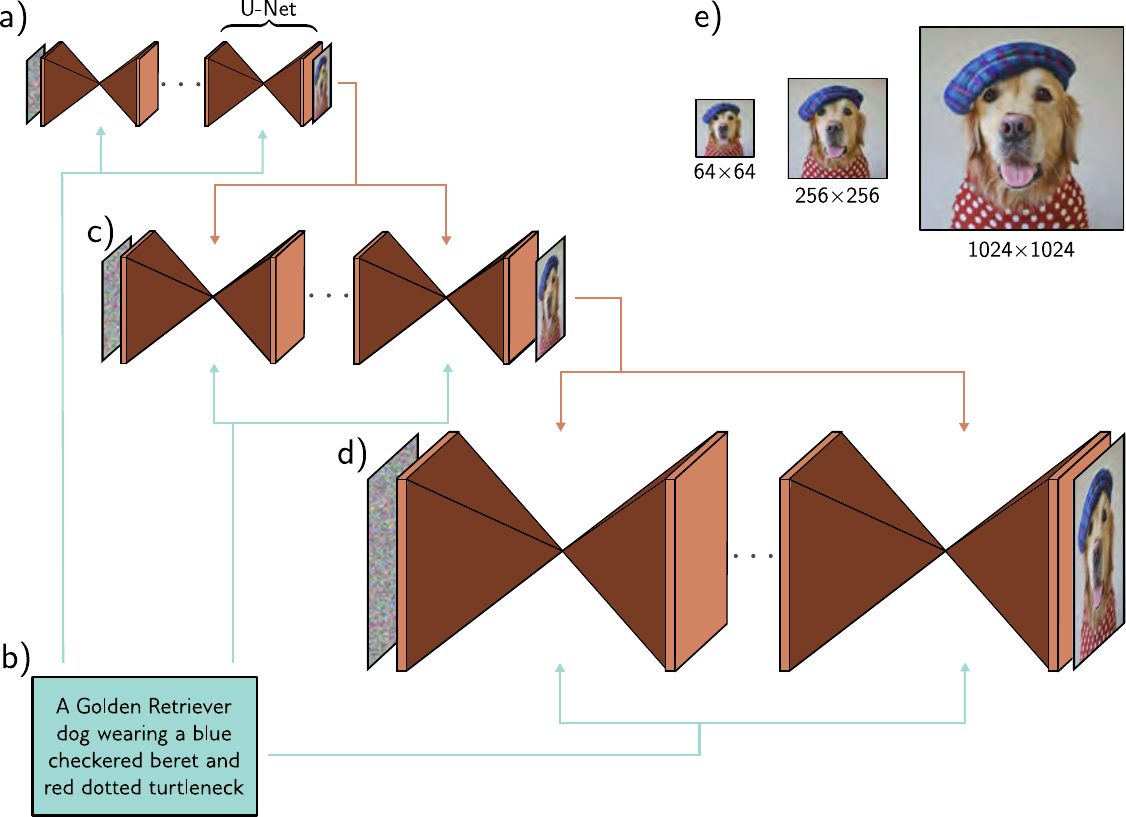
图 18.11

图 18.11 基于文本提示的级联条件生成。a) 由一系列 U-Net 组成的扩散模型用于生成 64×64 图像。b) 该生成以语言模型计算的句子嵌入为条件。c) 更高分辨率的 256×256 图像在较小图像文本编码上生成和调节。d) 重复此过程以创建 1024×1024 图像。e) 最终图像序列。改编自 Saharia et al. (2022b)。

18.6.4 提高生成质量

与其他生成模型一样,最高质量的结果来自对基本模型应用一系列技巧和扩展。首先,发现同时估计逆过程的方差 σt2 和均值(即图 18.7 中棕色正态分布的宽度)也有帮助。这在用更少步骤采样时尤其改善结果。其次,可以修改前向过程中的噪声调度使得 βt 在每一步变化,这也可以改善结果。

第三,为了生成高分辨率图像,使用扩散模型的级联。首先创建一个低分辨率图像(可能由类别信息引导)。后续的扩散模型生成逐步更高分辨率的图像。它们通过将低分辨率图像调整大小并附加到组成 U-Net 的各层以及任何其他类别信息来以低分辨率图像为条件(图 18.11)。

结合所有这些技术,可以生成非常高质量的图像。图 18.12 展示了从以 ImageNet 类别为条件的模型生成的图像样本。该模型能够学习生成如此多样化的类别,尤其令人印象深刻。图 18.13 展示了从训练为以语言模型编码的文本标题为条件的模型生成的图像,这些编码以与时间步相同的方式插入模型(图 18.9 和 18.11)。这产生了与标题一致的非常逼真的图像。由于扩散模型本质上是随机的,可以生成以同一标题为条件的多个不同图像。
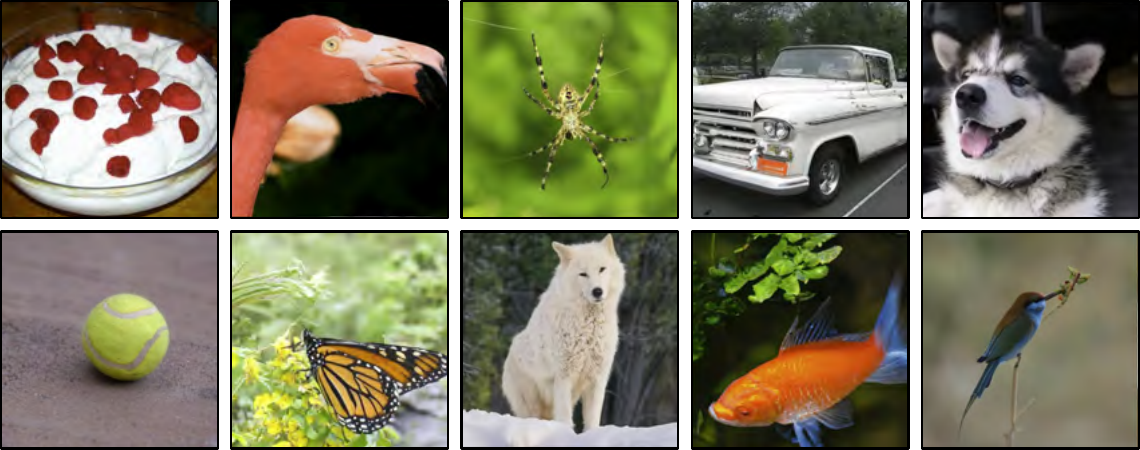
图 18.12

图 18.12 使用分类器引导的条件生成。以不同 ImageNet 类别为条件的图像样本。同一模型可以产生高度多样化的图像类别的高质量样本。改编自 Dhariwal & Nichol (2021)。
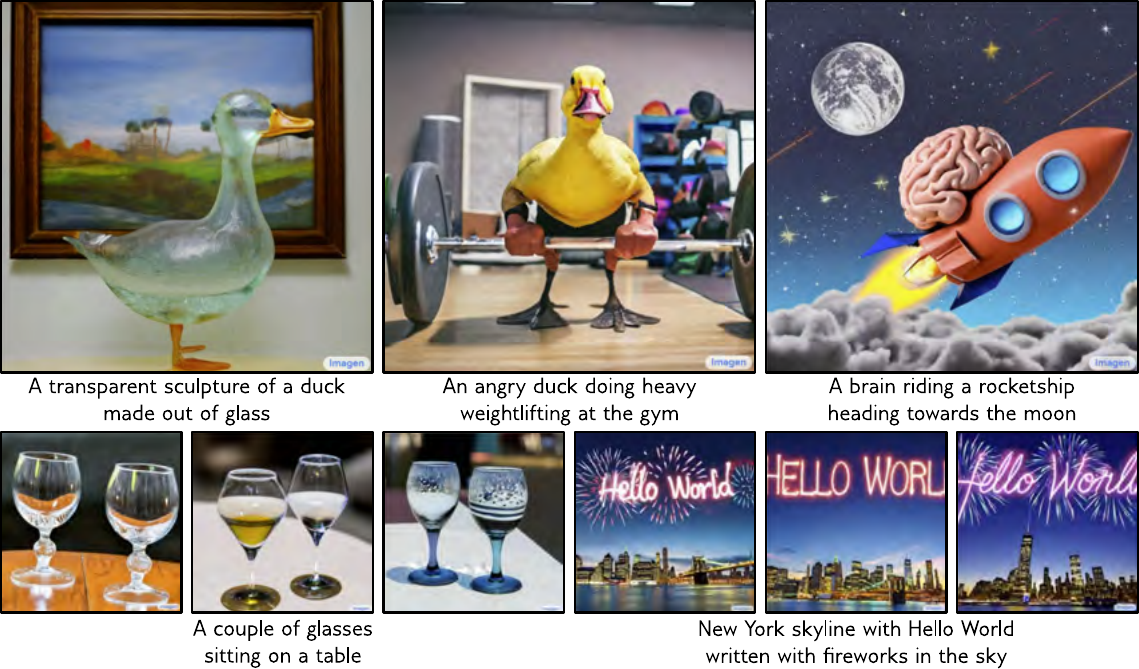
图 18.13

图 18.13 使用文本提示的条件生成。从级联生成框架合成的图像,以大型语言模型编码的文本提示为条件。随机模型可以产生许多与提示兼容的不同图像。模型可以计数物体并将文本整合到图像中。改编自 Saharia et al. (2022b)。

18.7 总结

扩散模型通过反复将当前表示与随机噪声混合,将数据样本映射到一系列潜变量。经过足够多的步骤,表示变得与白噪声不可区分。由于这些步骤很小,每一步的逆去噪过程可以用正态分布近似并由深度学习模型预测。损失函数基于证据下界(ELBO),最终导出简单的最小二乘形式。

对于图像生成,每个去噪步骤使用 U-Net 实现,因此与其他生成模型相比采样较慢。为了提高生成速度,可以将扩散模型改为确定性形式,此时用更少步骤采样也能获得良好效果。已经提出了多种方法来在类别信息、图像和文本信息上进行条件生成。结合这些方法产生了令人印象深刻的文本到图像合成结果。

基于 CC-BY-NC-ND 许可协议