
第3章 浅层神经网络
第 2 章介绍了使用一维线性回归进行监督学习。然而,该模型只能将输入/输出关系描述为一条直线。本章介绍浅层神经网络。这类网络描述分段线性函数,其表达能力足以逼近多维输入与输出之间任意复杂的关系。
3.1 神经网络示例
浅层神经网络是带有参数
我们可以将这个计算分为三个部分:首先,计算输入的三个线性函数(
为了完成描述,我们需要定义激活函数
它在输入为正时返回输入值本身,否则返回零(图 3.1)。
方程 3.1 所表示的输入/输出关系族可能并不直观。然而,前一章的思想同样适用。方程 3.1 表示一族函数,其中特定的族成员取决于十个参数
3.1.1 神经网络的直觉
事实上,方程 3.1 表示一族连续的分段线性函数(图 3.2),最多有四个线性区域。现在我们分解方程 3.1,说明为什么它描述了这样一族函数。为便于理解,我们将函数拆为两部分。首先,引入中间量:
我们将
图 3.3 展示了生成图 3.2a 中函数的计算流程。每个隐藏单元计算输入的一个线性函数
图 3.3j 中的每个线性区域对应隐藏单元中不同的激活模式(activation pattern)。当一个单元被截断(输出为零)时,我们称其为不活跃的(inactive);当它未被截断时,称其为活跃的(active)。例如,图中阴影区域接收来自
每个隐藏单元为函数贡献一个"折点",因此三个隐藏单元最多可产生四个线性区域。但只有三个区域的斜率是独立的;第四个要么为零(如果所有隐藏单元都不活跃),要么是其他区域斜率的线性组合。
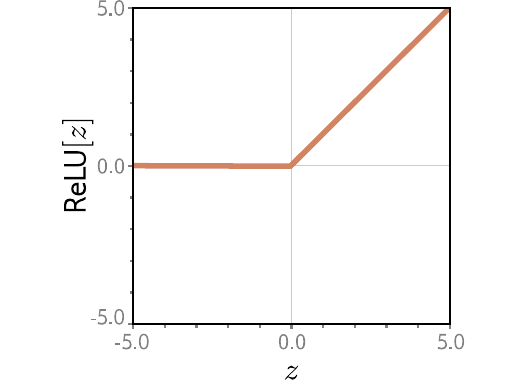
图 3.1 修正线性单元(ReLU)。该激活函数在输入小于零时返回零,否则返回输入值本身。换言之,它将负值截断为零。虽然激活函数有许多其他选择(见图 3.13),但 ReLU 是最常用且最易于理解的。
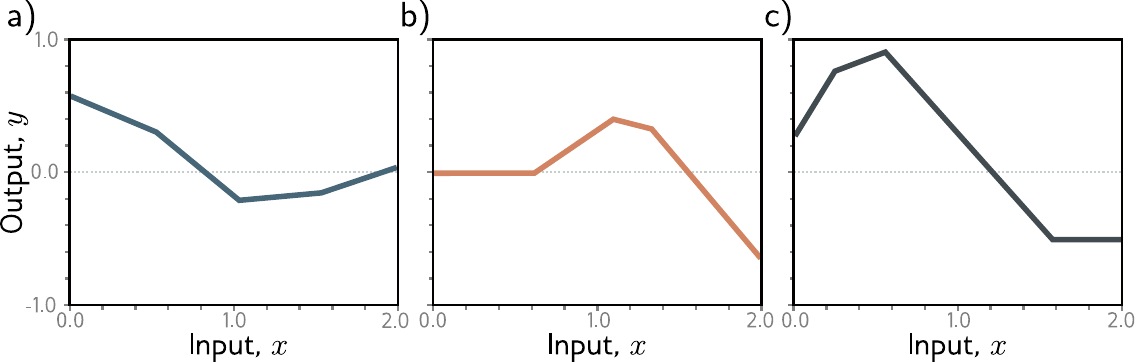
图 3.2 方程 3.1 定义的函数族。a–c) 十个参数
的三种不同选择。在每种情况下,输入/输出关系都是分段线性的。但折点的位置、各线性区域的斜率和整体高度各不相同。
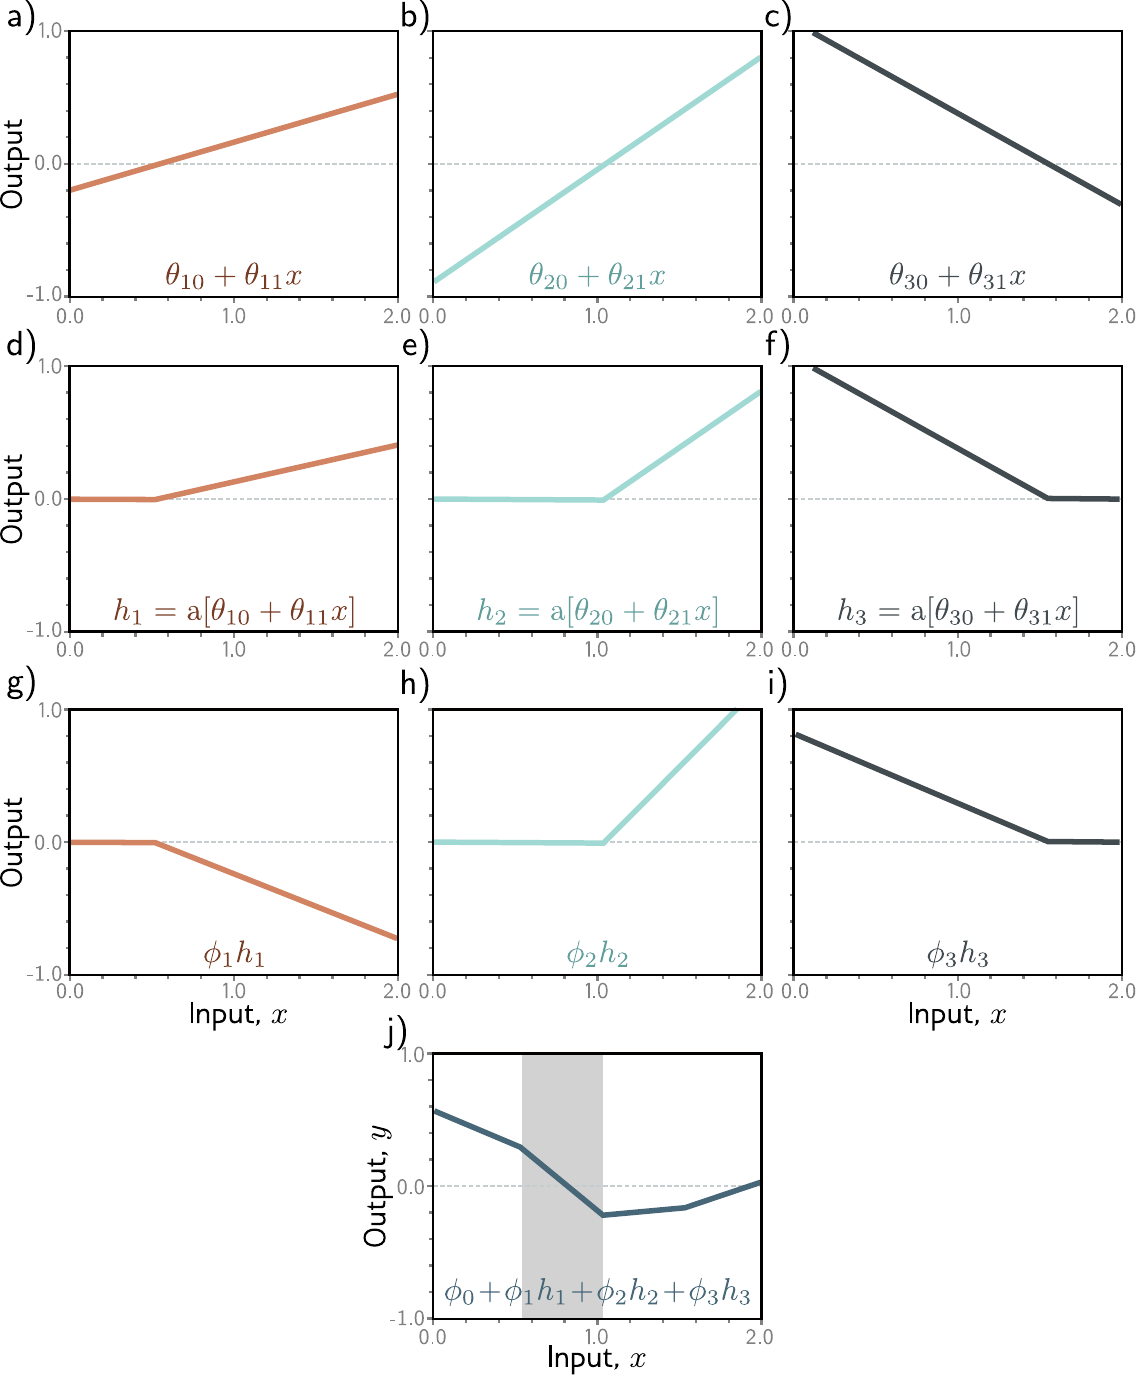
图 3.3 图 3.2a 中函数的计算过程。a–c) 输入
通过三个线性函数处理,每个函数有不同的截距 和斜率 。d–f) 每条线通过 ReLU 激活函数截断负值。g–i) 三条截断后的线分别乘以权重 、 和 。j) 最后,截断加权后的函数相加,再加上控制整体高度的偏移 。四个线性区域中的每一个对应隐藏单元中不同的激活模式。在阴影区域中, 不活跃(被截断),而 和 都是活跃的。
3.1.2 神经网络的图示
我们一直在讨论一个具有一个输入、一个输出和三个隐藏单元的神经网络。图 3.4a 对其进行了可视化。输入在左侧,隐藏单元在中间,输出在右侧。每个连接表示十个参数之一。为简化表示,通常不画截距参数,因此该网络通常如图 3.4b 所示。
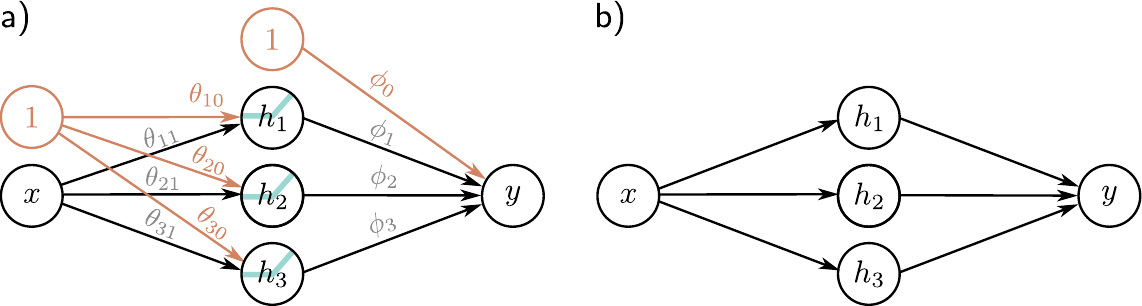
图 3.4 神经网络的图示。a) 输入
在左,隐藏单元 在中,输出 在右。计算从左到右流动。十个箭头中的每一个代表一个参数。b) 更常见的简化图示省略了截距、ReLU 函数和参数名称;这个更简洁的表示描述的是同一个网络。
3.2 万能近似定理
上一节介绍了一个具有一个输入、一个输出、ReLU 激活函数和三个隐藏单元的示例神经网络。现在稍加推广,考虑具有
这些隐藏单元线性组合形成输出:
浅层网络中隐藏单元的数量是网络容量(network capacity)的度量。使用 ReLU 激活函数时,具有
事实上,只要隐藏单元(即容量)足够多,浅层网络可以以任意精度描述定义在实数线紧致子集上的任何连续一维函数。直觉上,每增加一个隐藏单元就多一个线性区域。随着区域数量增多,它们代表函数的更小片段,每段都可以用一条直线越来越好地逼近(图 3.5)。万能近似定理(universal approximation theorem)证明了:对于任何连续函数,都存在一个能以任意指定精度逼近该函数的浅层网络。
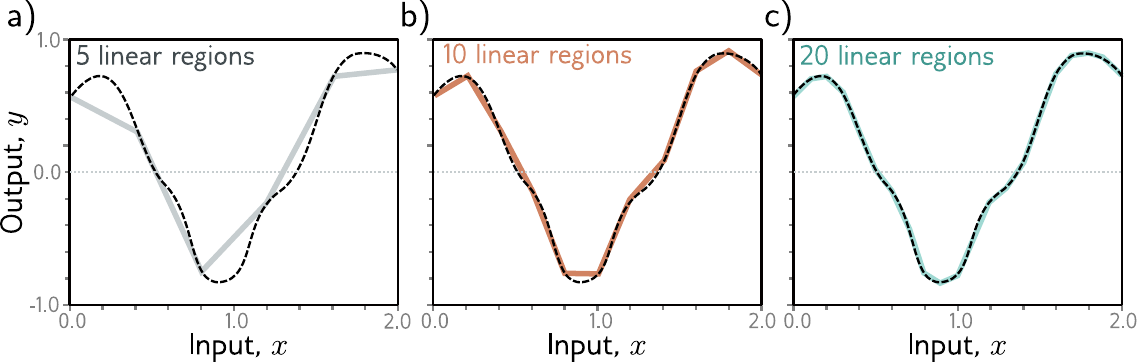
图 3.5 用分段线性模型逼近一维函数(虚线)。a–c) 随着区域数增加,模型越来越接近连续函数。具有标量输入的神经网络每个隐藏单元增加一个线性区域。这个思想可推广到
维的函数。万能近似定理证明,只要有足够多的隐藏单元,就存在一个浅层网络能够以任意精度逼近定义在 紧致子集上的任何给定连续函数。
3.3 多维输入与输出
在上面的例子中,网络只有标量输入
3.3.1 多维输出的可视化
要将网络扩展到多维输出
以及
两个输出是隐藏单元的两个不同线性函数。如图 3.3 所示,分段函数中的"折点"取决于初始线性函数
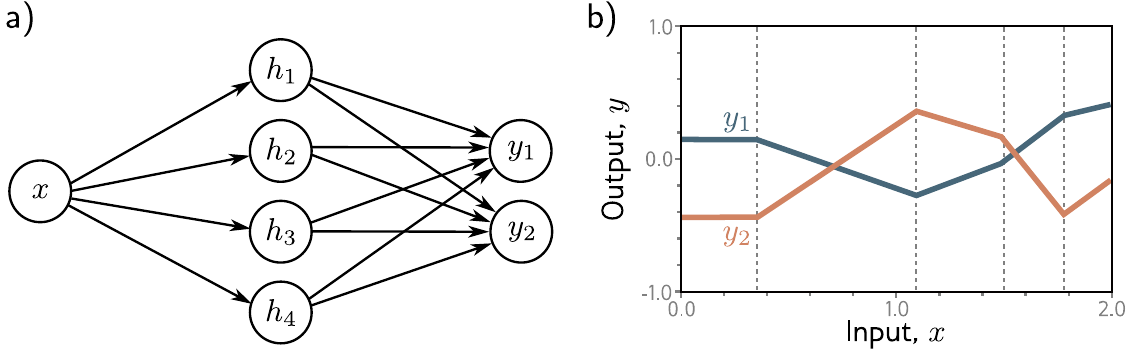
图 3.6 具有一个输入、四个隐藏单元和两个输出的网络。a) 网络结构可视化。b) 该网络产生两个分段线性函数
和 。这两个函数的四个"折点"(位于竖直虚线处)被约束在相同位置,因为它们共享相同的隐藏单元,但斜率和整体高度可以不同。
3.3.2 多维输入的可视化
为了处理多维输入
其中每个输入现在有一个斜率参数。隐藏单元以通常的方式组合形成输出:
图 3.8 展示了该网络的处理过程。每个隐藏单元接收两个输入的线性组合,这在三维输入/输出空间中形成一个有方向的平面。激活函数将这些平面的负值截断为零。截断后的平面随后在第二个线性函数(方程 3.10)中重新组合,生成一个由凸多边形分段线性区域组成的连续曲面(图 3.8j)。每个区域对应隐藏单元中不同的激活模式。
当输入维度超过两个时,难以可视化,但解释类似。输出将是输入的连续分段线性函数,其中线性区域是多维输入空间中的凸多面体。
注意随着输入维度增加,线性区域的数量迅速增长(图 3.9)。为直觉理解其增速,考虑每个隐藏单元定义一个超平面,将其活跃(输出不被截断)的空间部分与不活跃的部分分开。如果隐藏单元数量与输入维度
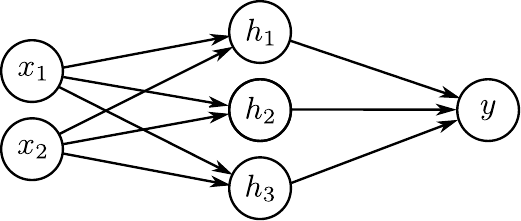
图 3.7 具有二维输入
和标量输出 的神经网络可视化。
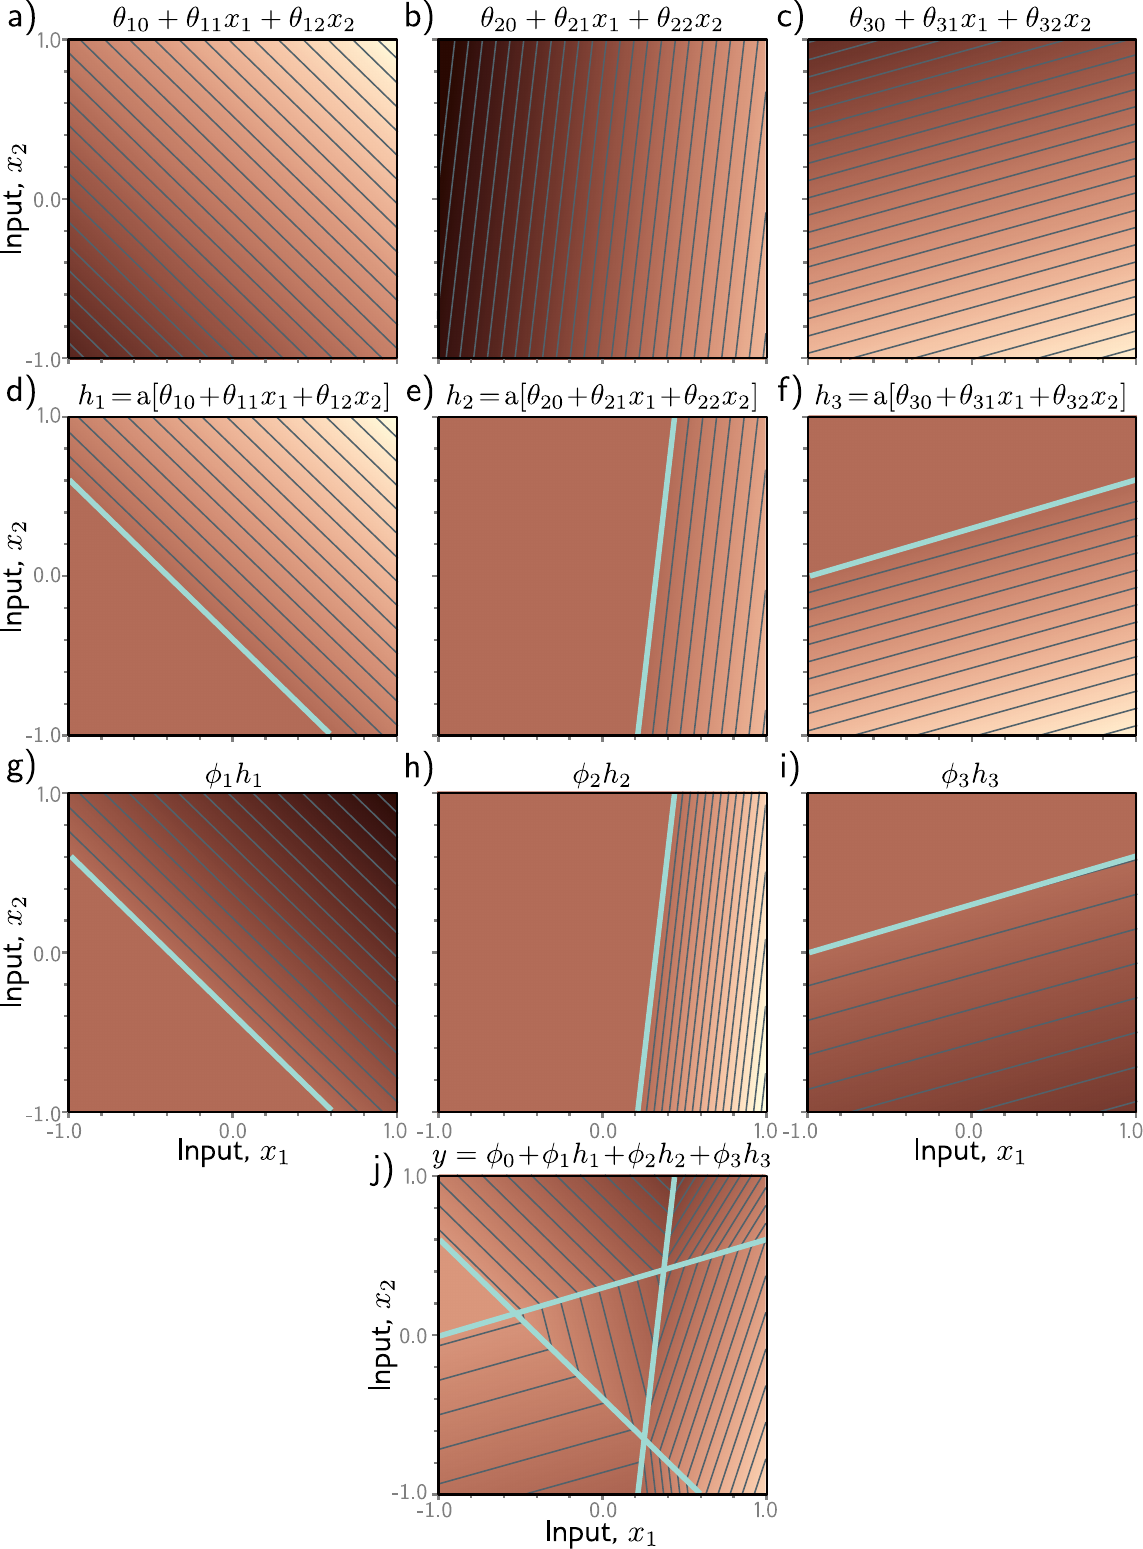
图 3.8 具有两个输入
、三个隐藏单元 和一个输出 的网络处理过程。a–c) 每个隐藏单元的输入是两个输入的线性组合,对应一个有方向的平面。亮度表示函数输出值。d–f) 每个平面被 ReLU 激活函数截断(青色线是等值线,相当于图 3.3d–f 中的"折点")。g–i) 截断后的平面分别加权。j) 加权函数相加,加上控制整体高度的偏移。结果是由凸多边形分段线性区域组成的连续曲面。
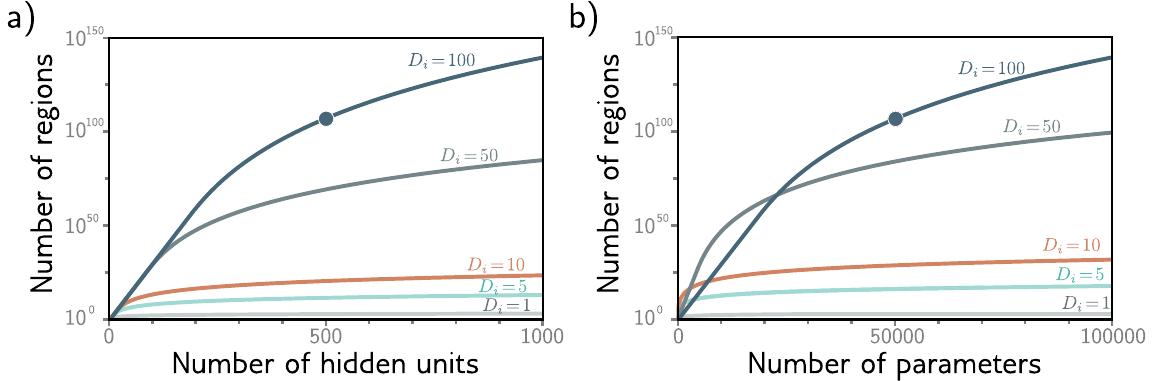
图 3.9 线性区域数与隐藏单元数的关系。a) 五种不同输入维度
下最大可能区域数关于隐藏单元数的函数。高维情况下区域数增长极快; 个单元、输入维度 时,区域数可超过 (实心圆)。b) 相同数据以参数数量为横轴。实心圆对应 (a) 中 的模型,拥有 51,001 个参数,按现代标准非常小。
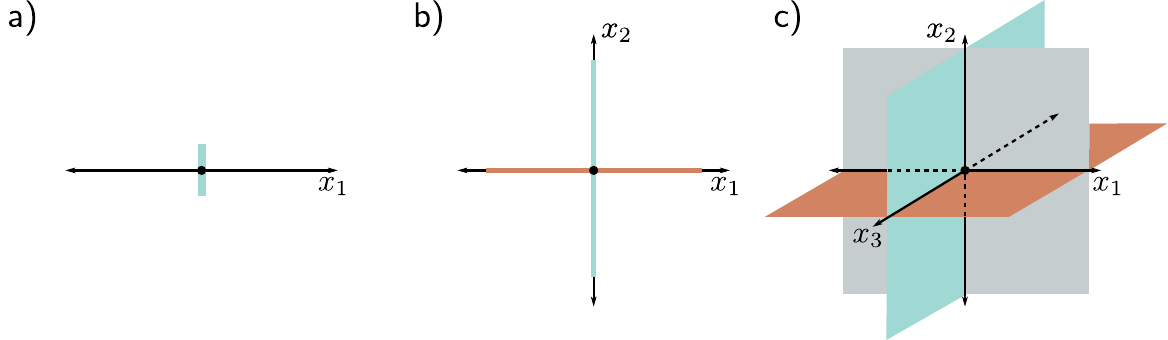
图 3.10 线性区域数与输入维度的关系。a) 单输入维度下,一个隐藏单元创建一个折点,将轴分为两个线性区域。b) 二维输入下,两个隐藏单元可用两条线将输入空间分成四个区域。c) 三维输入下,三个隐藏单元可用三个平面将输入空间分成八个区域。推而广之,
维输入和 个隐藏单元可用 个超平面将空间分成 个线性区域。
3.4 浅层神经网络:一般形式
我们已经描述了若干示例浅层网络,以帮助建立关于它们工作方式的直觉。现在给出浅层神经网络的一般方程:
这些隐藏单元线性组合形成输出:
其中
激活函数使模型能够描述输入与输出之间的非线性关系;如果没有激活函数或使用线性激活函数,从输入到输出的整体映射将被限制为线性的。人们尝试过许多不同的激活函数(见图 3.13),但最常用的是 ReLU(图 3.1),它易于解释。使用 ReLU 激活时,网络将输入空间划分为由 ReLU 函数中"折点"的超平面交集定义的凸多面体。每个凸多面体内包含一个不同的线性函数。不同输出的多面体划分相同,但其中包含的线性函数可以不同。
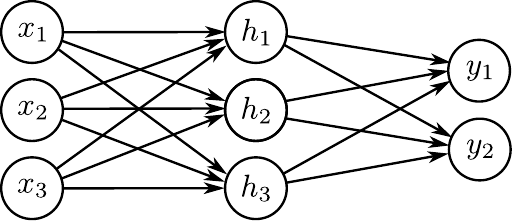
图 3.11 具有三个输入和两个输出的神经网络可视化。该网络有二十个参数:十五个斜率(由箭头表示)和五个偏移(未显示)。
3.5 术语
本章最后介绍一些术语。令人遗憾的是,神经网络有大量相关术语。它们通常用层(layers)来描述。图 3.12 左侧是输入层(input layer),中间是隐藏层(hidden layer),右侧是输出层(output layer)。我们说图 3.12 中的网络有一个隐藏层,包含四个隐藏单元。隐藏单元有时也被称为神经元(neurons)。当数据通过网络传递时,输入到隐藏层之前的值(即 ReLU 函数应用之前的值)称为预激活值(pre-activations),隐藏层的值(即 ReLU 函数应用之后的值)称为激活值(activations)。
出于历史原因,任何至少有一个隐藏层的神经网络也被称为多层感知器(multi-layer perceptron),简称 MLP。只有一个隐藏层的网络(如本章所述)有时被称为浅层神经网络(shallow neural networks)。具有多个隐藏层的网络(如下一章所述)被称为深度神经网络(deep neural networks)。连接形成无环图(即无循环的图,如本章所有示例)的神经网络被称为前馈网络(feed-forward networks)。如果一层中的每个元素都连接到下一层的每个元素(如本章所有示例),则该网络是全连接的(fully connected)。这些连接代表底层方程中的斜率参数,被称为网络权重(network weights)。偏移参数(图 3.12 中未显示)被称为偏置(biases)。
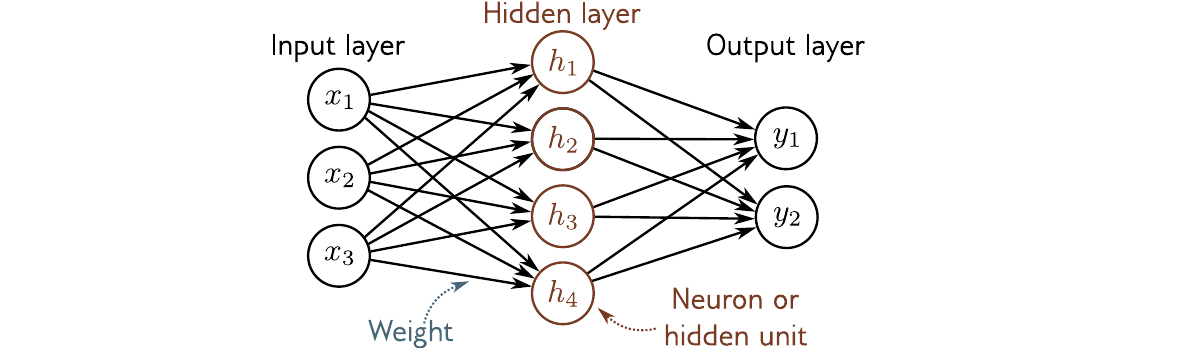
图 3.12 术语。浅层网络由输入层、隐藏层和输出层组成。各层之间通过前向连接(箭头)相连。因此,这些模型被称为前馈网络。当一层中的每个变量都连接到下一层中的每个变量时,我们称之为全连接网络。每个连接代表底层方程中的一个斜率参数,这些参数称为权重。隐藏层中的变量称为神经元或隐藏单元。输入隐藏单元之前的值(即 ReLU 函数应用之前)称为预激活值,隐藏单元的值(即 ReLU 函数应用之后)称为激活值。
3.6 总结
浅层神经网络有一个隐藏层。它们 (i) 计算输入的若干线性函数,(ii) 将每个结果通过激活函数,然后 (iii) 取这些激活值的线性组合形成输出。浅层神经网络基于输入
第 4 章讨论深度神经网络,它通过增加更多隐藏层来扩展本章的模型。第 5–7 章描述如何训练这些模型。