
第4章 深度神经网络
上一章介绍了只有单个隐藏层的浅层神经网络。本章介绍具有多个隐藏层的深度神经网络。使用 ReLU 激活函数时,浅层和深度网络都描述了从输入到输出的分段线性映射。
随着隐藏单元数量的增加,浅层神经网络的描述能力提高。事实上,只要有足够多的隐藏单元,浅层网络可以描述高维空间中任意复杂的函数。然而,对于某些函数,所需的隐藏单元数量大到不切实际。在给定参数数量下,深度网络比浅层网络能产生多得多的线性区域。因此,从实用的角度看,深度网络可以描述更广泛的函数族。
4.1 组合神经网络
为了深入理解深度神经网络的行为,我们首先考虑将两个浅层网络组合起来,使第一个网络的输出成为第二个网络的输入。考虑两个各有三个隐藏单元的浅层网络(图 4.1a)。第一个网络接收输入
以及
第二个网络以
以及
使用 ReLU 激活时,这个组合模型同样描述了一族分段线性函数。然而,线性区域的数量可能远多于具有六个隐藏单元的浅层网络。要理解这一点,考虑选择第一个网络使其产生三个正负斜率交替的线性区域(图 4.1b)。这意味着三段不同范围的
另一种理解方式是:第一个网络将输入空间
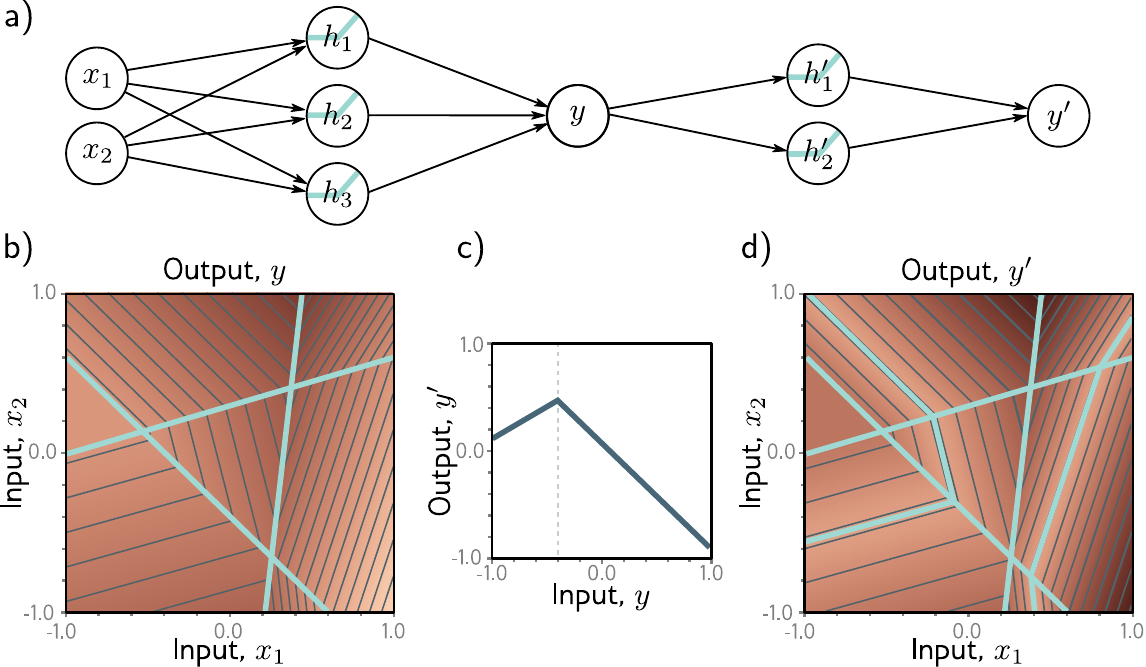
图 4.2 具有二维输入的组合神经网络。a) 第一个网络有三个隐藏单元,接收两个输入
和 并返回标量输出 ,传入第二个具有两个隐藏单元的网络产生 。b) 第一个网络产生由七个线性区域组成的函数。c) 第二个网络定义 上具有两个线性区域的函数。d) 组合后,第一个网络的六个非平坦区域各被分为两个新区域,共产生 13 个线性区域。
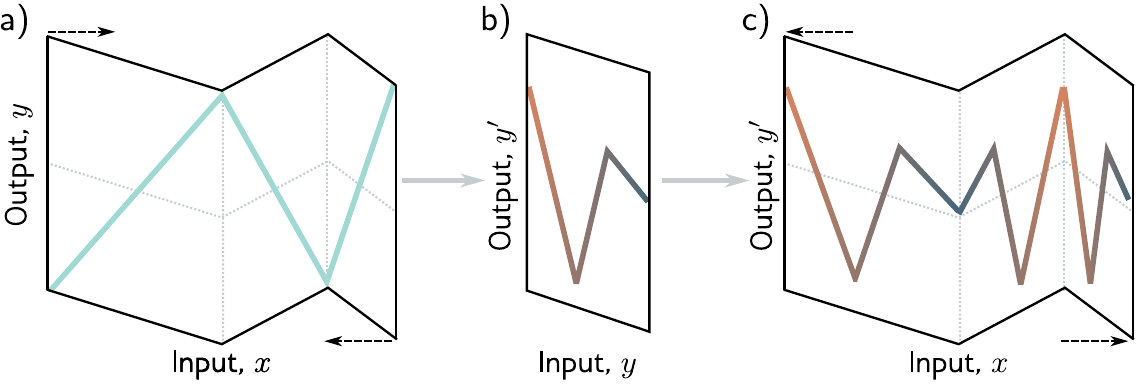
图 4.3 深度网络与输入空间折叠。a) 第一个网络将输入空间"折叠"到自身上。b) 第二个网络在折叠后的空间上应用函数。c) "展开"后得到最终输出。
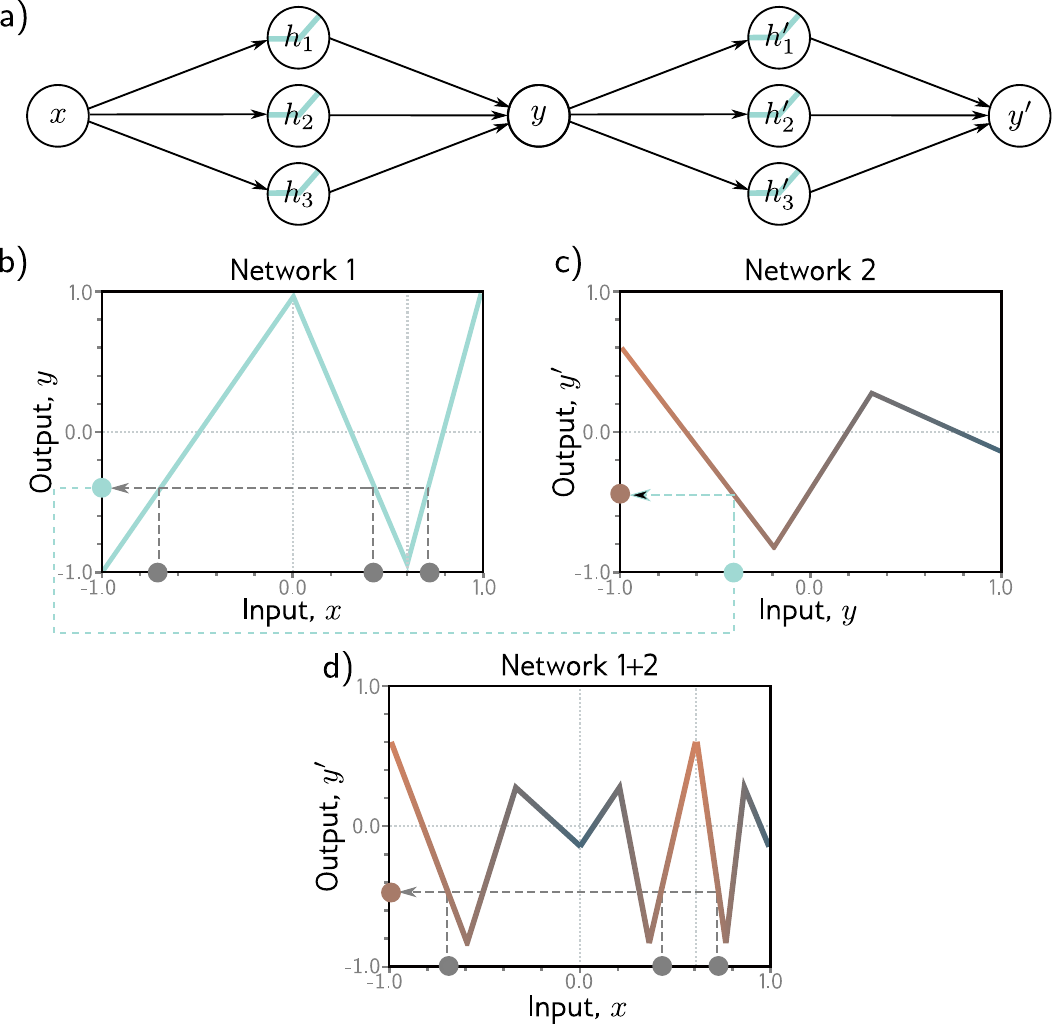
图 4.1 组合两个各有三个隐藏单元的单层网络。a) 第一个网络的输出
成为第二个网络的输入。b) 第一个网络将 映射为具有三个正负交替斜率的线性区域的函数。三段不同的 被映射到相同的输出 (灰色圆圈映射到青色圆圈)。c) 第二个网络定义一个具有三个线性区域的函数。d) 组合效果是第二个网络的函数被复制了三次,产生九个线性区域。
4.2 从组合网络到深度网络
上一节说明了通过将一个浅层网络的输出传入另一个可以创建复杂函数。我们现在证明这是具有两个隐藏层的深度网络的一种特殊情况。
第一个网络的输出(
其中
由此可知,具有两个隐藏层的网络可以表示通过将一个单层网络的输出传入另一个而创建的函数族。事实上,它表示一个更广泛的函数族,因为在方程 4.6 中,九个斜率参数
4.3 深度神经网络
上一节说明组合两个浅层网络产生具有两个隐藏层的深度网络。现在考虑一般情况:具有两个隐藏层、每层三个隐藏单元的深度网络(图 4.4)。第一层定义为:
第二层为:
输出为:
分析这些方程可以从另一个角度理解网络如何构造越来越复杂的函数(图 4.5):
- 第一层的三个隐藏单元
按照通常方式计算——对输入做线性函数然后通过 ReLU 激活函数(方程 4.7)。 - 第二层的预激活值通过对这些隐藏单元取三个新的线性函数来计算(方程 4.8 的参数部分)。此时,我们实际上得到了一个具有三个输出的浅层网络;我们有三个分段线性函数,它们的线性区域之间的"折点"在相同位置(见图 3.6)。
- 在第二隐藏层,另一个 ReLU 函数
被应用到每个函数上,截断它们并在每个函数中增加新的"折点"。 - 最终输出是这些隐藏单元的线性组合(方程 4.9)。
总之,我们可以将每一层理解为"折叠"输入空间,或者理解为截断函数(创建新的区域)然后重新组合。无论哪种描述都只提供了部分洞见。重要的是不要忘记,这仍然只是一个将输入
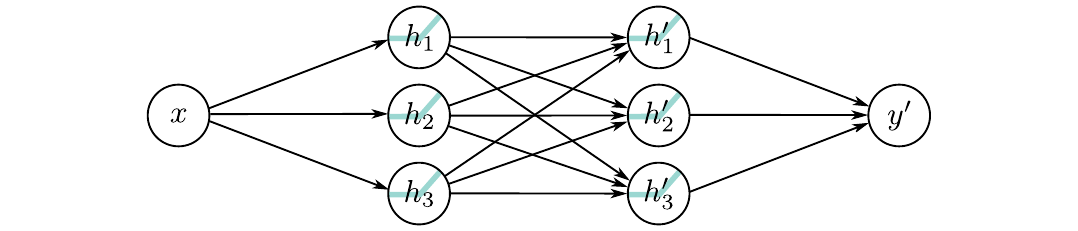
图 4.4 具有一个输入、一个输出和两个隐藏层(每层三个隐藏单元)的神经网络。
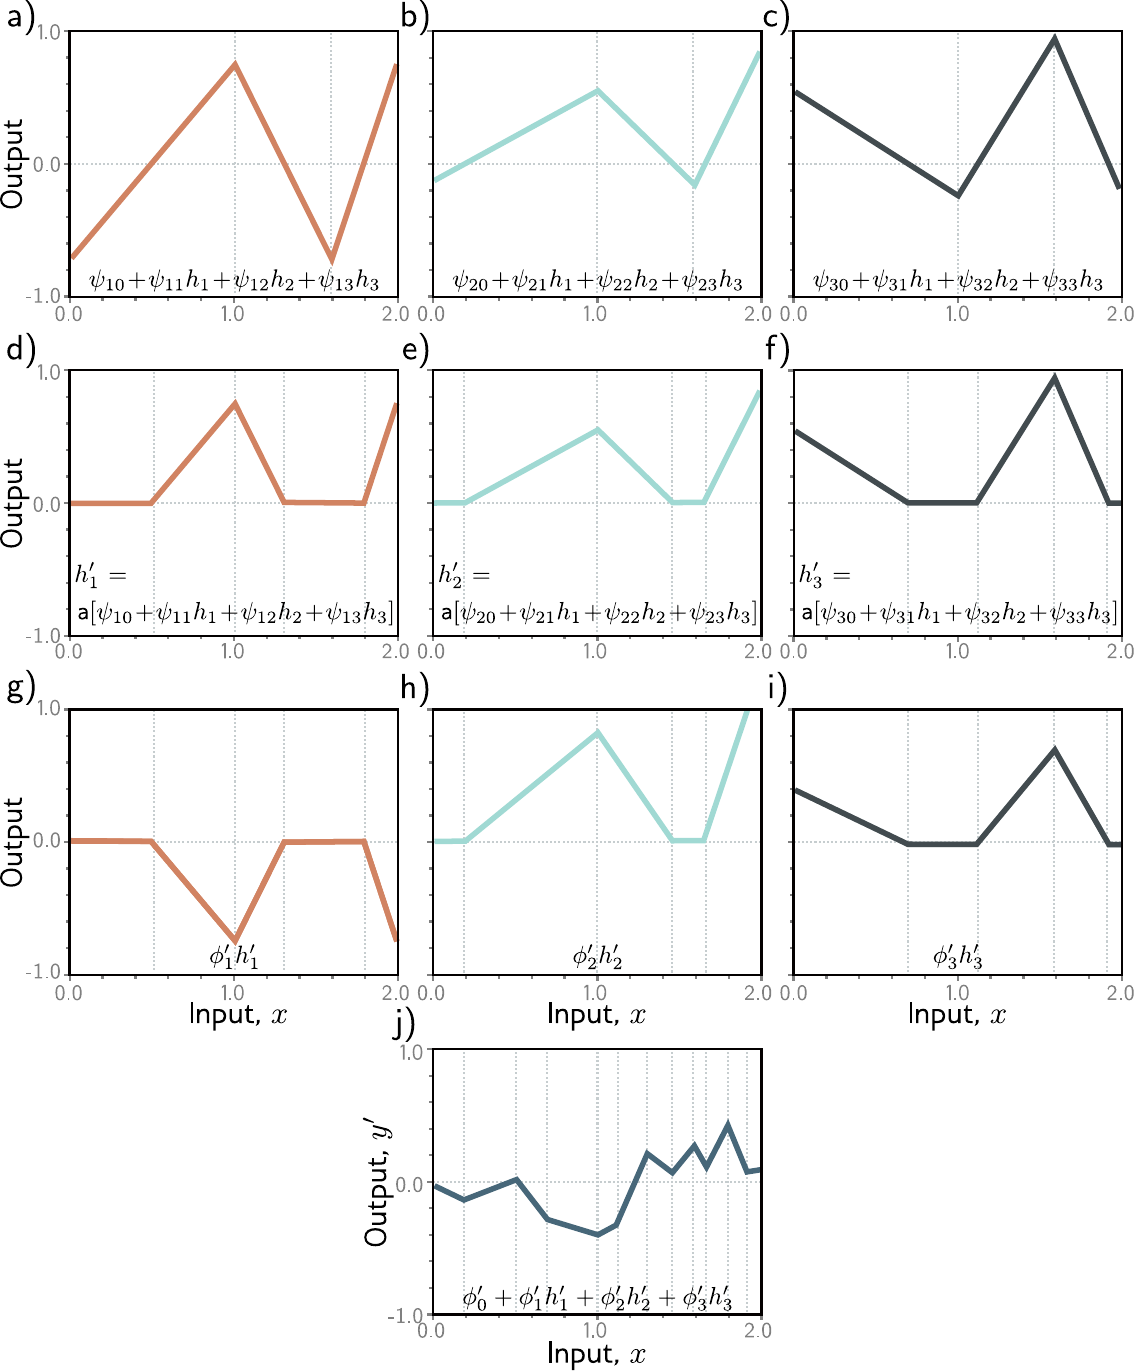
图 4.5 图 4.4 中深度网络的计算过程。a–c) 第二隐藏层的输入(即预激活值)是三个分段线性函数,其线性区域间的"折点"在相同位置(见图 3.6)。d–f) 每个分段线性函数被 ReLU 激活函数截断。g–i) 截断后的函数分别乘以权重
。j) 加权截断函数相加,加上控制整体高度的偏移 。
4.3.1 超参数
我们可以将深度网络构造扩展到两个以上的隐藏层;现代网络可能有一百多层,每层有数千个隐藏单元。每层中隐藏单元的数量称为网络的宽度(width),隐藏层的数量称为深度(depth)。隐藏单元的总数是网络容量(capacity)的度量。
我们将层数记为
4.4 矩阵表示
我们已经看到深度神经网络由线性变换与激活函数交替组成。我们可以用矩阵符号等价地描述方程 4.7–4.9:
以及
或更紧凑地:
其中函数
4.4.1 一般公式
上述符号对于层数很多的网络变得繁琐。因此,从现在起我们将第
模型参数
我们也可以将网络等价地写为单个函数:
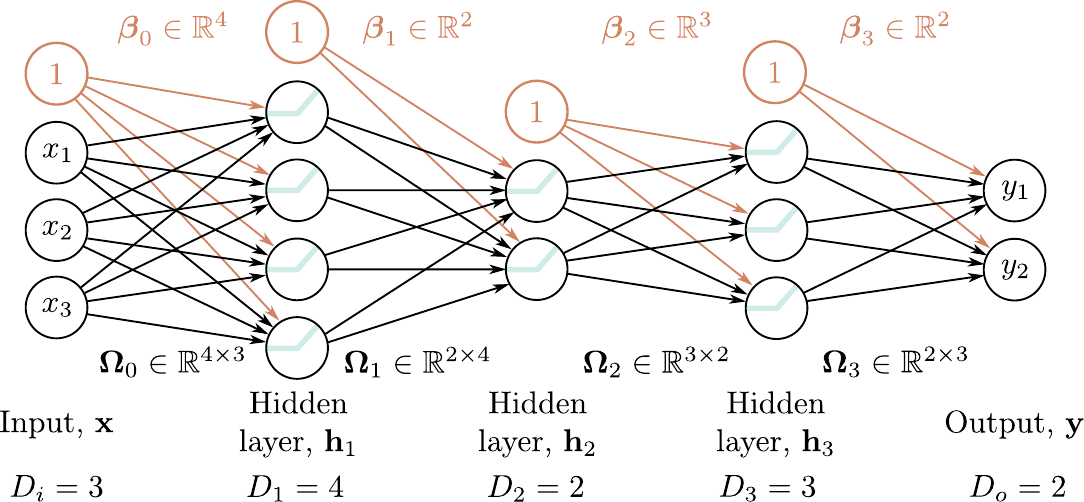
图 4.6 矩阵符号表示。具有
维输入 、 维输出 、 个隐藏层 (维度分别为 )的网络。权重存储在矩阵 中,偏置存储在向量 中。
4.5 浅层网络与深度网络的比较
第 3 章讨论了浅层网络(单个隐藏层),本章描述了深度网络(多个隐藏层)。现在我们来比较这两种模型。
4.5.1 逼近不同函数的能力
在 3.2 节中,我们论证了只要容量(隐藏单元)足够,浅层神经网络可以以任意精度建模任何连续函数。在本章中,我们看到具有两个隐藏层的深度网络可以表示两个浅层网络的组合。如果第二个网络计算恒等函数,则该深度网络就等同于一个浅层网络。因此,只要容量足够,深度网络同样可以以任意精度逼近任何连续函数。
4.5.2 每参数的线性区域数
具有一个输入、一个输出和
图 4.7a 展示了对于标量输入到标量输出的网络,最大线性区域数如何随参数数量增长。在固定参数预算下,深度网络比浅层网络能创建多得多的线性区域。输入维度
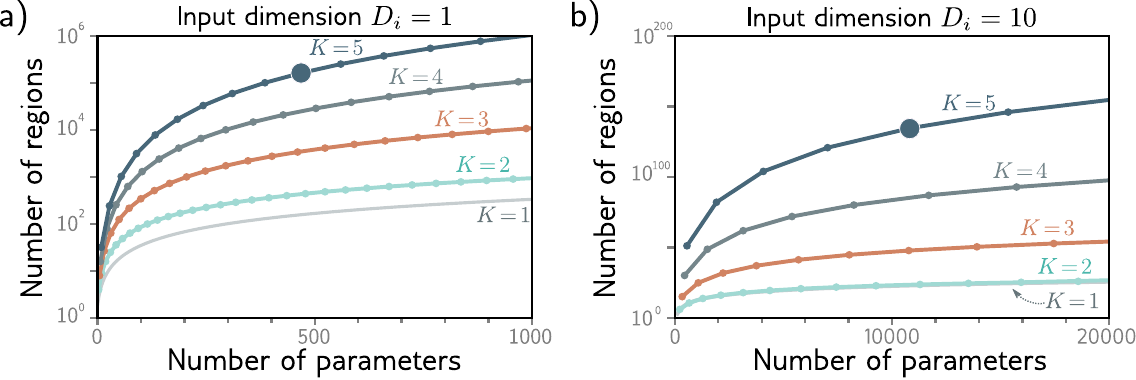
图 4.7 每参数的线性区域数。a) 对于标量输入到标量输出的网络,最大线性区域数随参数数量的增长关系。深度网络(多层)比浅层网络(单层)能用相同数量的参数创建更多线性区域。b) 输入维度
增加时,深度网络的优势更加显著。
这看起来很有吸引力,但函数的灵活性仍受参数数量限制。深度网络可以创建极大量的线性区域,但这些区域包含复杂的依赖关系和对称性。正如我们在"折叠"输入空间时看到的(图 4.3),更多区域是否真的有优势并不明确——除非 (i) 我们要逼近的真实世界函数中存在类似的对称性,或 (ii) 我们有理由相信从输入到输出的映射确实涉及更简单函数的组合。
4.5.3 深度效率
深度和浅层网络都能建模任意函数,但某些函数用深度网络可以更高效地逼近。研究发现存在这样的函数:浅层网络需要指数级更多的隐藏单元才能达到与深度网络相同的逼近效果。这种现象被称为神经网络的深度效率(depth efficiency)。这一性质同样很有吸引力,但目前尚不清楚我们想要逼近的真实世界函数是否属于这一类别。
4.5.4 大规模结构化输入
我们讨了全连接网络,其中每一层的每个元素都连接到下一层的每个元素。然而,对于大规模结构化输入(如图像,可能包含约
解决方案是并行处理局部图像区域,然后逐步整合越来越大区域的信息。这种从局部到全局的处理方式在没有多层的情况下很难实现(见第 10 章)。
4.5.5 训练与泛化
深度网络相对于浅层网络的另一个可能优势是其易于拟合;训练中等深度的网络通常比训练浅层网络更容易(见图 20.2)。这可能是因为过参数化的深度模型(即参数多于训练样本的模型)拥有大量近似等价的、容易找到的解。但随着隐藏层数增加,训练又变得更加困难。已有许多方法来缓解这一问题(见第 11 章)。
深度神经网络似乎也比浅层网络更好地泛化到新数据。实践中,大多数任务的最佳结果都是用具有数十甚至数百层的网络实现的。这些现象都尚未被充分理解,我们将在第 20 章回到这些问题。
4.6 总结
本章首先考察了组合两个浅层网络会发生什么。我们论证了第一个网络"折叠"输入空间,然后第二个网络应用分段线性函数。第二个网络的效果在输入空间折叠重合的地方被复制。
然后我们证明了浅层网络的组合是具有两个隐藏层的深度网络的一种特殊情况。我们将每层的 ReLU 函数解释为在多处截断输入函数并在输出函数中创建更多"折点"。我们引入了超参数的概念——对于目前讨论的网络,包括层数和每层的隐藏单元数。
最后,我们比较了浅层和深度网络。我们发现:(i) 在容量足够的情况下,两者都能逼近任何函数;(ii) 深度网络每参数产生更多线性区域;(iii) 某些函数可以用深度网络更高效地逼近;(iv) 图像等大规模结构化输入最适合多阶段处理;(v) 实践中大多数任务的最佳结果都使用多层深度网络获得。
现在我们理解了深度和浅层网络模型,接下来将关注如何训练它们。下一章讨论损失函数。对于任意给定的参数值