
第16章 归一化流
第 15 章介绍了生成对抗网络(GAN)。这些是将潜变量通过深度网络传递以创建新样本的生成模型。GAN 使用样本应与真实数据不可区分的原则进行训练。然而,它们不在数据样本上定义分布。因此,评估新样本属于同一数据集的概率并不直接。
在本章中,我们描述归一化流(normalizing flows)。它们通过使用深度网络将简单分布变换为更复杂的分布来学习概率模型。归一化流既可以从该分布中采样,也可以评估新样本的概率。然而,它们需要专门的架构:每一层都必须是可逆的(invertible)。换言之,它必须能够在两个方向上变换数据。
16.1 一维示例
归一化流是概率生成模型:它们将概率分布拟合到训练数据(图 14.2b)。考虑对一维分布
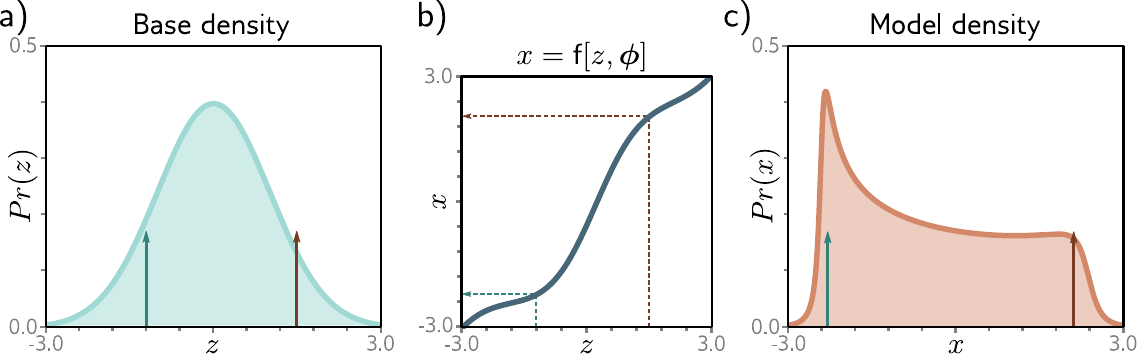
图 16.1 变换概率分布。a) 基础密度是定义在潜变量
上的标准正态分布。b) 该变量通过函数 变换为新变量 ,它 c) 具有新的分布。要从该模型中采样,我们从基础密度中抽取 的值((a) 中的绿色和棕色箭头展示了两个示例)。我们将其通过 (b) 中的函数(如虚线箭头所示)来生成 的值,在 (c) 中以箭头表示。
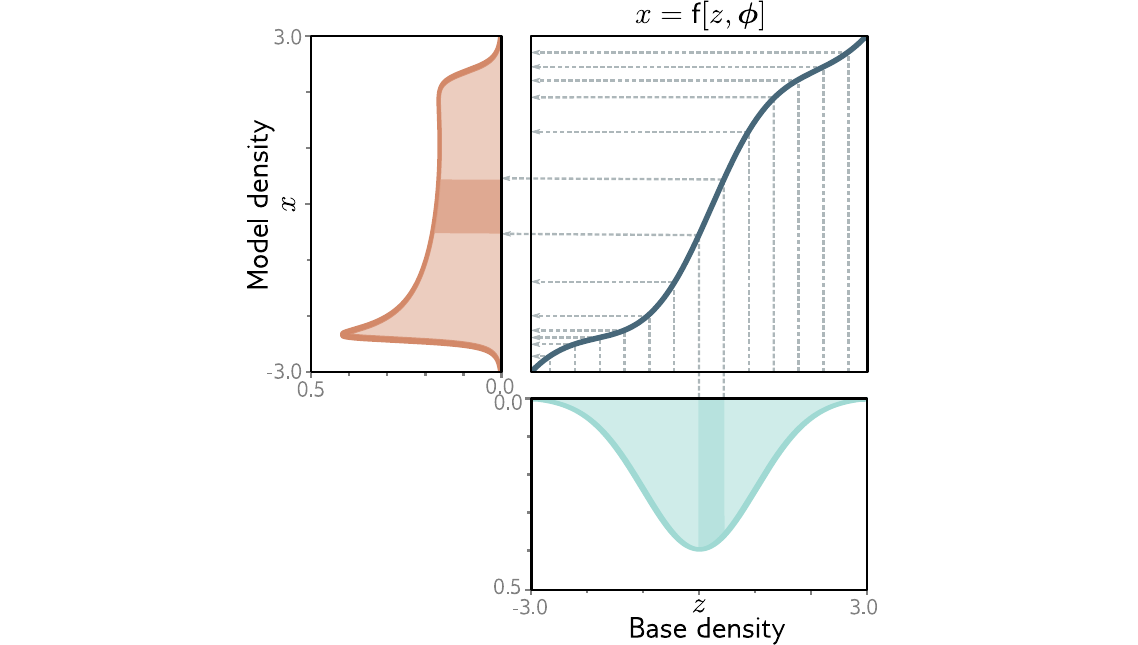
图 16.2 变换分布。基础密度(青色,底部)通过函数(蓝色曲线,右上)变换以创建模型密度(橙色,左侧)。考虑将基础密度分成等间隔的区间(灰色竖线)。相邻线之间的概率质量在变换后必须保持不变。青色阴影区域通过函数中梯度大于一的部分,因此该区域被拉伸。因此,橙色阴影区域的高度必须更低,以保持与青色阴影区域相同的面积。在其他地方(例如
),梯度小于一,模型密度相对于基础密度增加。
16.1.1 度量概率
度量数据点
更精确地说,变换后分布下数据
其中
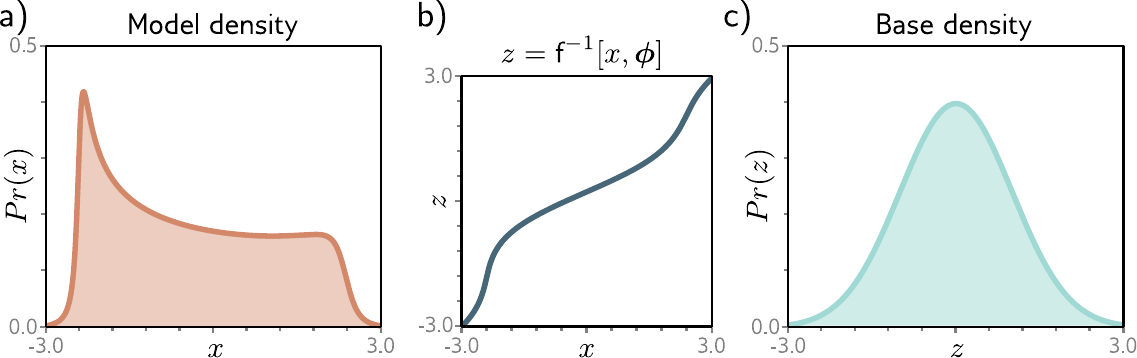
图 16.3 逆映射(归一化方向)。如果函数是可逆的,则可以将模型密度变换回原始基础密度。模型密度下点
的概率部分取决于基础密度下等价点 的概率(见公式 16.1)。
16.1.2 正向和逆向映射
要从分布中采样,我们需要正向映射
正向映射有时被称为生成方向(generative direction)。基础密度通常选择为标准正态分布。因此,逆映射被称为归一化方向(normalizing direction),因为它将
16.1.3 学习
为了学习分布,我们找到使训练数据
其中我们假设数据独立同分布,并在第三行使用了公式 16.1 的似然定义。
16.2 一般情形
上一节发展了一个简单的一维示例,通过变换较简单的基础密度
考虑对具有基础密度
类比公式 16.1,该分布下样本的似然为:
其中
16.2.1 使用深度神经网络的正向映射
在实践中,正向映射
逆映射(归一化方向)由每一层的逆
基础密度
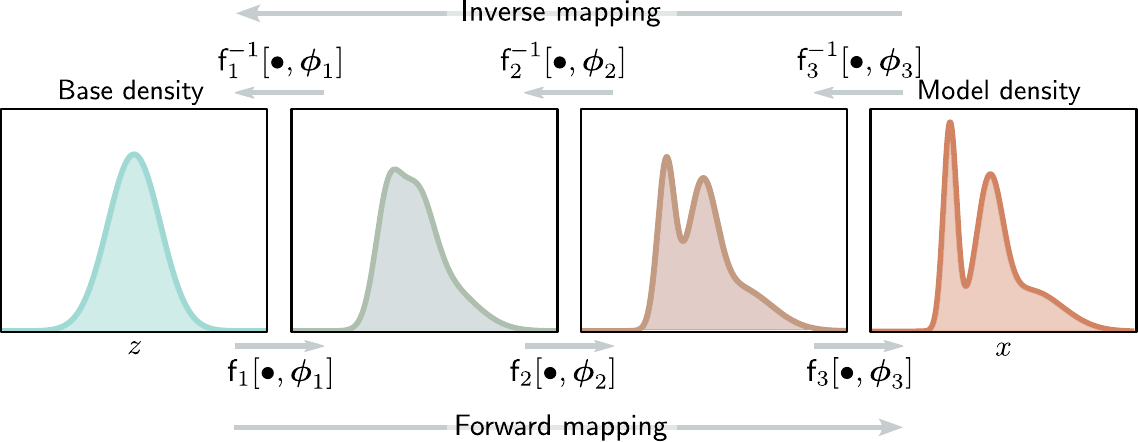
图 16.4 深度神经网络的正向和逆向映射。基础密度(左)通过网络层
逐步变换以创建模型密度。每一层都是可逆的,我们可以等价地将各层的逆视为逐步变换(或"流动")模型密度回到基础密度。
正向映射的 Jacobian 可以表示为:
该 Jacobian 的绝对行列式可以通过取各层绝对行列式的乘积来计算:
逆映射的 Jacobian 的绝对行列式通过对公式 16.5 应用相同的规则求得。它是正向映射中绝对行列式的倒数。
我们使用负对数似然准则对
其中
16.2.2 网络层的理想特性
归一化流的理论很直接。然而,要使其具有实用性,我们需要具有四个性质的网络层
- 总体而言,网络层的集合必须具有足够的表达能力,能将多元标准正态分布映射到任意密度。
- 网络层必须是可逆的;每层必须定义从任意输入点到唯一输出点的一一映射(双射(bijection))。如果多个输入映射到同一输出,逆就会有歧义。
- 必须能够高效地计算每一层的逆。我们需要在每次评估似然时都这样做。这在训练期间反复发生,因此必须有逆的闭式解或快速算法。
- 必须能够高效地评估正向或逆向映射的 Jacobian 的行列式。
16.3 可逆网络层
我们现在描述用于这些模型的不同的可逆网络层或流(flows)。我们从线性流和逐元素流开始。它们容易求逆,也容易计算其 Jacobian 的行列式,但都不具备足够的表达能力来描述基础密度的任意变换。然而,它们构成了耦合流、自回归流和残差流的构建模块,这些更具表达能力。
16.3.1 线性流
线性流的形式为
如果矩阵
一种构造通用、高效可逆且 Jacobian 可高效计算的线性流的方法是直接用 LU 分解来参数化。换言之,我们使用:
其中
不幸的是,线性流的表达能力不足。当线性函数
16.3.2 逐元素流
由于线性流的表达能力不足,我们必须转向非线性流。最简单的是逐元素流,它对输入的每个元素应用逐点非线性函数
Jacobian
函数
其中参数
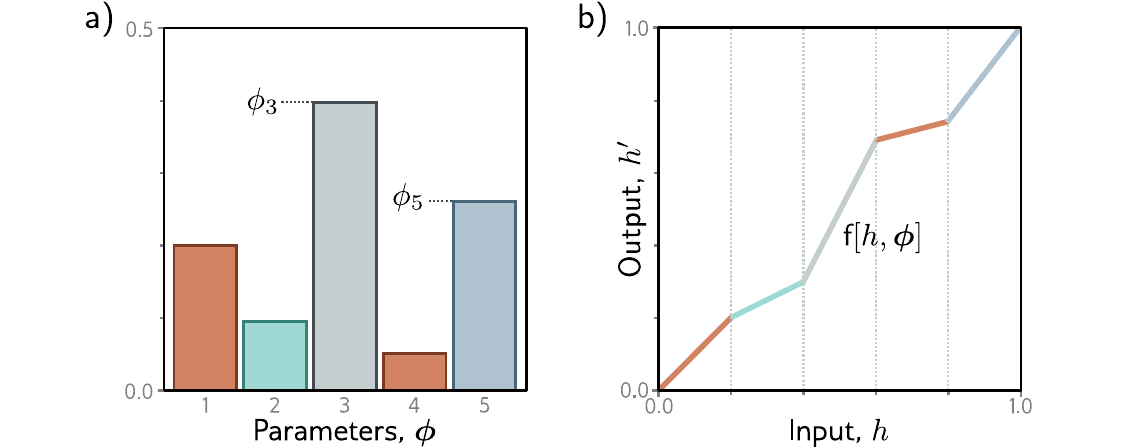
图 16.5 分段线性映射。可逆的分段线性映射
可以通过将输入域 分成 个等大小的区域(此处 )来创建。每个区域有一个斜率参数 。a) 如果这些参数为正且和为一,则 b) 函数将是可逆的并映射到输出域 。
逐元素流是非线性的,但不混合输入维度,因此不能创建变量之间的相关性。当与线性流(能混合维度)交替使用时,可以建模更复杂的变换。然而,在实践中,逐元素流被用作更复杂层(如耦合流)的组件。
16.3.3 耦合流
耦合流(coupling flows)将输入
这里
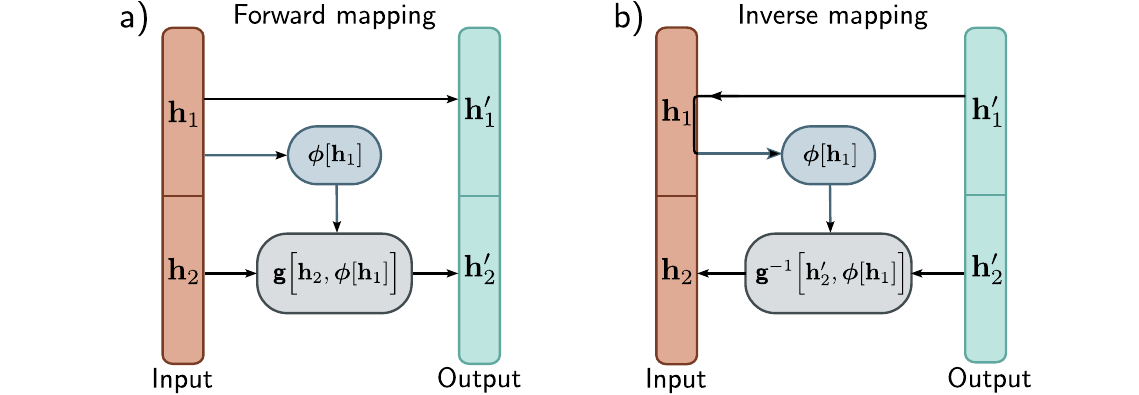
图 16.6 耦合流。a) 输入(橙色向量)被分为
和 。输出(青色向量)的第一部分 是 的副本。输出 通过对 应用可逆变换 来创建,其中参数 本身是 的一个(不一定可逆的)函数。b) 在逆映射中, 。这允许我们计算参数 ,然后应用逆 来恢复 。
如果函数
逆和 Jacobian 都可以高效计算,但这种方法只变换参数取决于前一半的后一半。为了使变换更通用,
16.3.4 自回归流
自回归流(autoregressive flows)是耦合流的推广,将每个输入维度视为单独的"块"(图 16.7)。它们基于输入
函数
可以使用带有适当掩码的网络并行计算输出
反转变换效率较低。考虑正向映射(公式 16.16)和逆(公式 16.17)——由于
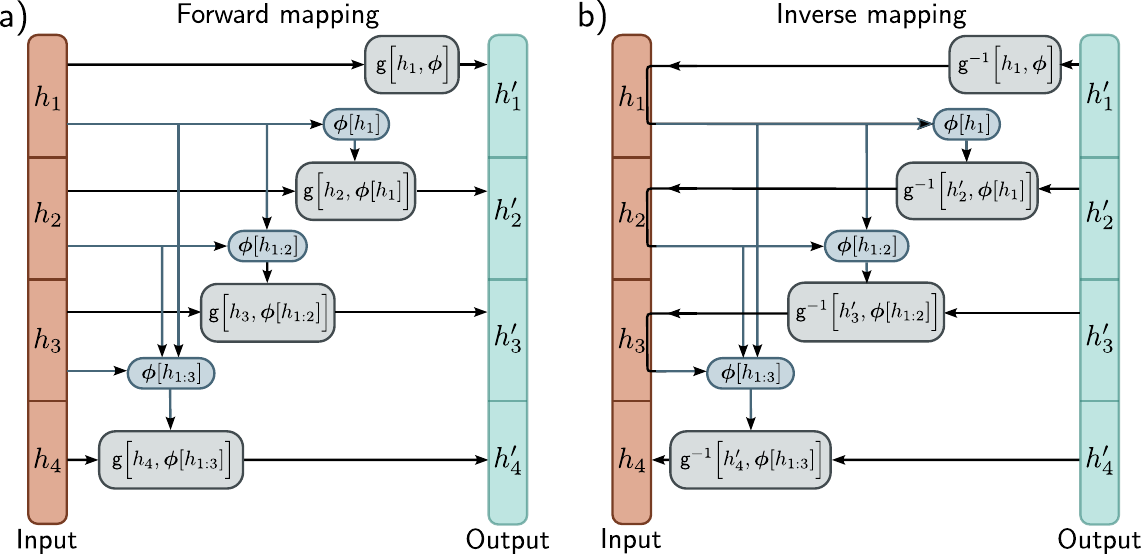
图 16.7 自回归流。输入
(橙色列)和输出 (青色列)被分成各个维度(此处四个维度)。a) 输出 是输入 的可逆变换。输出 是输入 的可逆函数,其参数依赖于 。输出 是输入 的可逆函数,其参数依赖于前面的输入 和 ,依此类推。没有任何输出相互依赖,因此可以并行计算。b) 自回归流的逆使用与耦合流类似的方法计算。然而,注意计算 需要已知 ,计算 需要已知 和 ,依此类推。因此,逆不能并行计算。
16.3.5 逆自回归流
掩码自回归流在归一化(逆)方向上定义。这需要高效地评估似然,从而学习模型。然而,采样需要正向方向,其中每个变量必须在每一层顺序计算,这很慢。如果我们对正向(生成)变换使用自回归流,则采样高效,但计算似然(和训练)慢。这被称为逆自回归流(inverse autoregressive flow)。
一种允许快速学习和快速(但近似)采样的技巧是使用掩码自回归流来学习分布(教师),然后使用它来训练一个逆自回归流(学生),我们可以从中高效采样。这需要一种不同的归一化流公式,即从另一个函数而不是样本集合中学习(见第 16.5.3 节)。
16.3.6 残差流:iRevNet
残差流(residual flows)从残差网络中获取灵感。它们将输入分为两部分
其中
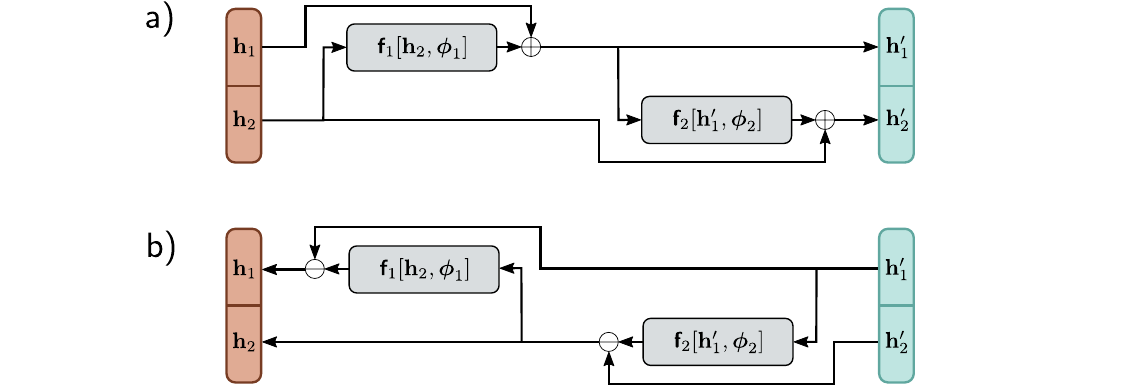
图 16.8 残差流。a) 通过将输入分为
和 并创建两个残差层来计算可逆函数。在第一层中, 被处理并加到 上。在第二层中,结果被处理并加到 上。b) 在反向机制中,函数以相反顺序计算,加法操作变为减法。
与耦合流一样,分块限制了可表示的变换族。因此,输入在层之间被置换,使得变量可以以任意方式混合。
这种公式容易求逆,但对于一般函数
16.3.7 残差流与收缩映射:iResNet
利用残差网络的另一种方法是利用 Banach 不动点定理(Banach fixed point theorem)或收缩映射定理(contraction mapping theorem),它指出每个收缩映射都有一个不动点。收缩映射
其中
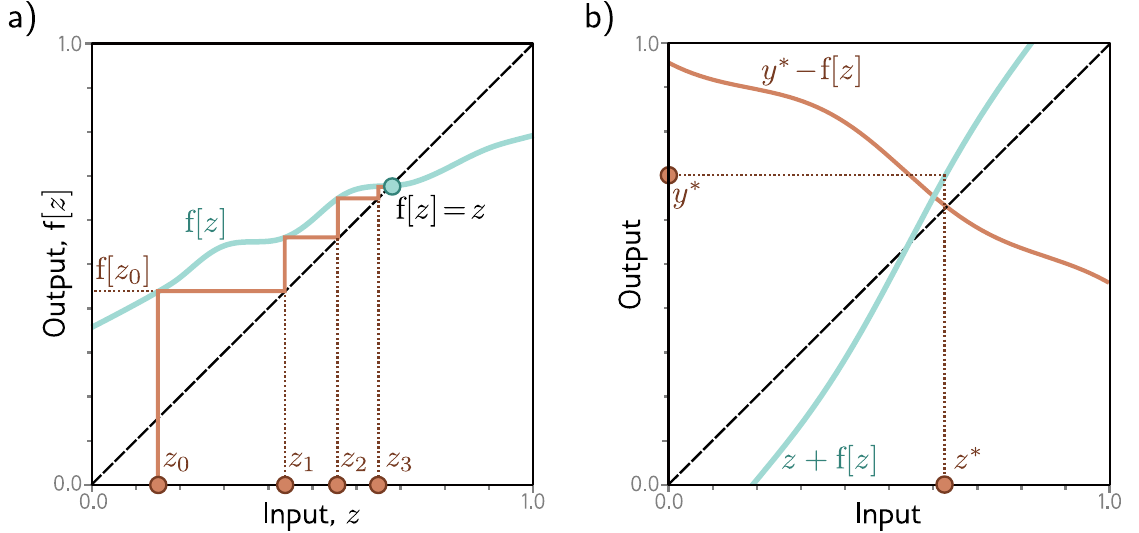
图 16.9 收缩映射。如果函数处处的绝对斜率小于一,则迭代该函数会收敛到不动点
。a) 从 开始,我们评估 。然后将 传回函数并迭代。最终,过程收敛到 的点(即函数与虚线对角恒等线交叉处)。b) 这可以用来对给定值 求解形如 的方程的逆,方法是注意 的不动点(橙色线与虚线对角恒等线交叉处)与 的位置相同。
该定理可以用来求解形如
同样的原理可以用来求解形如
Jacobian 行列式不能直接计算,但其对数可以用一系列技巧来近似:
其中我们在第一行使用了恒等式
即使截断这个级数,计算各组成部分的迹(trace)仍然计算量很大。因此,我们使用 Hutchinson 迹估计(Hutchinson's trace estimator)来近似。考虑均值为
其中第一行成立是因为
通过这种方式,我们可以近似 Taylor 展开(公式 16.22)中幂次的迹,并评估对数概率。
16.4 多尺度流
在归一化流中,潜空间
在生成方向上,多尺度流将潜向量分区为
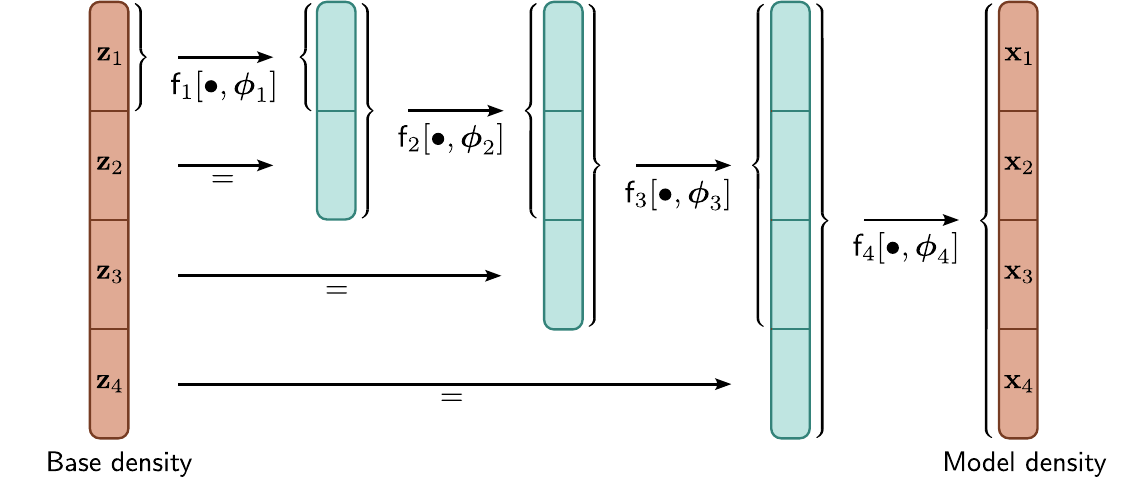
图 16.10 多尺度流。归一化流中潜空间
必须与模型密度大小相同。然而,它可以被分成几个组件,在不同层逐步引入。这使得密度估计和采样都更快。对于逆过程,黑色箭头反转,每个块的最后部分跳过剩余处理。例如, 只在前三个块上操作,第四个块成为 并与基础密度进行评估。
16.5 应用
我们现在描述归一化流的三个应用。首先,我们考虑建模概率密度。其次,我们考虑用于合成图像的 GLOW 模型。最后,我们讨论使用归一化流来近似其他分布。
16.5.1 密度建模
在本书讨论的四种生成模型中,归一化流是唯一能精确计算新样本对数似然的模型。生成对抗网络不是概率性的,而变分自编码器和扩散模型都只能返回似然的下界。图 16.11 展示了使用 i-ResNet 在两个玩具问题上估计的概率分布。密度估计的一个应用是异常检测;使用归一化流模型描述干净数据集的数据分布。低概率的新样本被标记为异常值。然而,需要注意的是,可能存在具有高概率但不落在典型集中的异常值(见图 8.13)。
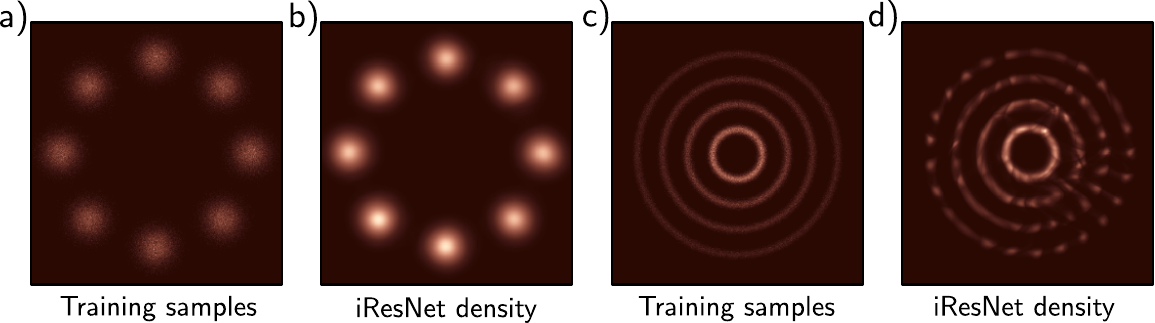
图 16.11 密度建模。a) 玩具二维数据样本。b) 使用 iResNet 建模的密度。c-d) 第二个示例。改编自 Behrmann et al. (2019)。
16.5.2 合成
生成流(generative flows)或 GLOW 是一种归一化流模型,可以创建高保真度的图像(图 16.12),使用了本章中的许多思想。它最容易从归一化方向理解。GLOW 从包含 RGB 图像的
分辨率周期性地通过将每个
为了采样更逼真的图像,GLOW 模型从提升到正幂次的基础密度中采样。这选择更靠近密度中心而非尾部的样本。这类似于 GAN 中的截断技巧(图 15.10)。值得注意的是,样本不如 GAN 或扩散模型的好。目前尚不清楚这是由于与可逆层相关的根本限制,还是仅仅因为在此方向上投入的研究较少。
图 16.13 展示了使用 GLOW 进行插值的示例。两个潜向量通过在归一化方向上变换两幅真实图像来计算。这些潜向量之间的中间点通过线性插值计算,然后使用网络在生成方向上投射回图像空间。结果是一组在两张真实图像之间逼真插值的图像。
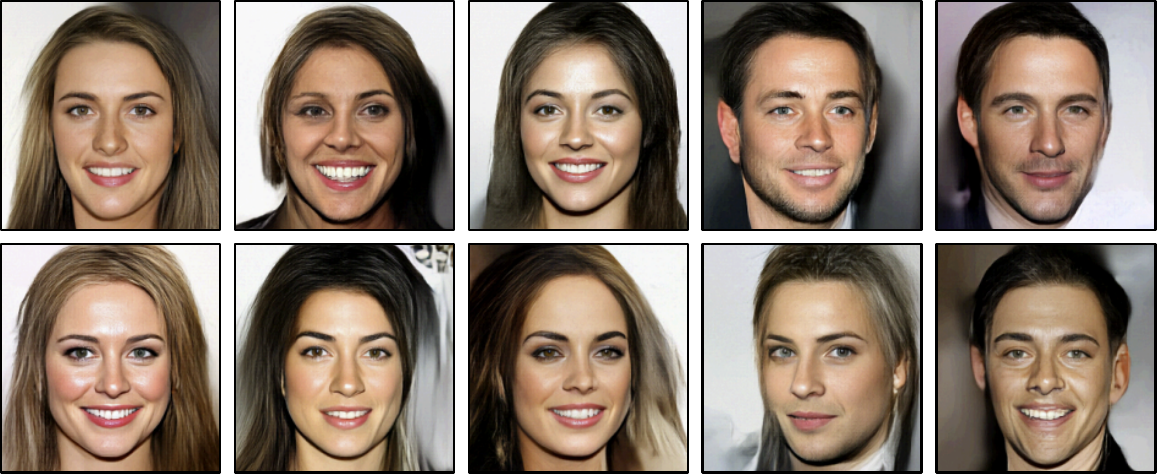
图 16.12 在 CelebA HQ 数据集(Karras et al., 2018)上训练的 GLOW 的样本。样本质量尚可,尽管 GAN 和扩散模型能产生更好的结果。改编自 Kingma & Dhariwal (2018)。
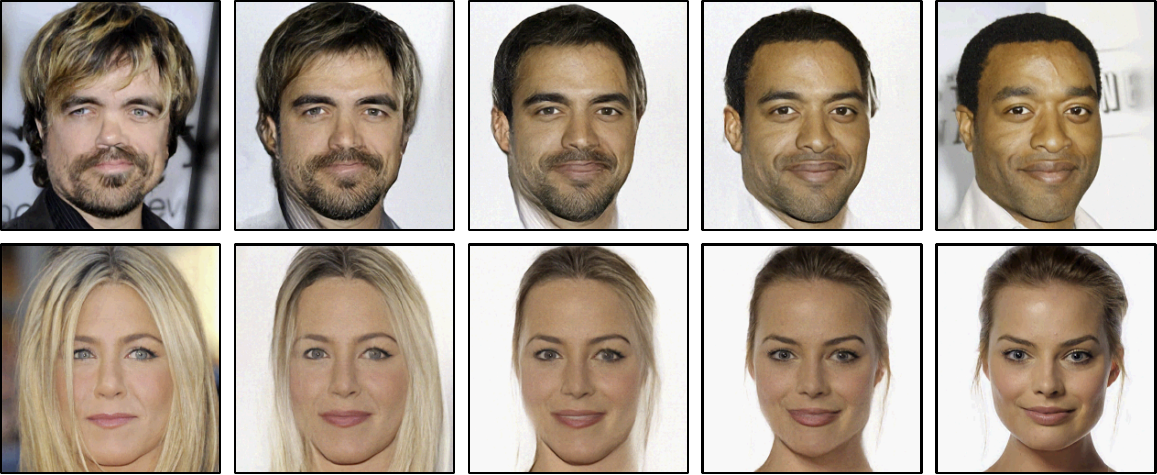
图 16.13 使用 GLOW 模型的插值。左右图像是真实人物。中间图像通过将真实图像投射到潜空间、进行插值、然后将插值点投射回图像空间来计算。改编自 Kingma & Dhariwal (2018)。
16.5.3 近似其他密度模型
归一化流还可以学习生成近似于易于评估但难以采样的现有密度的样本。在这个场景中,我们将归一化流
为此,我们从学生中生成样本
这与归一化流的典型用法形成对比,典型用法是基于来自未知分布的样本
归一化流可以使用这个技巧来建模 VAE 中的后验分布(见第 17 章)。
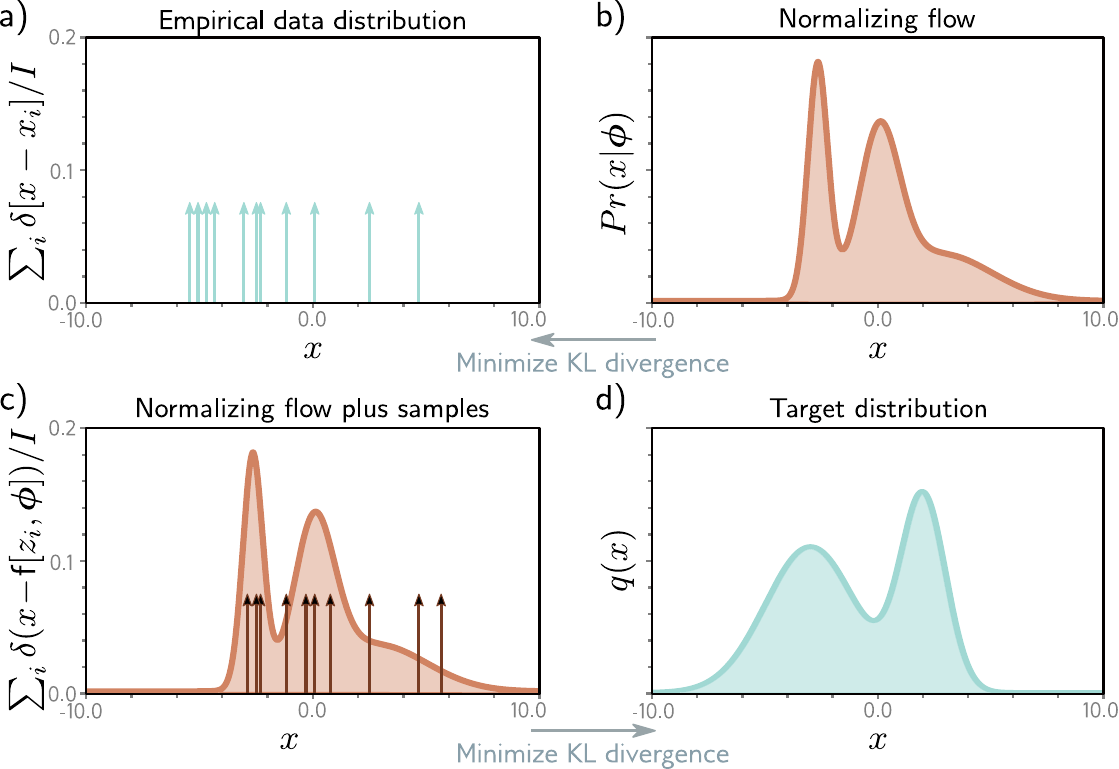
图 16.14 近似密度模型。a) 训练数据。b) 通常,我们修改流模型参数以最小化从训练数据到流模型的 KL 散度。这等价于最大似然拟合(第 5.7 节)。c) 或者,我们可以修改流参数
以最小化从流样本 到 d) 目标密度的 KL 散度。
16.6 总结
归一化流将基础分布(通常是正态分布)变换为新的密度。它们的优势在于既能精确评估样本的似然,又能生成新样本。然而,它们有架构约束:每一层必须是可逆的;我们需要正向变换来生成样本,反向变换来评估似然。
高效评估 Jacobian 以计算似然也很重要;这在学习密度时必须反复进行。然而,可逆层即使在无法高效估计 Jacobian 时也有其自身的用处;它们将训练
本章回顾了可逆网络层或流。我们考虑了线性流和逐元素流,它们简单但表达能力不足。然后我们描述了更复杂的流,如耦合流、自回归流和残差流。最后,我们展示了归一化流如何用于估计似然、生成和在图像之间插值,以及近似其他分布。