
第15章 生成对抗网络
生成对抗网络(generative adversarial network)或 GAN 是一种无监督模型,旨在生成与训练样本不可区分的新样本。GAN 只是创建新样本的机制;它们不构建数据上的概率分布,因此无法评估新数据点属于同一分布的概率。
在 GAN 中,主要的生成器(generator)网络通过将随机噪声映射到输出数据空间来创建样本。如果第二个判别器(discriminator)网络无法区分生成样本和真实样本,则样本必然是合理的。如果该网络能够区分差异,则提供了一个训练信号,可以反馈回来改善样本质量。这个想法很简单,但训练 GAN 是困难的:学习算法可能不稳定,而且虽然 GAN 可能学会生成逼真的样本,但这并不意味着它们学会了生成所有可能的样本。
GAN 已被应用于多种类型的数据,包括音频、3D 模型、文本、视频和图。然而,它们在图像领域取得了最大的成功,能够生成与真实照片几乎不可区分的样本。因此,本章的示例集中于合成图像。
15.1 判别作为信号
我们的目标是生成新样本
相似性可以用多种方式定义,但 GAN 使用的原则是样本应该在统计上与真实数据不可区分。为此,引入第二个带参数
图 15.1 说明了这一方案。我们从一组真实的一维样本
其中潜变量
在初始化时,
我们交替更新判别器和生成器。图 15.1b-c 展示了这个过程的两次迭代。分类数据逐渐变得更困难,因此改变
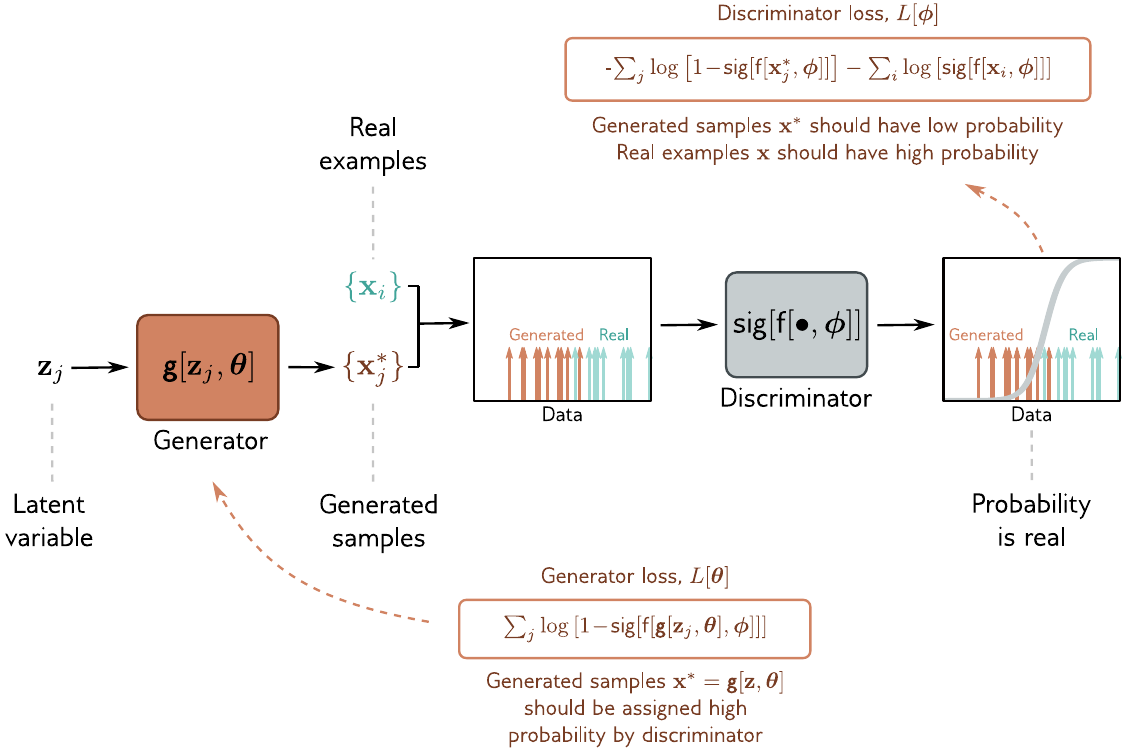
图 15.1 GAN 机制。a) 给定一个参数化函数(生成器),合成样本(橙色箭头)和一批真实样本(青色箭头),我们训练判别器来区分真实样本和生成样本(sigmoid 曲线表示数据点为真实的估计概率)。b) 通过修改生成器参数使判别器对样本是否合成变得不确定(在此例中,将橙色样本向右移动)来训练生成器。然后更新判别器。c) 对生成器和判别器的交替更新使生成样本变得与真实样本不可区分,改变生成器的驱动力(即 sigmoid 函数的斜率)逐渐减小。
15.1.1 GAN 损失函数
我们现在更精确地定义训练 GAN 的损失函数。判别器
其中
在本例中,我们假设真实样本
其中
现在我们代入生成器的定义
15.1.2 训练 GAN
公式 15.4 是一个比我们之前见过的更复杂的损失函数;判别器参数
为了训练 GAN,我们可以将公式 15.4 分为两个损失函数:
其中我们将第二个函数乘以负一以转换为最小化问题,并去掉了不依赖于
在每一步中,我们从基础分布中抽取一批潜变量
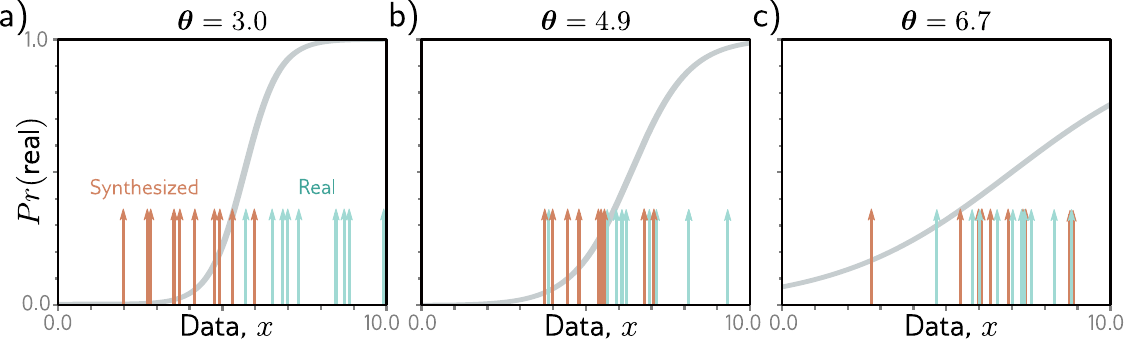
图 15.2 GAN 损失函数。潜变量
从基础分布中抽取,并通过生成器创建样本 。一批样本 和一批真实样本 被传递给判别器,判别器为每个样本分配一个为真实的概率。判别器参数 被修改以对真实样本赋予高概率、对生成样本赋予低概率。生成器参数 被修改以"欺骗"判别器,使其对生成样本赋予高概率。
15.1.3 深度卷积 GAN
深度卷积 GAN(deep convolutional GAN)或 DCGAN 是一种早期专门用于生成图像的 GAN 架构(图 15.3)。生成器
训练完成后,判别器被丢弃。为了创建新样本,从基础分布中抽取潜变量
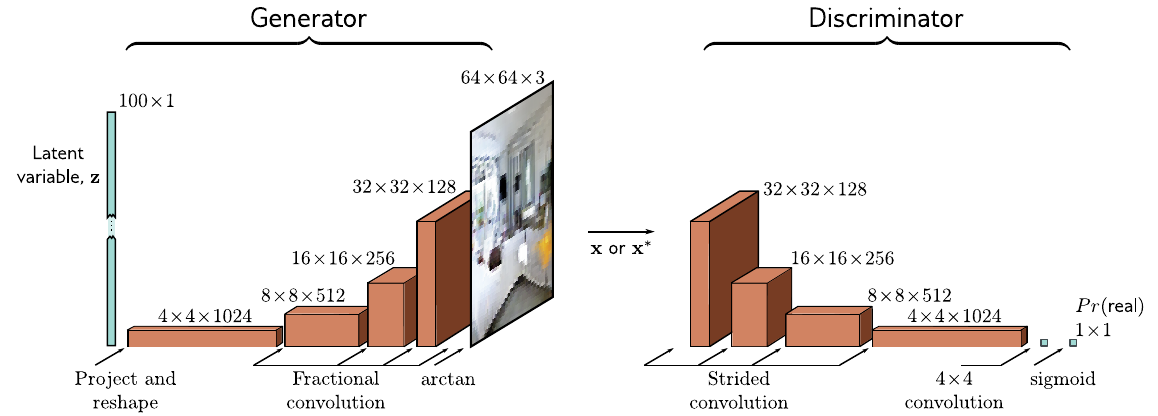
图 15.3 DCGAN 架构。在生成器中,100 维潜变量
从均匀分布中抽取,通过线性变换映射为具有 1024 个通道的 表示。然后通过一系列卷积层逐步上采样表示并减少通道数。最后是一个 tanh 函数,将 的表示映射到固定范围以表示图像。判别器由标准卷积网络组成,将输入分类为真实样本或生成样本。
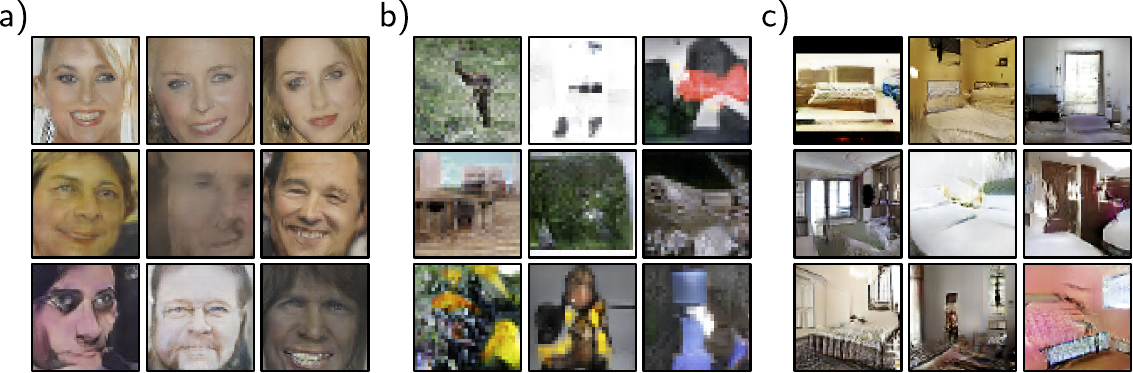
图 15.4 DCGAN 模型合成的图像。a) 在人脸数据集上训练的 DCGAN 的随机样本。b) 使用 ImageNet 数据库的随机样本(见图 10.15)。c) 从 LSUN 场景理解数据集中抽取的随机样本。改编自 Radford et al. (2015)。
15.1.4 训练 GAN 的困难
理论上,GAN 相当简单。然而,GAN 训练起来是出了名地困难。例如,要让 DCGAN 可靠地训练,需要 (i) 在生成器和判别器中都使用步长卷积进行上采样和下采样;(ii) 除了生成器的最后一层和判别器的第一层外,都使用 BatchNorm;(iii) 在判别器中使用 leaky ReLU 激活函数(图 3.13);(iv) 使用 Adam 优化器但动量系数比通常更低。这是不寻常的。大多数深度学习模型对这类选择相对鲁棒。
一个常见的失败模式是生成器产生看似合理的样本,但这些样本只代表数据的一个子集(例如,对于人脸,它可能永远不会生成有胡须的面孔)。这被称为模式丢失(mode dropping)。一个极端版本是生成器完全或基本上忽略潜变量
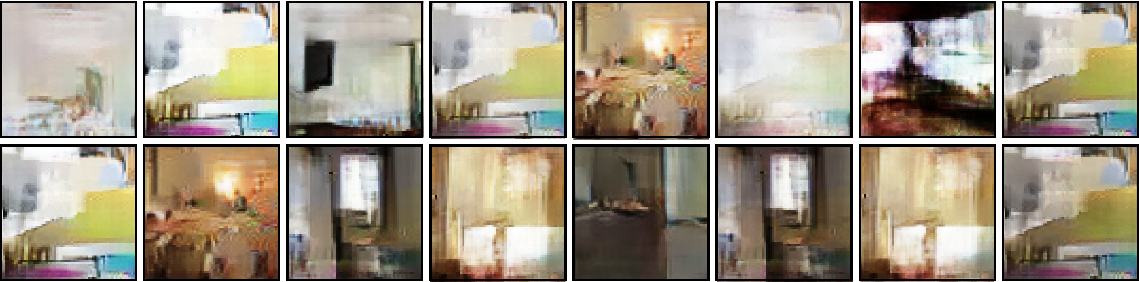
图 15.5 模式坍缩。在 LSUN 场景理解数据集上使用与 DCGAN 具有相似参数数量和层数的 MLP 生成器训练的 GAN 合成的图像。样本质量很低,且许多样本相似。改编自 Arjovsky et al. (2017)。
15.2 提高稳定性
要理解为什么 GAN 难以训练,有必要确切地理解损失函数代表什么。
15.2.1 GAN 损失函数的分析
如果我们将公式 15.5 第一行中的两个求和分别除以真实样本数
其中
当
其中在右侧,我们将
忽略加法和乘法常数,这就是合成分布
其中
第一项表明,如果在样本密度
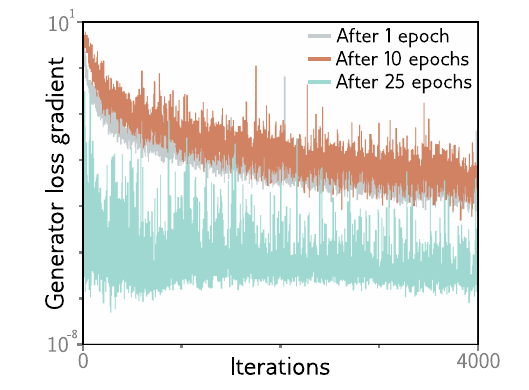
图 15.6 GAN 损失函数的问题。如果生成样本(橙色箭头)容易与真实样本(青色箭头)区分,则判别器(sigmoid)在样本位置处的斜率可能非常小;因此,更新生成器参数的梯度可能很小。
15.2.2 梯度消失
在上一节中,我们看到当判别器最优时,损失函数最大化生成样本和真实样本之间分布的距离度量。然而,使用概率分布之间的距离作为优化 GAN 的准则存在一个潜在问题。如果概率分布完全不相交,这个距离就是最大的,生成器的任何微小变化都不会减少损失。当我们考虑原始公式时也能看到同样的现象;如果判别器能完美地分离生成样本和真实样本,则对生成数据的微小改变不会改变分类得分(图 15.6)。
不幸的是,生成样本和真实样本的分布可能确实是不相交的;生成样本位于一个子空间中,该子空间的大小与潜变量
图 15.7 提供了支持这一假说的经验证据。如果冻结 DCGAN 生成器并反复更新判别器以改善其分类性能,生成器的梯度会下降。简而言之,判别器和生成器的质量之间存在非常微妙的平衡;如果判别器变得太好,生成器的训练更新就会被削弱。
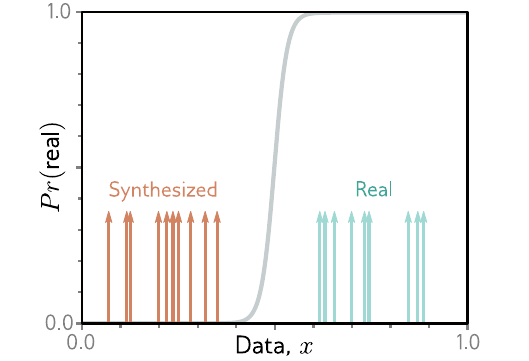
图 15.7 DCGAN 生成器中的梯度消失。生成器在 1、10 和 25 个 epoch 后被冻结,判别器继续训练。生成器的梯度迅速下降(注意对数刻度);如果判别器变得太精确,生成器的梯度就会消失。改编自 Arjovsky & Bottou (2017)。
15.2.3 Wasserstein 距离
前面几节表明 (i) GAN 损失可以解释为概率分布之间的距离,(ii) 当生成样本太容易与真实样本区分时,该距离的梯度变为零。显而易见的前进方向是选择具有更好性质的距离度量。
Wasserstein 距离或(对于离散分布)推土机距离(earth mover's distance)是将概率质量从一个分布传输到另一个分布以创建后者所需的工作量。这里,"工作"定义为质量乘以移动距离。这听起来立即更有前景;即使分布不相交,Wasserstein 距离也是良定义的,并且随着分布相互接近而平滑下降。
15.2.4 离散分布的 Wasserstein 距离
Wasserstein 距离最容易通过离散分布来理解(图 15.8)。考虑定义在
Wasserstein 距离定义为:
服从约束条件:
换言之,Wasserstein 距离是将一个分布的质量映射到另一个分布的约束最小化问题的解。这不太方便,因为每次我们想计算距离时都必须对元素
其中
与所有线性规划问题一样,存在一个具有相同解的等价对偶问题(dual problem)。这里,我们关于应用于初始分布的变量
服从约束条件:
换言之,我们对一组新变量
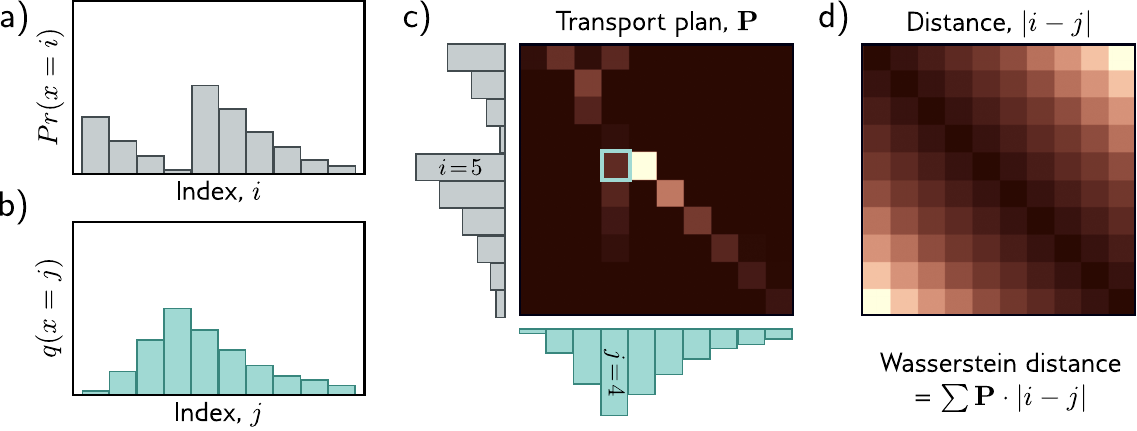
图 15.8 Wasserstein 或推土机距离。a) 考虑离散分布
。b) 我们希望移动概率质量以创建目标分布 。c) 传输计划 标识将从 移动多少质量到 。例如,青色高亮方块 表示将从 移动到 的质量。传输计划的元素必须非负,对 的求和必须为 ,对 的求和必须为 。因此 是一个联合概率分布。d) 元素 和 之间的距离矩阵。最优传输计划 最小化 和距离矩阵的逐元素乘积之和(称为 Wasserstein 距离)。因此, 的元素倾向于靠近对角线(距离代价最低处)分布。改编自 Hermann (2017)。
15.2.5 连续分布的 Wasserstein 距离
将这些结果推广到连续多维情形,原始形式(公式 15.10)的等价物为:
服从与公式 15.11 类似的约束条件,其中传输计划
服从约束条件:函数
15.2.6 Wasserstein GAN 损失函数
在神经网络的背景下,我们通过优化神经网络
其中我们必须约束神经网络判别器
实现这一点的一种方法是将判别器权重裁剪到一个小范围内(例如
15.3 渐进式生长、小批量判别和截断
Wasserstein 公式使 GAN 训练更加稳定。然而,生成高质量图像需要更多的技术。我们现在回顾渐进式生长(progressive growing)、小批量判别(minibatch discrimination)和截断(truncation),它们都能改善输出质量。
在渐进式生长中(图 15.9),我们首先训练一个合成
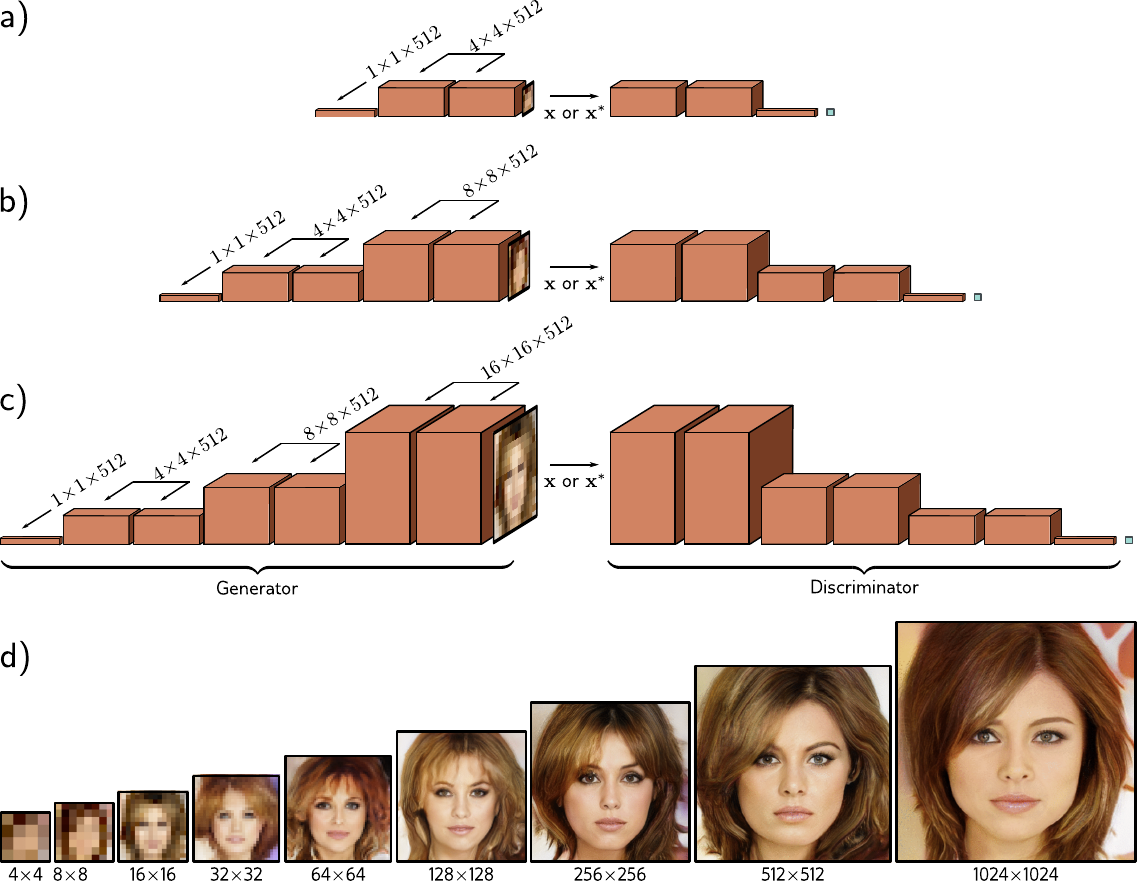
图 15.9 渐进式生长。a) 生成器最初被训练创建非常小的
图像,判别器识别这些图像是合成的还是下采样的真实图像。b) 在这个低分辨率训练终止后,后续层被添加到生成器以生成 图像。类似的层也被添加到判别器以进行下采样。c) 这个过程继续创建 图像,依此类推。通过这种方式,可以训练出生成非常逼真的高分辨率图像的 GAN。d) 从同一潜变量在不同阶段生成的递增分辨率的图像。改编自 Wolf (2021),使用 Karras et al. (2018) 的方法。
小批量判别确保样本具有足够的多样性,从而有助于防止模式坍缩。这可以通过计算合成数据和真实数据的小批量上的特征统计量来实现。这些统计量可以被总结并作为特征图添加(通常在判别器末端附近)。这允许判别器向生成器发送信号,鼓励合成数据中包含与原始数据集中类似的变化量。
另一个改善生成效果的技巧是截断(truncation,图 15.10),即在采样时只选择高概率(即接近均值)的潜变量
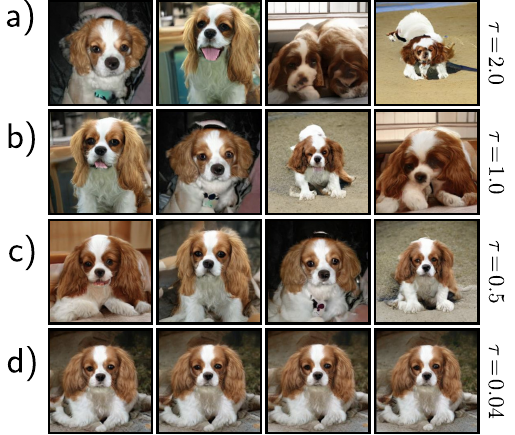
图 15.10 截断。通过拒绝距均值超过
个标准差的潜变量 的样本,可以在 GAN 样本的质量和多样性之间进行权衡。a) 如果阈值较大( ),样本视觉上多样但可能有缺陷。b-c) 随着阈值降低,平均视觉质量提高,但多样性下降。d) 阈值非常小时,样本看起来几乎相同。通过巧妙选择该阈值,可以提高 GAN 结果的平均质量。改编自 Brock et al. (2019)。
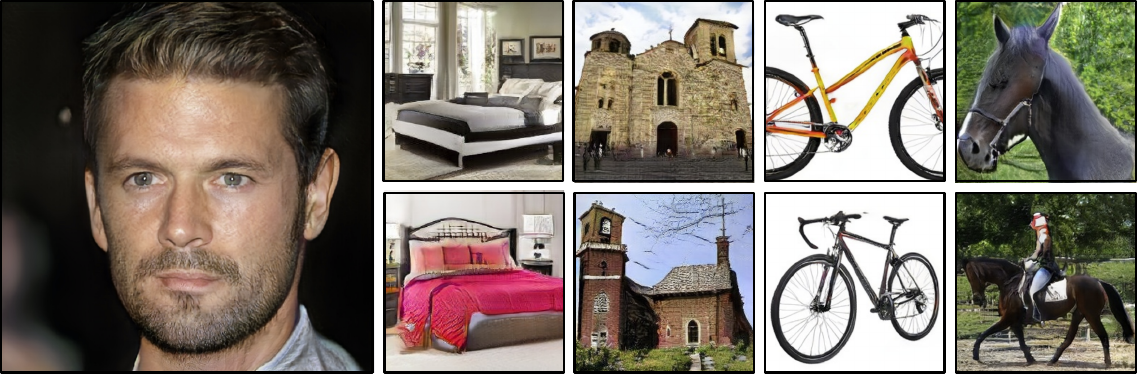
图 15.11 方法组合。在 CELEBA-HQ 数据集上训练时,GAN 可以生成逼真的人脸图像,在 LSUN 类别上训练时可以生成更复杂、更多变的物体。改编自 Karras et al. (2018)。
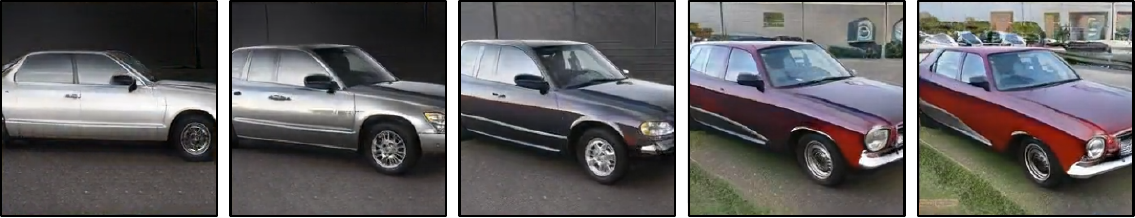
图 15.12 遍历渐进式 GAN 在 LSUN 汽车上训练的潜空间。在潜空间中移动产生平滑变化的汽车图像。这通常只在短轨迹上有效;最终,潜变量会移动到产生不逼真图像的位置。改编自 Karras et al. (2018)。
15.4 条件生成
GAN 生成逼真的图像,但不指定其属性:我们无法选择发色、种族或年龄,也无需为每种特征组合训练单独的 GAN。条件生成(conditional generation)模型为我们提供了这种控制能力。
15.4.1 条件 GAN
条件 GAN(conditional GAN)将属性向量
对于生成器,属性
15.4.2 辅助分类器 GAN
辅助分类器 GAN(auxiliary classifier GAN)或 ACGAN 通过要求判别器正确预测属性来简化条件生成(图 15.13b)。对于具有
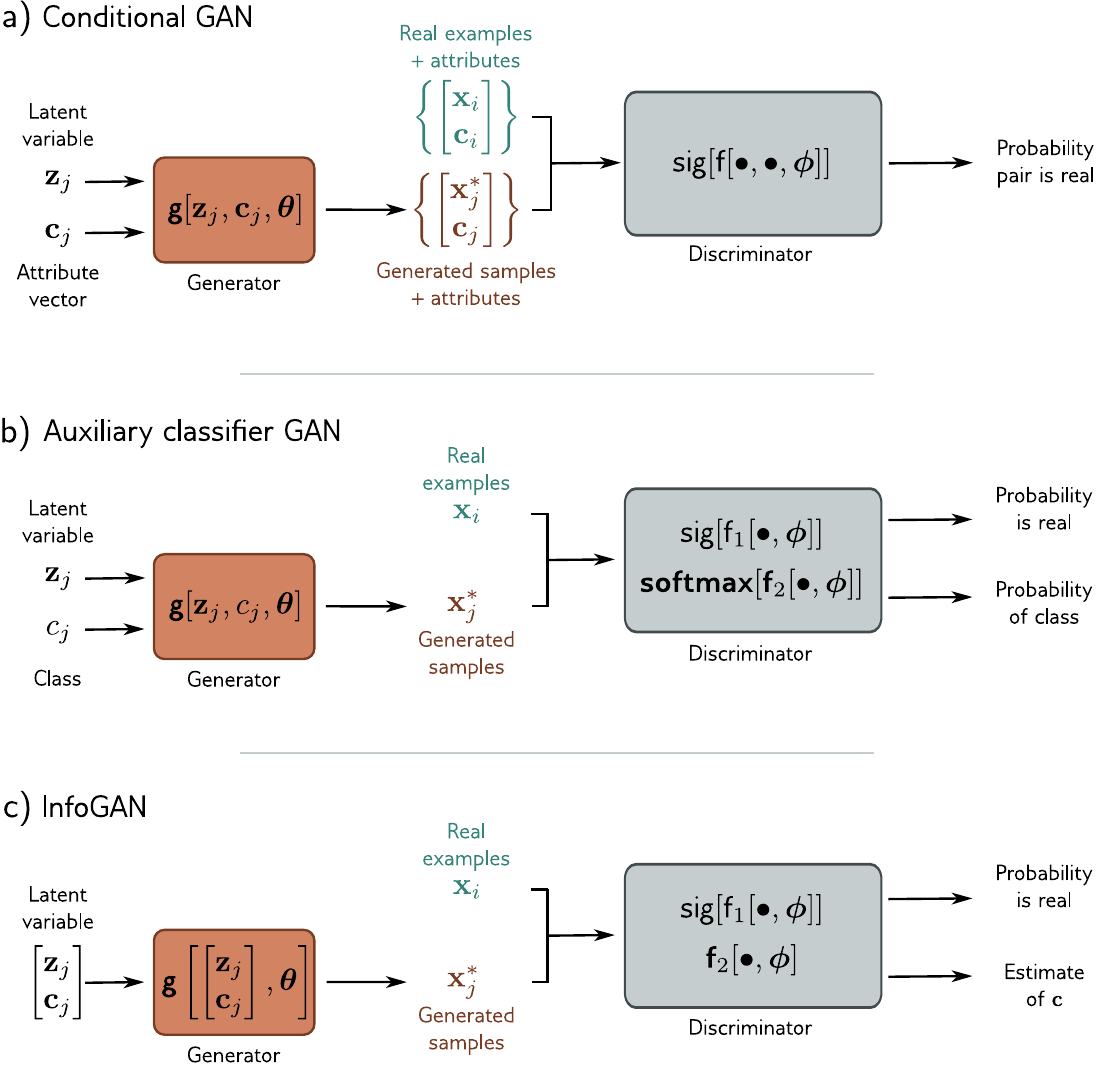
图 15.13 条件生成。a) 条件 GAN 的生成器还接收描述图像某些方面的属性向量
。和往常一样,判别器接收真实样本或生成样本,但现在它也接收属性向量;这鼓励样本既逼真又与属性兼容。b) 辅助分类器 GAN (ACGAN) 的生成器接受离散属性变量。判别器必须同时 (i) 确定其输入是真实的还是合成的,以及 (ii) 正确识别类别。c) InfoGAN 将潜变量分为噪声 和未指定的随机属性 。判别器必须区分其输入是否为真实的,并重建这些属性。在实践中,这意味着变量 对应于数据具有现实世界可解释性的显著方面(即潜空间是解缠的)。
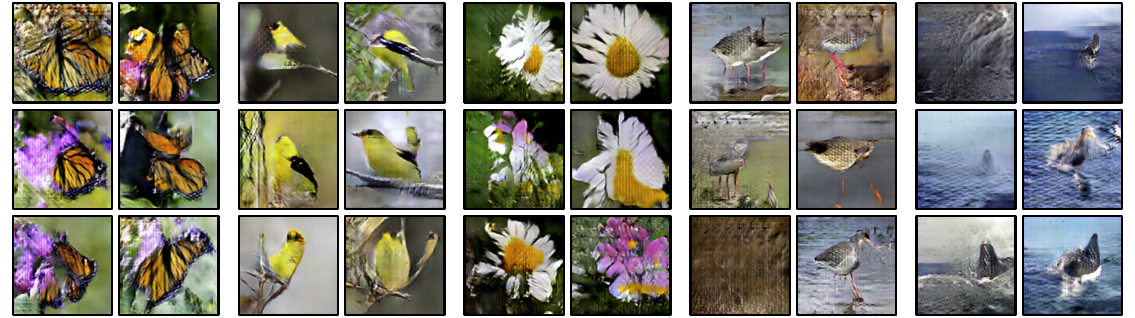
图 15.14 辅助分类器 GAN。生成器接受类别标签和潜变量。判别器必须同时识别数据点是否真实且预测类别标签。该模型在十个 ImageNet 类别上训练。从左到右:帝王蝶、金翅雀、雏菊、红脚鹬和灰鲸的生成示例。改编自 Odena et al. (2017)。
15.4.3 InfoGAN
条件 GAN 和 ACGAN 都生成具有预定属性的样本。相比之下,InfoGAN(图 15.13c)尝试自动识别重要属性。生成器接受由随机噪声变量
其洞察在于,可解释的现实世界特征应该最容易预测,因此会被表示在属性变量
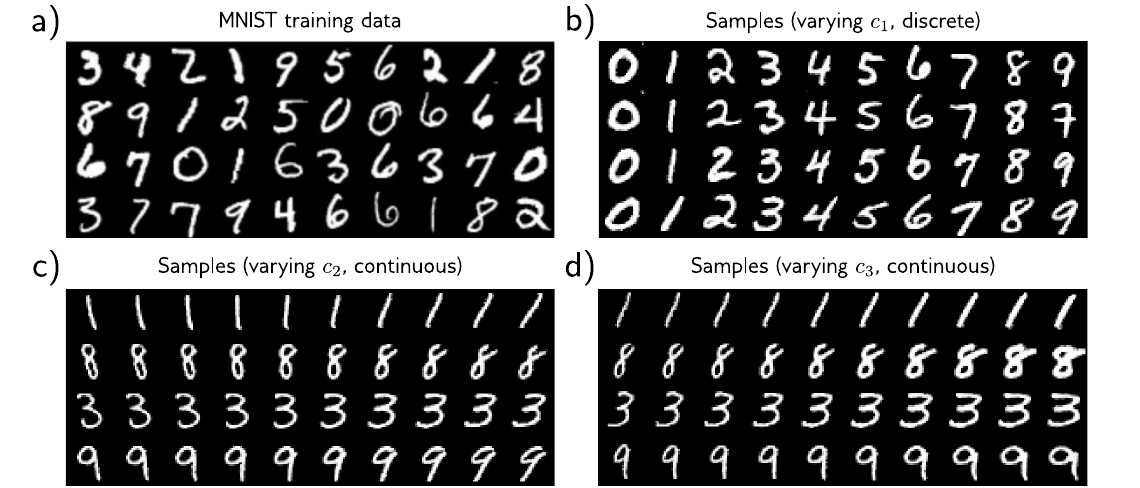
图 15.15 InfoGAN 用于 MNIST。a) MNIST 数据库的训练样本,由
像素的手写数字图像组成。b) 第一个属性 是离散的,有 10 个类别;每列展示用其中一个类别生成的样本。InfoGAN 恢复了十个数字。属性向量 和 是连续的。c) 从左到右,每列代表不同的 值,保持其他潜变量不变。该属性似乎对应于字符的方向。d) 第三个属性似乎对应于笔画的粗细。改编自 Chen et al. (2016b)。
15.5 图像翻译
虽然对抗判别器最初是在 GAN 的场景中用于生成随机样本,但它也可以用作在将一个数据示例翻译为另一个的任务中偏向真实性的先验。这最常见于图像,比如将灰度图像翻译为彩色、将噪声图像翻译为干净图像、将模糊图像翻译为清晰图像,或将草图翻译为逼真照片。
本节讨论三种使用不同数量标注数据的图像翻译模型。Pix2Pix 模型使用前/后配对图像进行训练。带有对抗损失的模型使用前/后配对作为主模型,但同时利用判别器中的非配对"后"图像。CycleGAN 模型使用非配对图像。
15.5.1 Pix2Pix
Pix2Pix 模型(图 15.16)是一个网络
然而,输出图像也应该看起来像输入的逼真转换。这通过使用对抗判别器
可以将该模型理解为一个条件 GAN,其中 U-Net 是生成器,且以图像而非标签为条件。但注意,U-Net 输入不包含噪声,因此不是传统意义上的"生成器"。有趣的是,原始作者尝试过在 U-Net 输入
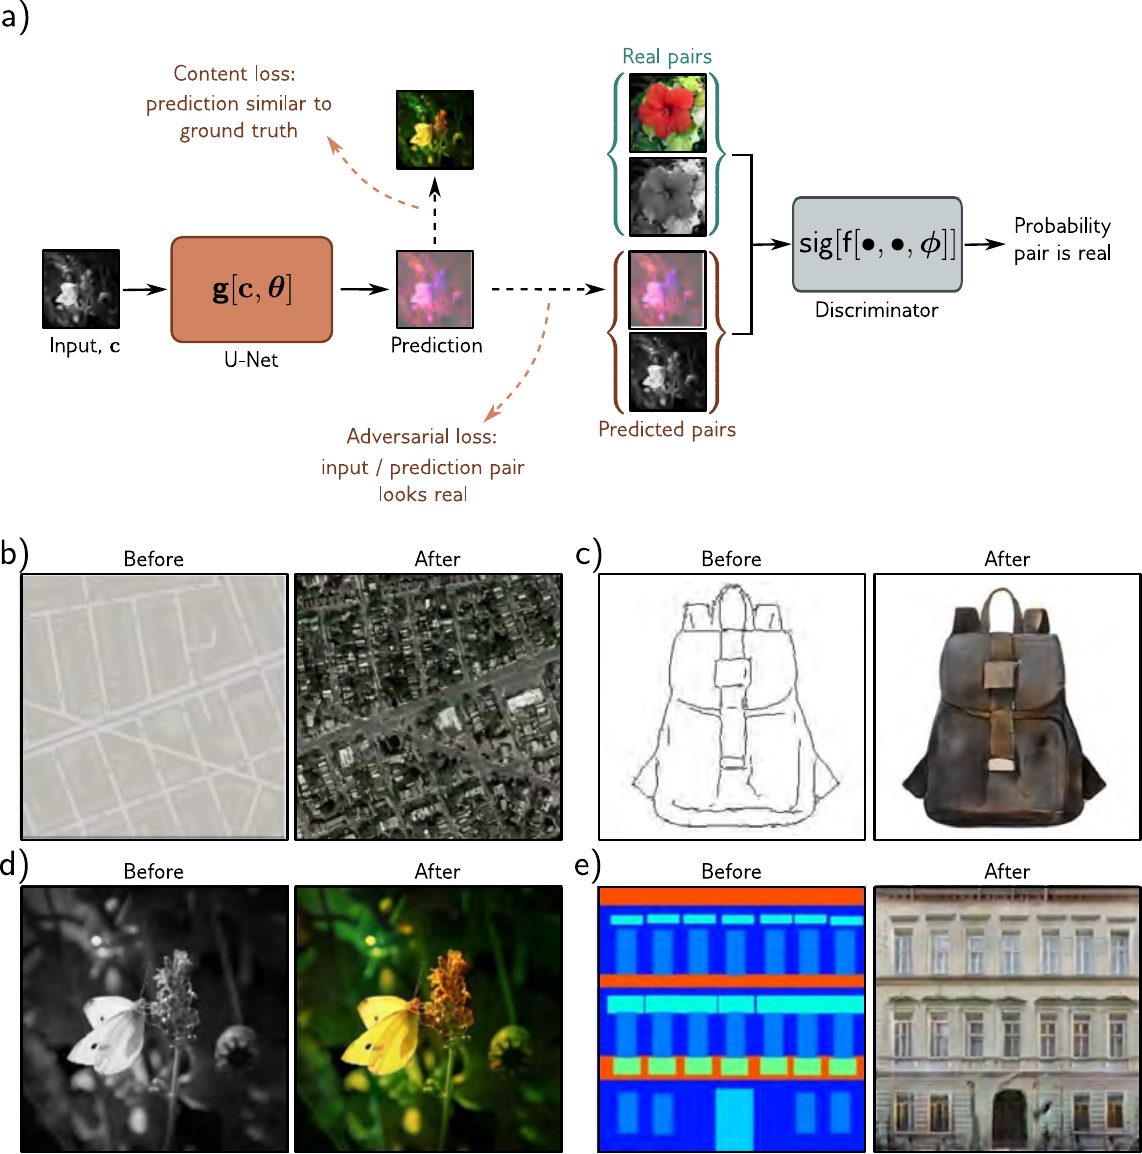
图 15.16 Pix2Pix 模型。a) 模型使用 U-Net(见图 11.10)将输入图像翻译为不同风格的预测。在此例中,将灰度图像映射为合理的彩色版本。U-Net 用两个损失训练。首先,内容损失鼓励输出图像与输入图像具有相似的结构。其次,对抗损失鼓励灰度/彩色图像对在每个局部区域与真实配对不可区分。该框架可以适应许多任务,包括 b) 将地图翻译为卫星图像,c) 将草图转换为逼真照片,d) 着色,e) 将标签图转换为逼真的建筑立面。改编自 Isola et al. (2017)。
15.5.2 对抗损失
Pix2Pix 模型中的判别器试图区分图像翻译任务中的前/后配对是否合理。这有一个缺点:我们需要真实的前/后配对来利用判别器损失。幸运的是,有一种更简单的方法可以在监督学习中利用对抗判别器的能力,而无需额外的标注训练数据。
对抗损失(adversarial loss)在判别器能区分监督网络的输出和其输出域中的真实样本时添加惩罚。相应地,监督模型改变其预测以减小这个惩罚。这可以在整个输出的尺度上进行,也可以在补丁级别进行,如 Pix2Pix 算法。这有助于改善复杂结构化输出的真实性(realism)。然而,它不一定在原始损失函数方面带来更好的解。
超分辨率 GAN(super-resolution GAN)或 SRGAN 使用了这种方法(图 15.17)。主模型由带残差连接的卷积网络组成,接收低分辨率图像并通过上采样层将其转换为高分辨率图像。网络用三个损失训练。内容损失衡量输出和真实高分辨率图像之间的平方差。VGG 损失或感知损失(perceptual loss)将合成和真实输出通过 VGG 网络并衡量其激活之间的平方差。这鼓励图像在语义上与目标相似。最后,对抗损失使用判别器来区分这是真实的高分辨率图像还是上采样的图像。这鼓励输出与真实样本不可区分。
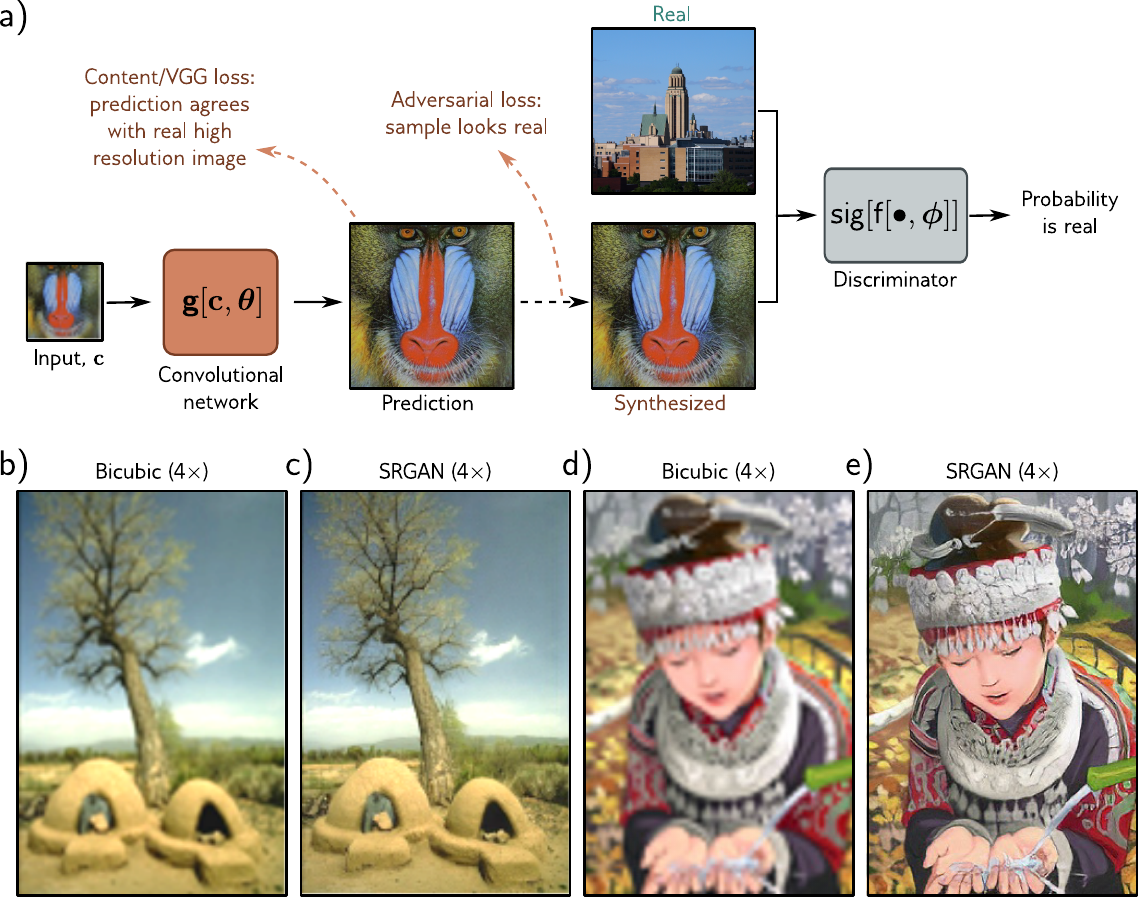
图 15.17 超分辨率生成对抗网络(SRGAN)。a) 训练带残差连接的卷积网络将图像分辨率提高四倍。模型有鼓励内容接近真实高分辨率图像的损失。然而,它还包括对抗损失,惩罚能被真实高分辨率图像区分的结果。b) 使用双三次插值上采样的图像。c) 使用 SRGAN 上采样的图像。d) 使用双三次插值上采样的图像。e) 使用 SRGAN 上采样的图像。改编自 Ledig et al. (2017)。
15.5.3 CycleGAN
对抗损失假设主监督网络有标注的前/后图像。CycleGAN 处理的是我们有两组不同风格的数据但没有匹配配对的情况。例如将照片转换为莫奈的艺术风格。存在许多照片和许多莫奈画作,但它们之间没有对应关系。CycleGAN 利用的想法是,将图像在一个方向转换(例如照片→莫奈)然后再转换回来应该恢复原始图像。
CycleGAN 的损失函数是三个损失的加权和(图 15.18)。内容损失鼓励前后图像相似,基于
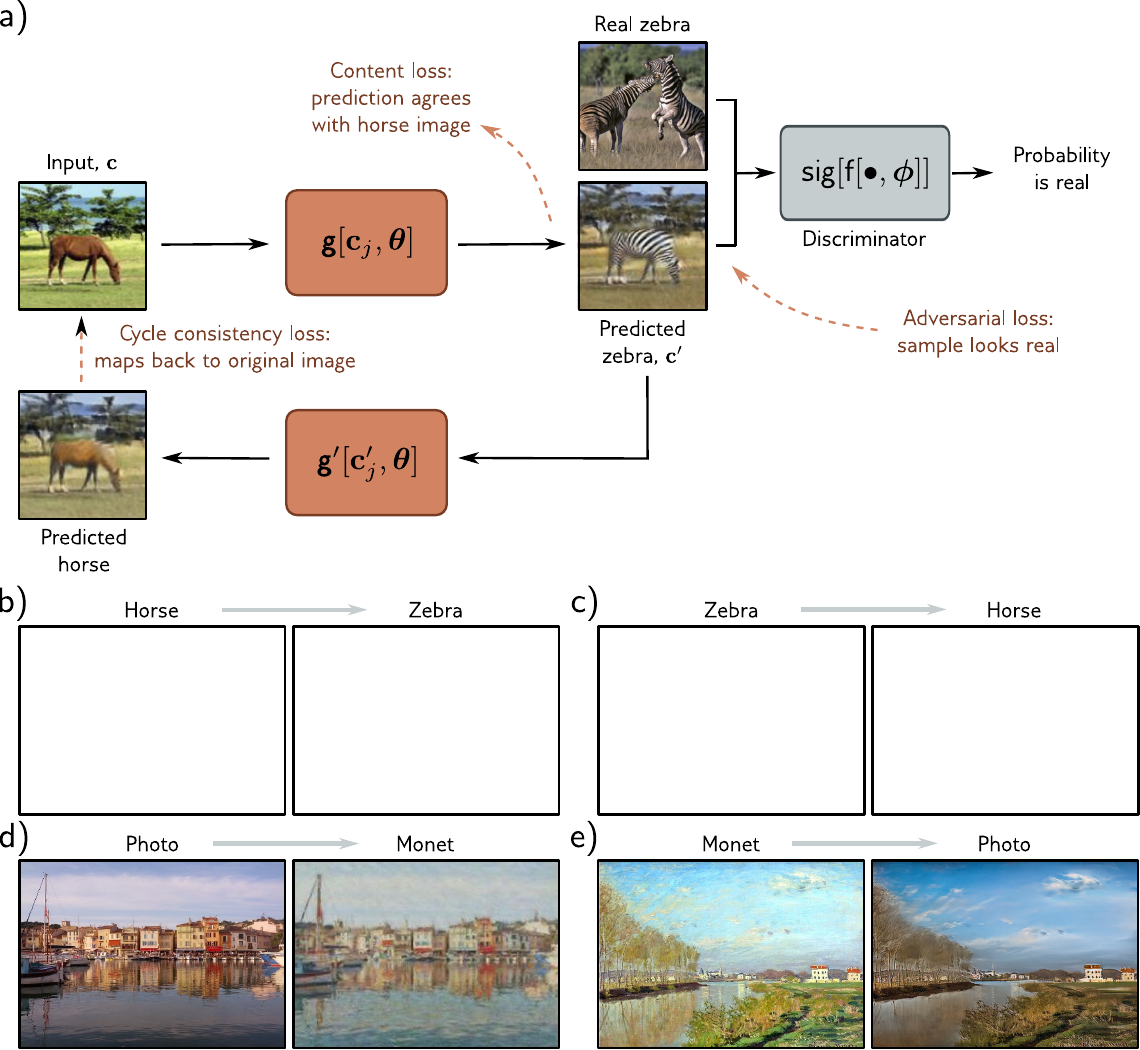
图 15.18 CycleGAN。两个模型同时训练。第一个
将第一种风格(马)的图像 翻译为第二种风格(斑马)的图像 。第二个模型 学习相反的映射。循环一致性损失惩罚两个模型不能成功地将图像转换到另一个域再转换回来的情况。此外,两个对抗损失鼓励翻译后的图像看起来像目标域的逼真样本(此处仅展示斑马方向)。两个内容损失鼓励每次映射前后图像的细节和布局相似(即斑马与马处于相同的位置和姿势,背景相同,反之亦然)。改编自 Zhu et al. (2017)。
15.6 StyleGAN
StyleGAN 是一种更现代的 GAN,它将数据集中的变化分解为有意义的组件,每个组件由潜变量的一个子集控制。特别是,StyleGAN 在不同尺度上控制输出图像,并将风格与噪声分离。对于人脸图像,大尺度变化包括脸型和头部姿势,中尺度变化包括面部特征的形状和细节,细尺度变化包括发色和肤色。风格组件代表对人类来说显著的图像方面,而噪声方面代表不重要的变化,如头发的精确位置、胡茬、雀斑或皮肤毛孔。
到目前为止我们看到的 GAN 都从一个从标准基础分布中采样的潜变量
StyleGAN 的主要生成分支从一个学习的常量
代表噪声的潜变量是独立采样的高斯向量
代表风格的潜变量从
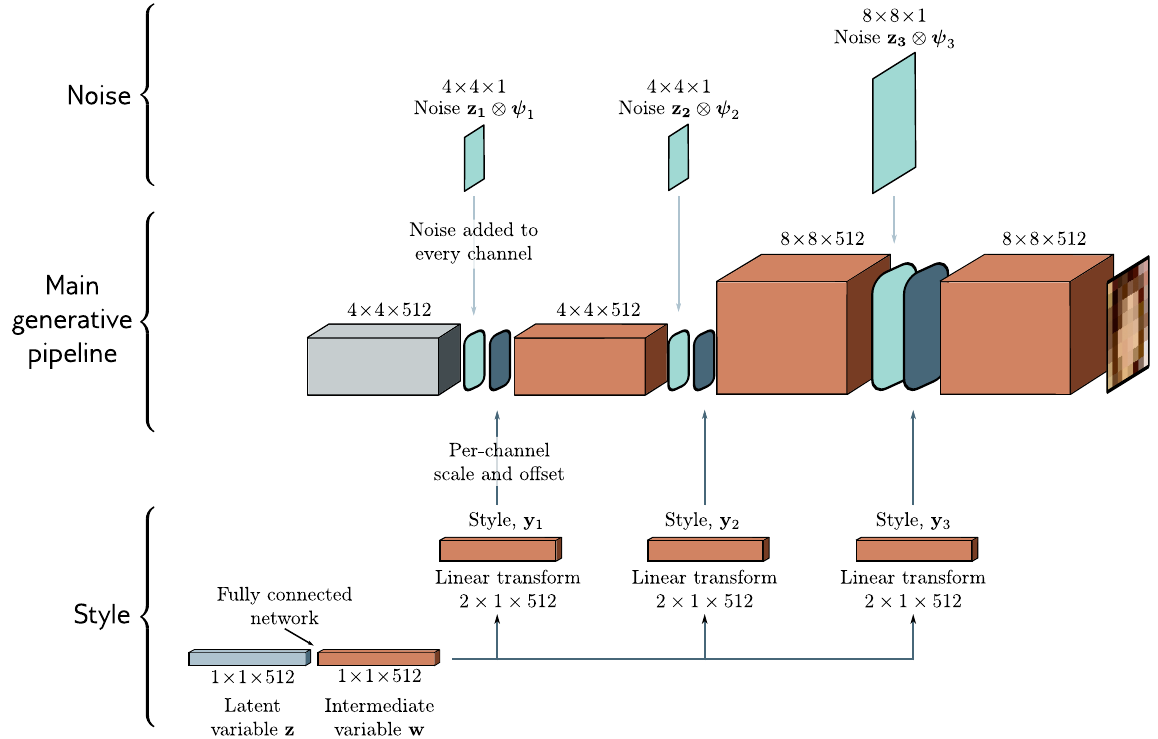
图 15.19 StyleGAN。主管道(中间行)从一个常量学习表示(灰色方框)开始。通过一系列卷积层逐步上采样以创建输出。噪声(顶行)通过周期性地添加带有逐通道缩放
的高斯变量 在不同尺度上添加。高斯风格变量 通过全连接网络创建中间变量 (底行)。它用于在管道中不同点设置每个通道的均值和方差。
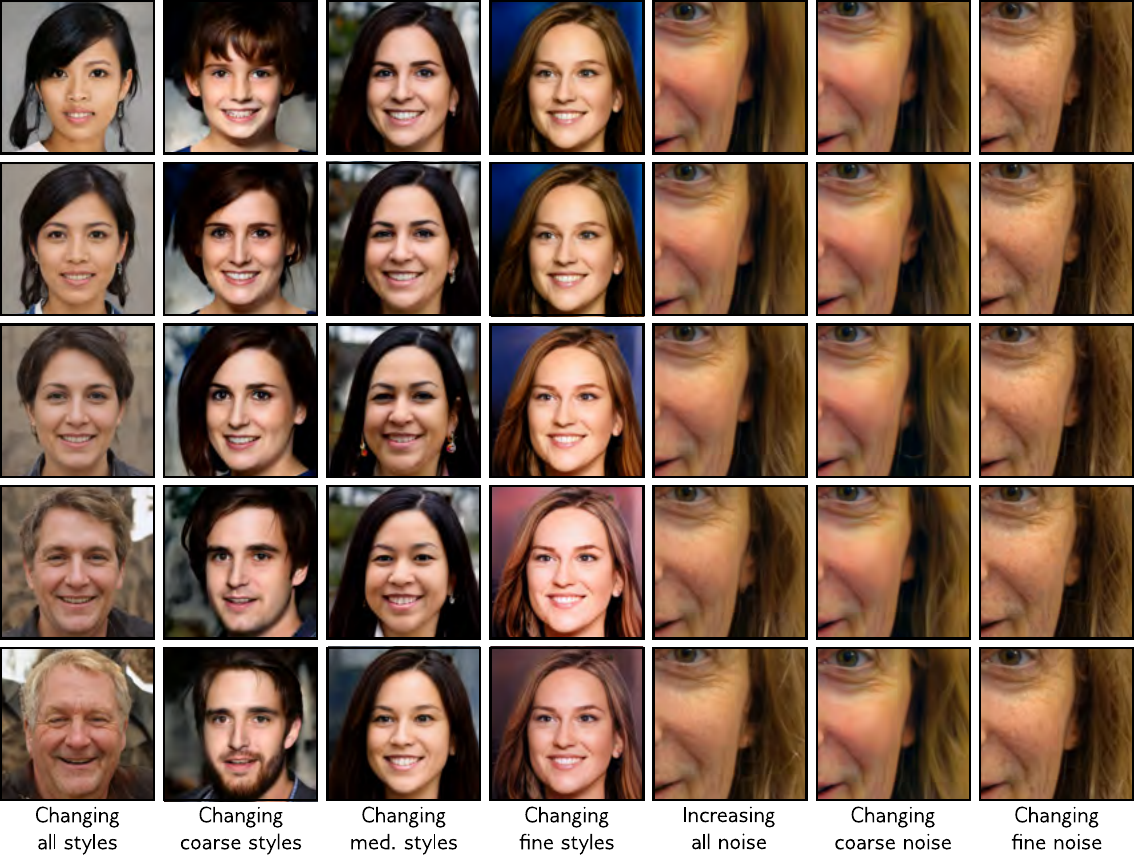
图 15.20 StyleGAN 结果。前四列展示了在不同尺度上风格的系统变化。第五列展示了增加噪声幅度的效果。最后两列展示了在两个不同尺度上使用不同噪声向量的效果。
15.7 总结
GAN 学习一个生成器网络,将随机噪声转换为与训练集不可区分的数据。为此,使用一个试图区分真实样本和生成样本的判别器网络来训练生成器。然后更新生成器,使其创建的数据被判别器识别为更"真实"的。这一想法的原始公式有一个缺陷,即当容易判断样本是真实的还是生成的时,训练信号很弱。这导致了 Wasserstein GAN,它提供了更一致的训练信号。
我们回顾了用于生成图像的卷积 GAN 以及一系列改善生成图像质量的技巧,包括渐进式生长、小批量判别和截断。条件 GAN 架构引入了一个辅助向量,允许控制输出(例如物体类别的选择)。图像翻译任务保留了图像形式的条件信息,但不使用随机噪声。GAN 判别器现在作为一个偏向"逼真"外观图像的额外损失项。最后,我们描述了 StyleGAN,它将噪声在不同尺度上策略性地注入生成器,以控制风格和噪声。