
第10章 卷积网络
第 2-9 章介绍了深度神经网络的监督学习流程。然而,这些章节仅考虑了从输入到输出具有单一路径的全连接网络。第 10-13 章将介绍更加专门化的网络组件,它们具有更稀疏的连接、共享的权重和并行的处理路径。本章描述主要用于处理图像数据的卷积层(convolutional layers)。
图像有三个特性表明需要专门化的模型架构。首先,它们是高维的。一个典型的分类任务图像包含
其次,相邻的图像像素在统计上是相关的。然而,全连接网络没有"邻近"的概念,对每个输入之间的关系一视同仁。如果以相同方式随机排列训练和测试图像的像素,网络仍然可以正常训练,不会有实际差异。第三,图像的解释在几何变换下是稳定的。一棵树的图像即使向左平移几个像素仍然是一棵树的图像。然而,这种平移改变了网络的每个输入,因此全连接模型必须在每个位置分别学习表示树的像素模式,这显然是低效的。
卷积层独立处理每个局部图像区域,使用在整个图像上共享的参数。与全连接层相比,它们使用更少的参数,利用了相邻像素之间的空间关系,且不需要在每个位置重新学习像素的解释。主要由卷积层构成的网络被称为卷积神经网络(convolutional neural network)或 CNN。
10.1 不变性与等变性
我们在上面论证了图像的某些属性(例如树的纹理)在变换下是稳定的。在本节中,我们将这一想法更加数学化。如果图像
换言之,无论变换
如果图像
换言之,如果
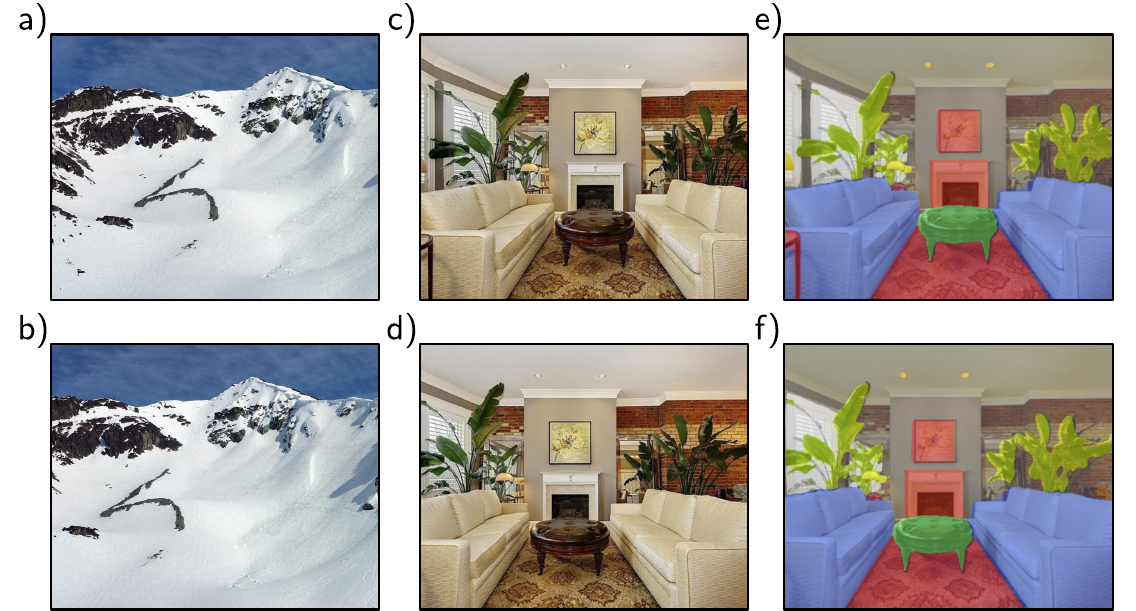
图 10.1 平移的不变性和等变性。a-b)在图像分类中,目标是将两幅图像都分类为"山",不管发生了什么水平移位。换言之,我们要求网络预测对平移是不变的。c,e)语义分割的目标是将标签与每个像素关联。d,f)当输入图像被平移时,我们希望输出(彩色覆盖层)也以相同方式平移。换言之,我们要求输出对平移是等变的。
10.2 一维输入的卷积网络
卷积网络由一系列卷积层组成,每层都对平移是等变的。它们通常还包含引入部分平移不变性的池化机制。为了叙述清晰,我们首先考虑用于一维数据的卷积网络,它更容易可视化。在第 10.3 节中,我们将过渡到可应用于图像数据的二维卷积。
10.2.1 一维卷积运算
卷积层是基于卷积运算的网络层。在一维中,卷积将输入向量
其中
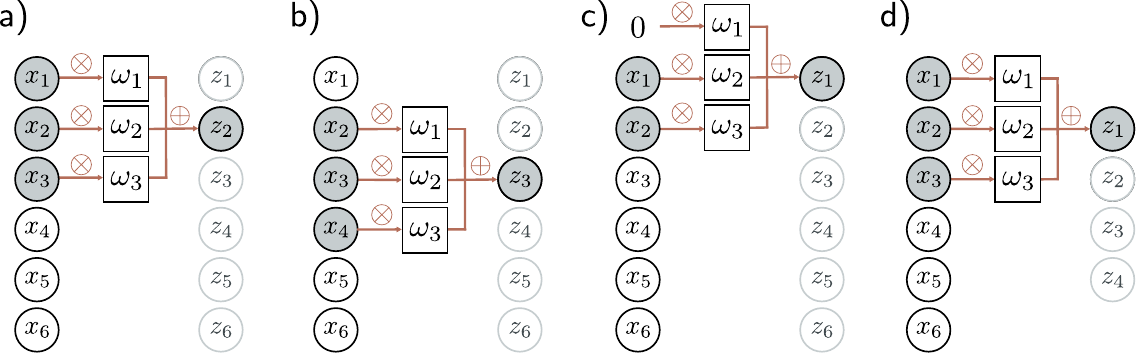
图 10.2 核大小为三的一维卷积。每个输出
是最近三个输入 、 和 的加权和,其中权重 。a)输出 计算为 。b)输出 计算为 。c)在位置 处,核延伸到了第一个输入 之前。这可以通过零填充来处理,即假设输入在有效范围外为零。最后一个输出也类似处理。d)或者,我们可以只计算核完全在输入范围内的输出("有效"卷积);此时输出将比输入小。
10.2.2 填充
方程 10.3 表明每个输出是通过取前一个、当前和后一个位置的输入的加权和来计算的。这引出了如何处理第一个输出(没有前一个输入)和最后一个输出(没有后续输入)的问题。
有两种常见的方法。第一种是用新值填充输入的边缘,然后照常处理。零填充(zero-padding)假设输入在有效范围外为零(图 10.2c)。其他可能性包括将输入视为循环的或在边界处反射。第二种方法是丢弃核超出输入范围的输出位置。这些有效卷积的优点是不在输入边缘引入额外信息,但缺点是表示的大小会减小。
10.2.3 步幅、核大小和膨胀
在上面的例子中,每个输出是最近三个输入的加权和。然而,这只是卷积运算更大家族中的一种,其成员通过步幅(stride)、核大小(kernel size)和膨胀率(dilation rate)来区分。当我们在每个位置都计算输出时,我们称步幅为一。然而,也可以将核每次移动大于一的步幅。如果步幅为二,我们大约产生一半数量的输出(图 10.3a-b)。
核大小可以增大以覆盖更大的区域(图 10.3c)。然而,通常取奇数,以便可以围绕当前位置居中。增大核大小的缺点是需要更多权重。这引出了膨胀卷积(dilated convolution)或 空洞卷积(atrous convolution,来自法语"à trous"——有孔的意思)的概念,其中核值之间穿插零。例如,我们可以将大小为五的核变成膨胀核:将第二个和第四个元素设为零。我们仍然从更大的输入区域整合信息,但只需要三个权重(图 10.3d)。膨胀率是权重之间穿插的零的数量加一。
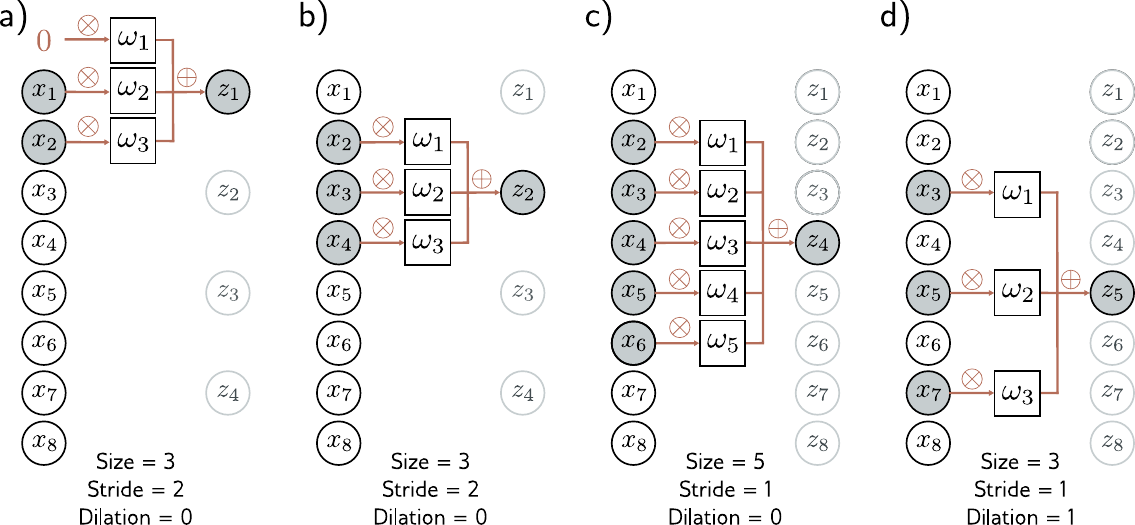
图 10.3 步幅、核大小和膨胀。a)步幅为二时,我们每隔一个位置计算核,因此第一个输出
从以 为中心的加权和计算,第二个输出 从以 为中心的加权和计算,以此类推。b)核大小也可以改变。c)核大小为五时,我们取最近五个输入的加权和。d)在膨胀或空洞卷积中,我们在权重向量中穿插零,以使用更少的权重整合更大区域的信息。
10.2.4 卷积层
卷积层通过对输入进行卷积、加上偏置
其中偏置
如果有
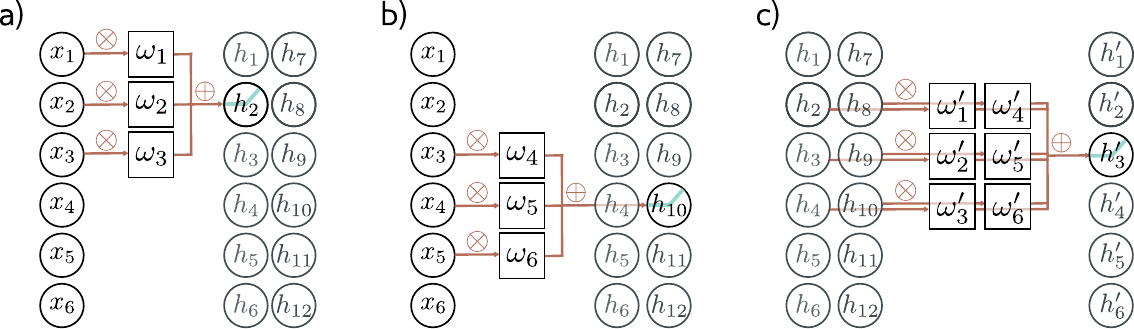
图 10.4 全连接层与卷积层。a)全连接层有一个连接每个输入
到每个隐藏单元 的权重(彩色箭头),以及每个隐藏单元的一个偏置(未显示)。b)因此,关联的权重矩阵 包含 36 个权重将六个输入关联到六个隐藏单元。c)核大小为三的卷积层计算每个隐藏单元为三个相邻输入的相同加权和加一个偏置(未显示)。d)权重矩阵是全连接矩阵的一个特殊情况,其中许多权重为零,其余权重是重复的(相同颜色表示相同值,白色表示零权重)。e)核大小为三、步幅为二的卷积层在每隔一个位置计算加权和。f)这也是具有不同稀疏权重结构的全连接网络的特殊情况。
10.2.5 通道
如果我们只应用单个卷积,信息很可能会丢失;我们在对相邻输入取平均,而 ReLU 激活函数会裁剪小于零的结果。因此,通常需要并行计算多个卷积。每个卷积产生一组新的隐藏变量,称为特征图(feature map)或通道(channel)。
图 10.5a-b 用两个大小为三的卷积核加上零填充来说明了这一点。第一个核计算最近三个像素的加权和,加上一个偏置,并通过激活函数产生隐藏单元
一般来说,输入和隐藏层都有多个通道(图 10.5c)。如果输入层有
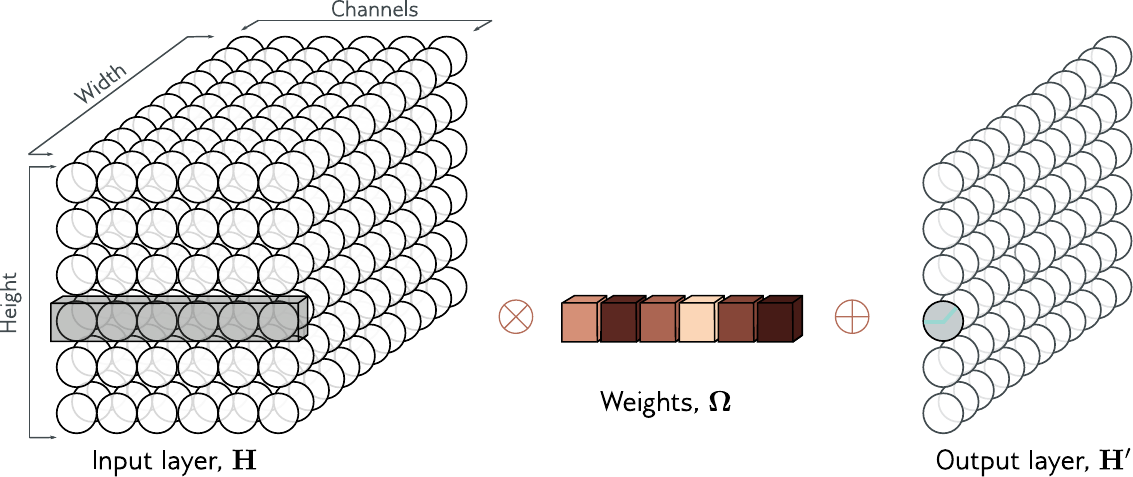
图 10.5 通道。通常对输入
应用多个卷积,存储在通道中。a)卷积应用于输入以创建隐藏单元 到 ,形成第一个通道。b)第二个卷积运算应用于创建隐藏单元 到 ,形成第二个通道。通道存储在包含第一个隐藏层所有隐藏单元的二维数组 中。c)如果添加另一个卷积层,每个输入位置现在有两个通道。此时,一维卷积定义为在三个最近位置的两个输入通道上的加权和,以创建每个新的输出通道。
10.2.6 卷积网络与感受野
第 4 章描述了深度网络,它由全连接层的序列组成。类似地,卷积网络由卷积层的序列组成。网络中隐藏单元的感受野(receptive field)是输入到该单元的原始输入区域。考虑一个每个卷积层核大小为三的卷积网络。第一层的隐藏单元取最近三个输入的加权和,因此
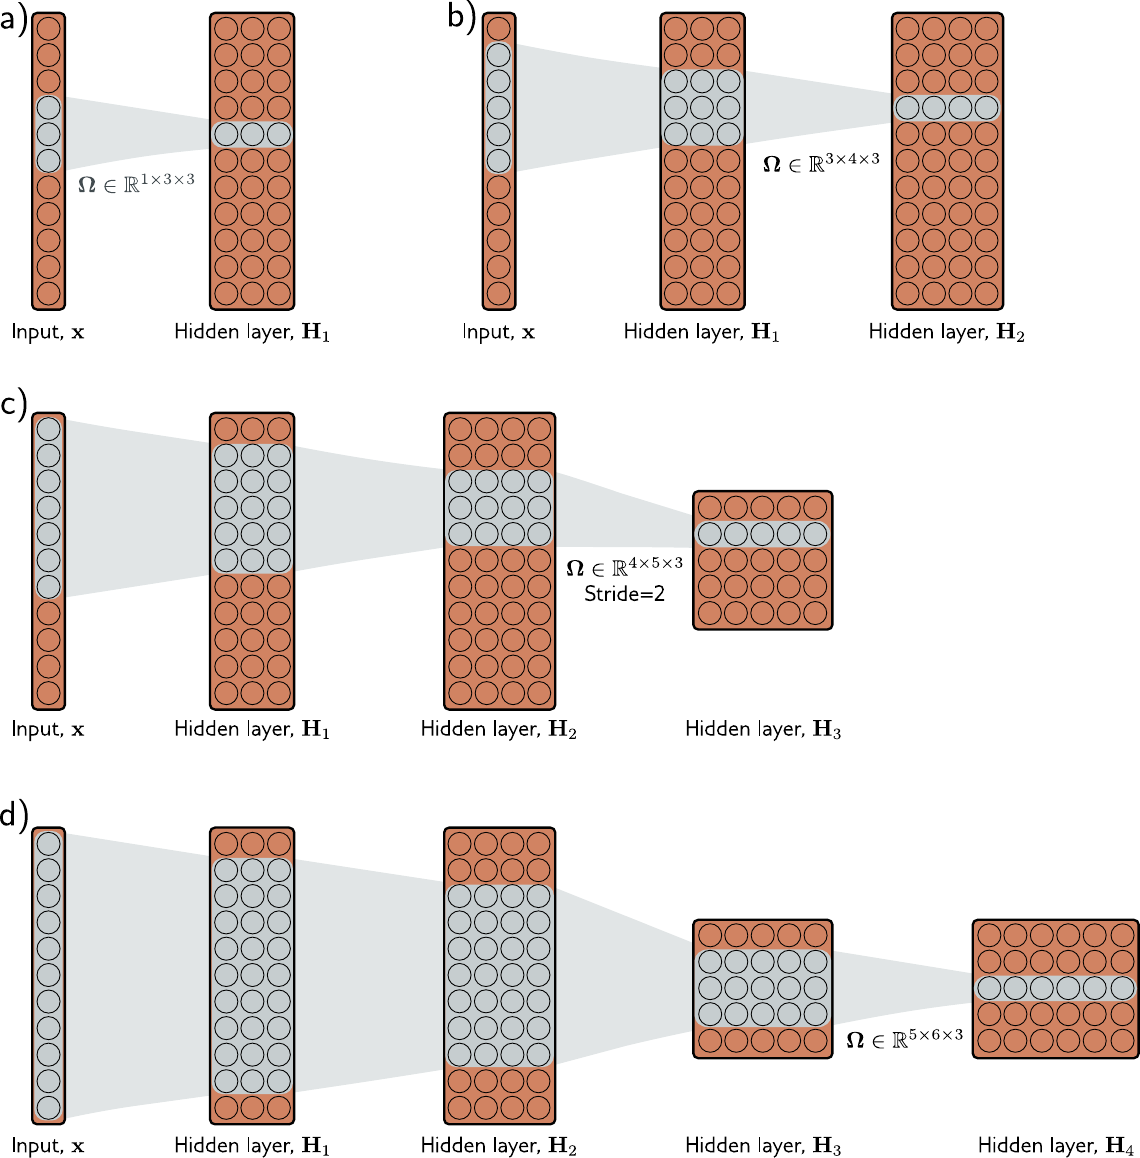
图 10.6 核宽度为三的网络的感受野。a)一个十一维的输入送入具有三个通道和大小为三的卷积核的隐藏层。第一个隐藏层
中三个高亮隐藏单元的预激活值是最近三个输入的不同加权和,因此 的感受野大小为三。b) 层中四个高亮隐藏单元的预激活值分别取 中三个最近位置的三个通道的加权和。 中每个单元加权最近三个输入位置。因此, 中的隐藏单元感受野大小为五。c)第三层中的隐藏单元(核大小三、步幅二)将感受野增大到七。d)当我们添加第四层时,位置三处隐藏单元的感受野覆盖了整个输入。
10.2.7 示例:MNIST-1D
我们现在将卷积网络应用于 MNIST-1D 数据(见图 8.1)。输入
该网络使用不带动量的 SGD 训练 100,000 步,学习率为 0.01,批量大小为 100,数据集大小为 4,000 个样本。我们将其与具有相同层数和隐藏单元数的全连接网络进行比较(即三个隐藏层分别有 285、135 和 60 个隐藏单元)。卷积网络有 2,050 个参数,全连接网络有 59,065 个参数。根据图 10.4 的逻辑,卷积网络是全连接网络的特殊情况。图 10.8 显示两个模型都能完美拟合训练数据,但卷积网络的测试误差远低于全连接网络。
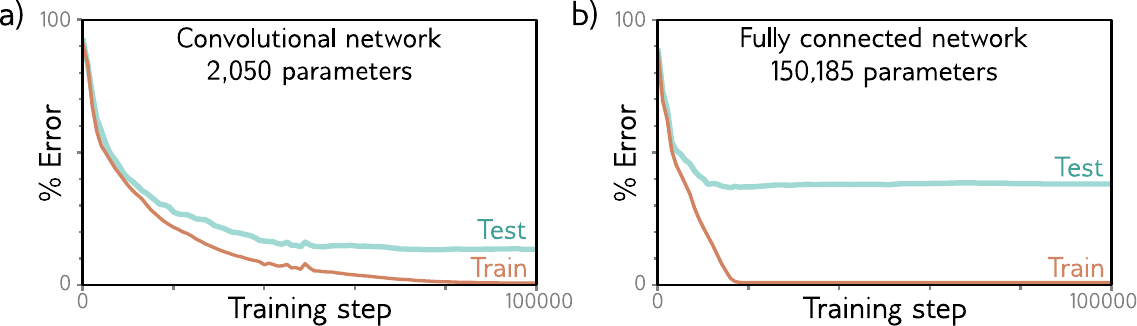
图 10.7 用于分类 MNIST-1D 数据的卷积网络(见图 8.1)。MNIST-1D 输入的维度
。第一个卷积层有十五个通道、核大小三、步幅二,只保留"有效"位置,生成十九个位置、十五个通道的隐藏层。之后两个卷积层设置相同,逐步减小每个后续隐藏层的表示大小。最后,全连接层取第三个隐藏层的所有六十个隐藏单元,输出十个激活值,随后通过 softmax 层产生十个类别概率。
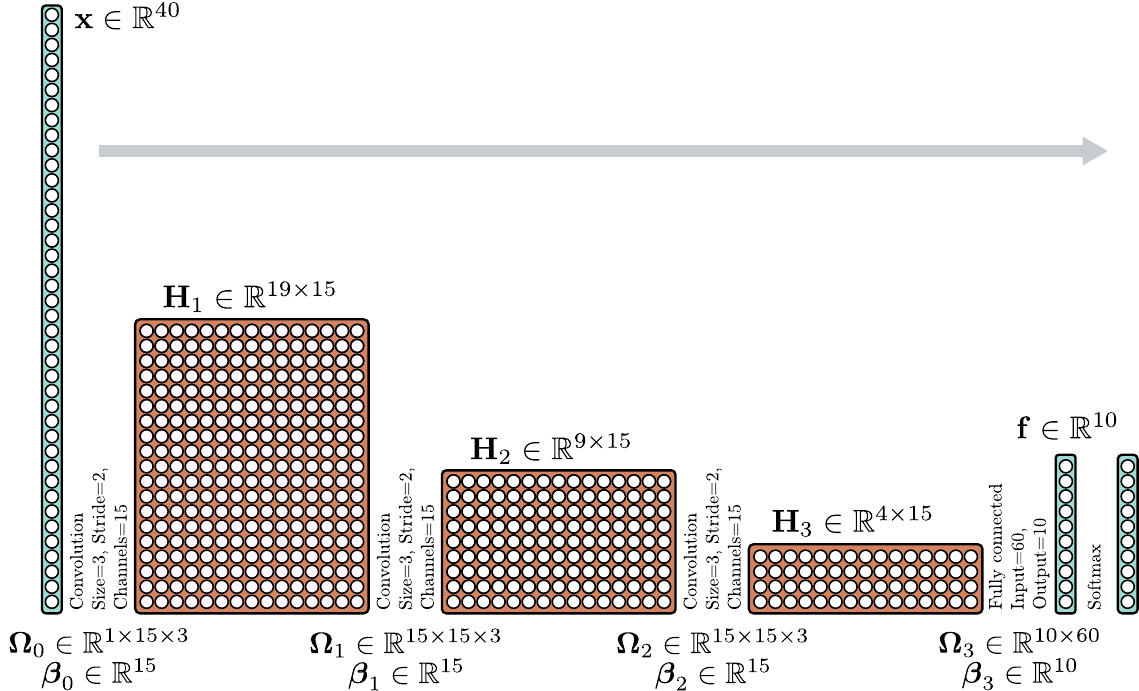
图 10.8 MNIST-1D 结果。a)图 10.7 中的卷积网络最终完美拟合训练数据,测试误差约为 17%。b)具有相同隐藏层数和隐藏单元数的全连接网络学习训练数据更快,但泛化效果不佳,测试误差约为 40%。后者模型有足够的灵活性来精确复制前者。两个模型都能完美拟合训练数据,但卷积网络的测试误差远小于全连接网络。可能的解释是卷积架构具有更好的归纳偏置,因为我们在架构中体现了先验知识——强制网络以相同方式处理每个位置。
10.3 二维输入的卷积网络
上一节描述了处理一维数据的卷积网络。这类网络可以应用于金融时间序列、音频和文本。然而,卷积网络更常应用于二维图像数据。卷积核现在是一个二维对象。一个
其中
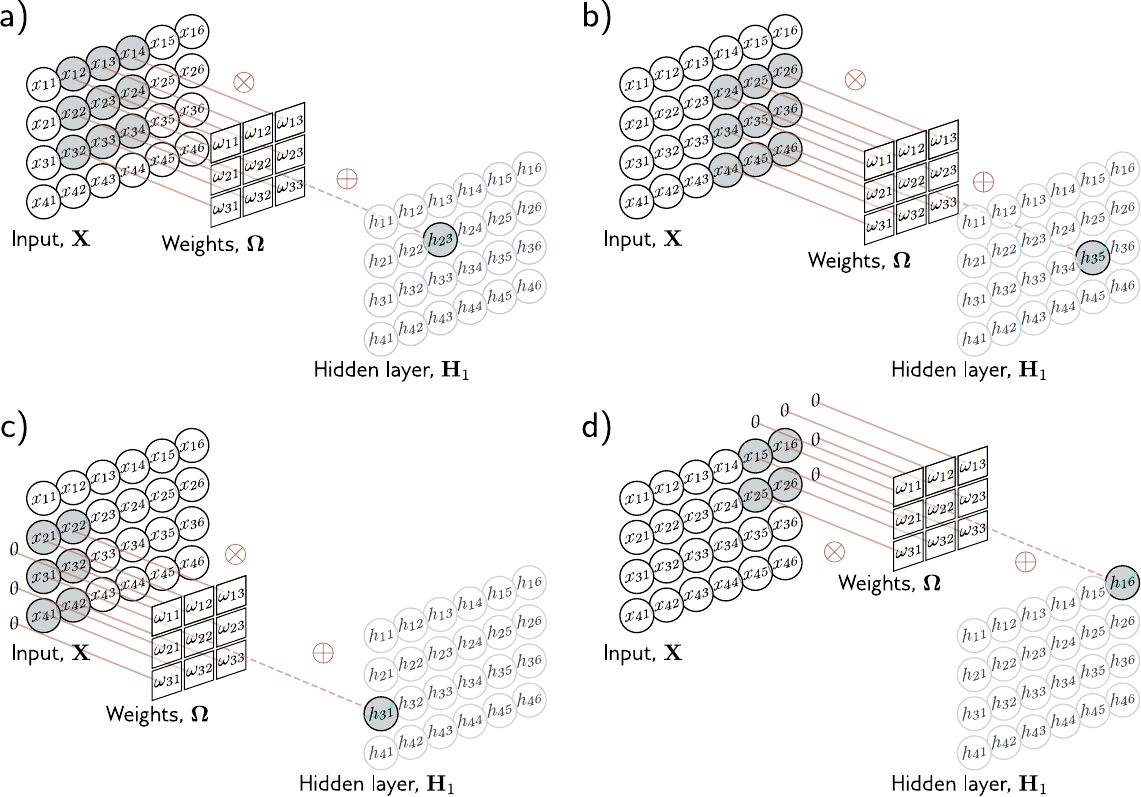
图 10.9 二维卷积层。每个输出
计算最近 个输入的加权和,加上偏置,并通过激活函数。a)这里,输出 (阴影输出)是从 到 (阴影输入)的九个位置的加权和。b)通过将核在图像网格的两个维度上平移来计算不同的输出。c-d)使用零填充时,图像边缘之外的位置被视为零。
通常输入是 RGB 图像,被视为具有三个通道的二维信号(图 10.10)。此时,一个
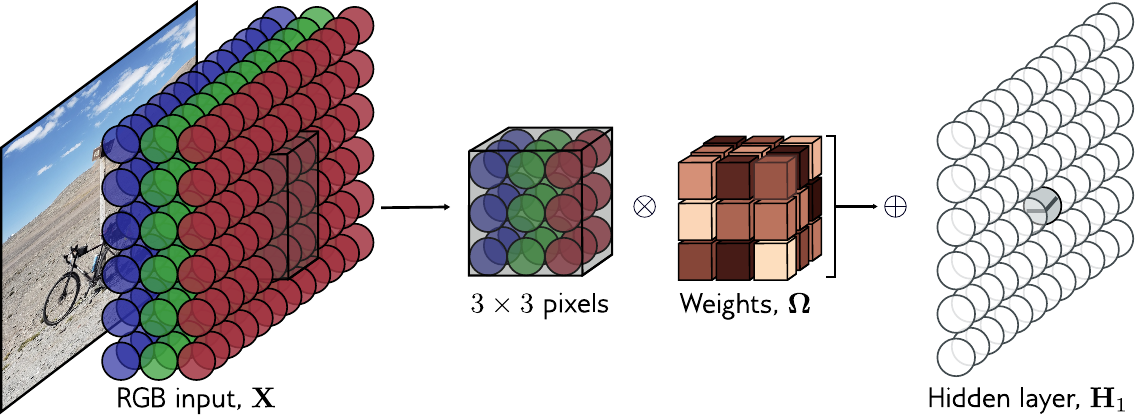
图 10.10 应用于图像的二维卷积。图像被视为具有三个通道(对应红、绿、蓝分量)的二维输入。使用
的核时,第一个隐藏层中的每个预激活值通过将 个核权重与以相同位置为中心的 RGB 图像补丁逐点相乘、求和并加上偏置来计算。为了计算隐藏层中的所有预激活值,我们将核在图像上沿水平和垂直两个方向"滑动"。输出是一个二维隐藏单元层。为了创建多个输出通道,我们用多个核重复此过程,得到隐藏层 处的三维隐藏单元张量。
10.4 下采样与上采样
图 10.7 中的网络通过在每层使用步幅为二的卷积来缩小表示,从而增大感受野。现在我们考虑缩小或下采样(downsampling)二维输入表示的方法。我们还描述将它们放大的方法(上采样,upsampling),这在输出也是图像时很有用。最后,我们考虑在层间改变通道数的方法。这在合并网络两个分支的表示时很有帮助(第 11 章)。
10.4.1 下采样
缩小二维表示有三种主要方法。这里考虑最常见的将两个维度各缩小二倍的情况。首先,我们可以每隔一个位置采样。当使用步幅为二时,我们有效地将此方法与卷积运算同时应用(图 10.11a)。
其次,最大池化(max pooling)保留
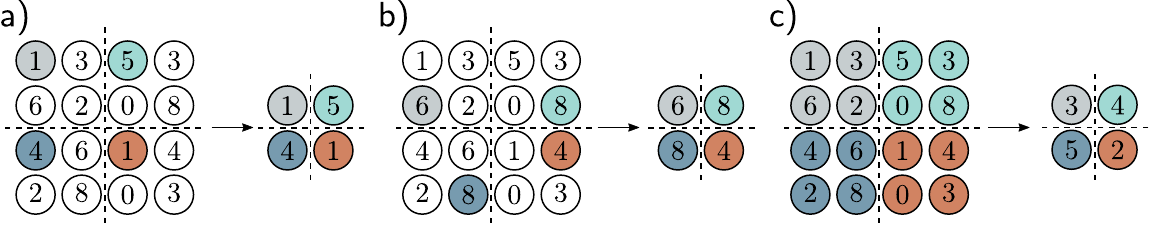
图 10.11 缩小表示大小(下采样)的方法。a)子采样。原始
表示(左)通过保留每隔一个输入而缩小到 (右)。颜色标识哪些输入贡献给了输出。这实际上就是核步幅为二时的效果,只是中间值从不被计算。b)最大池化。每个输出由对应 块的最大值组成。c)平均池化。每个输出是 块中值的平均。
10.4.2 上采样
放大网络层以将分辨率加倍的最简单方法是将每个空间位置的所有通道复制四次(图 10.12a)。第二种方法是最大反池化(max unpooling);当之前使用过最大池化进行下采样时,我们将值重新分配到它们最初来自的位置(图 10.12b)。第三种方法使用双线性插值来填充样本点之间的缺失值(图 10.12c)。
第四种方法与使用步幅为二进行下采样大致类似。在那种方法中,输出数量为输入的一半,对于核大小为三的情况,每个输出是最近三个输入的加权和(图 10.13a)。在转置卷积(transposed convolution)中,这种关系被翻转(图 10.13c)。输出数量是输入的两倍,每个输入贡献给三个输出。当我们考虑这种上采样机制的相关权重矩阵时(图 10.13d),可以看到它是下采样机制矩阵(图 10.13b)的转置。
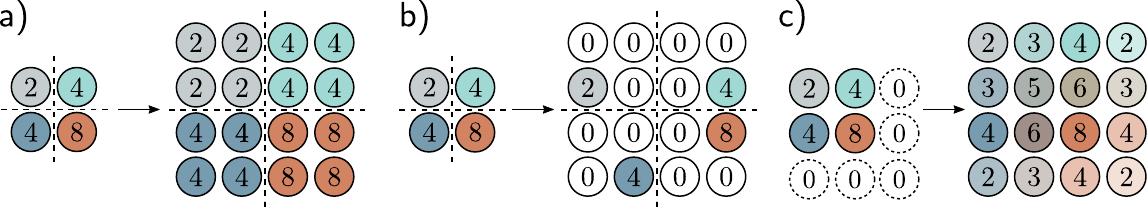
图 10.12 放大表示大小(上采样)的方法。a)将二维层大小加倍的最简单方法是将每个输入复制四次。b)在之前使用最大池化进行下采样的网络中(图 10.11b),我们可以将值重新分配到它们原来所在的位置(即极大值的位置),这被称为最大反池化。c)第三种选择是在输入值之间进行双线性插值。
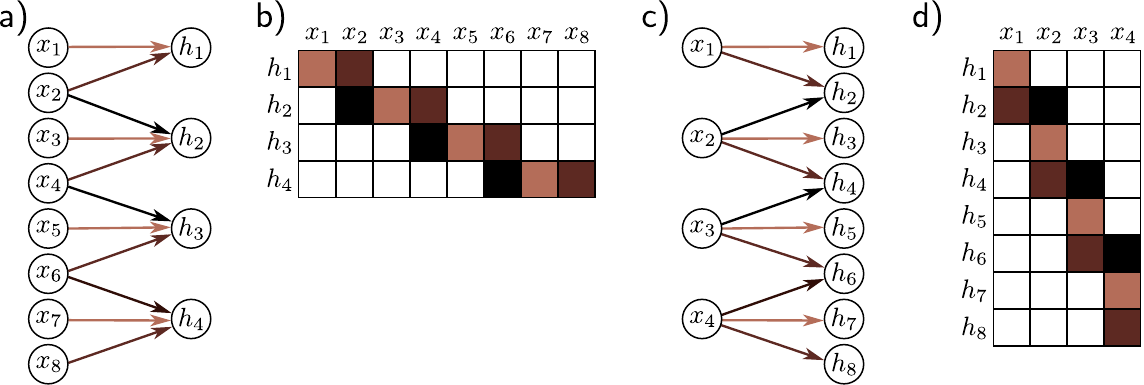
图 10.13 一维转置卷积,核大小三、步幅二、零填充。a)下采样:每个输出是三个输入的加权和(箭头表示权重)。b)可以用权重矩阵表示(相同颜色表示共享权重)。c)在转置卷积中,每个输入贡献三个值到输出层,输出数量是输入的两倍。d)关联的权重矩阵是面板(b)中矩阵的转置。
10.4.3 改变通道数
有时我们想在一个隐藏层和下一个隐藏层之间改变通道数,但不做进一步的空间池化。这通常是为了将表示与另一个并行计算组合(见第 11 章)。为此,我们应用核大小为一的卷积。每个输出层元素通过取同一位置所有通道的加权和来计算(图 10.14)。我们可以用不同的权重重复多次以生成所需数量的输出通道。相关的卷积权重大小为
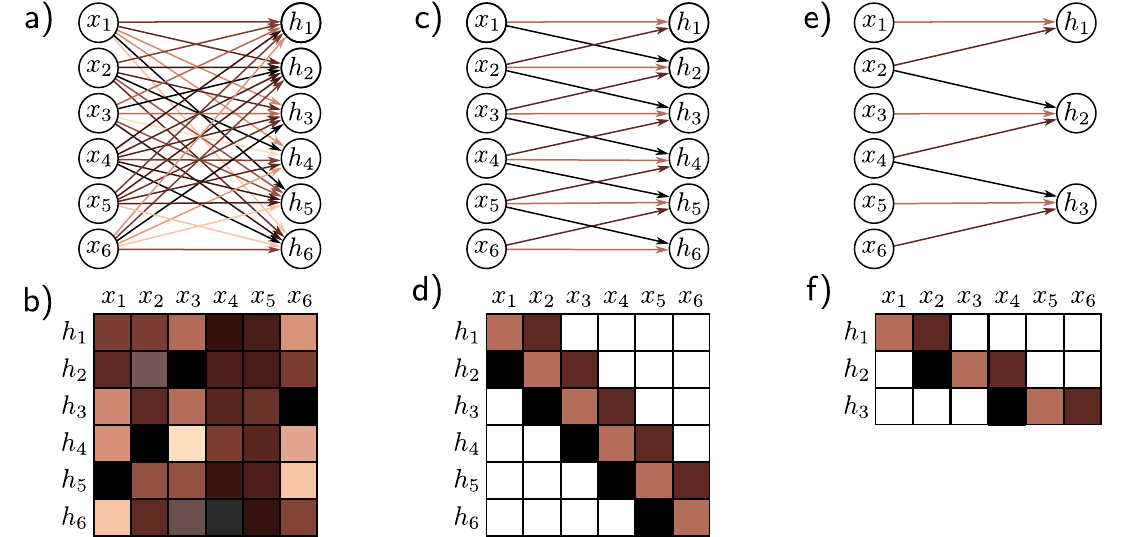
图 10.14
卷积。为了在不进行空间池化的情况下改变通道数,我们应用 核。每个输出通道通过取同一位置所有通道的加权和、加偏置并通过激活函数来计算。通过用不同的权重和偏置重复此操作来创建多个输出通道。
10.5 应用
我们以描述三个计算机视觉应用来结束本章。我们描述用于图像分类的卷积网络,其目标是将图像分配到预定义类别之一。然后考虑目标检测,其目标是识别图像中的多个物体并找到每个物体的边界框。最后,我们描述一个早期的语义分割系统,其目标是根据存在的物体为每个像素分配标签。
10.5.1 图像分类
深度学习在计算机视觉领域的大量开创性工作集中在使用 ImageNet 数据集进行图像分类(图 10.15)。该数据集包含 1,281,167 张训练图像、50,000 张验证图像和 100,000 张测试图像,每张图像被标注为属于 1000 个可能类别之一。
大多数方法将输入图像调整为标准大小;在典型系统中,网络的输入
2012 年,AlexNet 是第一个在该任务上表现出色的卷积网络。它由八个隐藏层和 ReLU 激活函数组成,其中前五层是卷积层,其余是全连接层(图 10.16)。网络首先使用
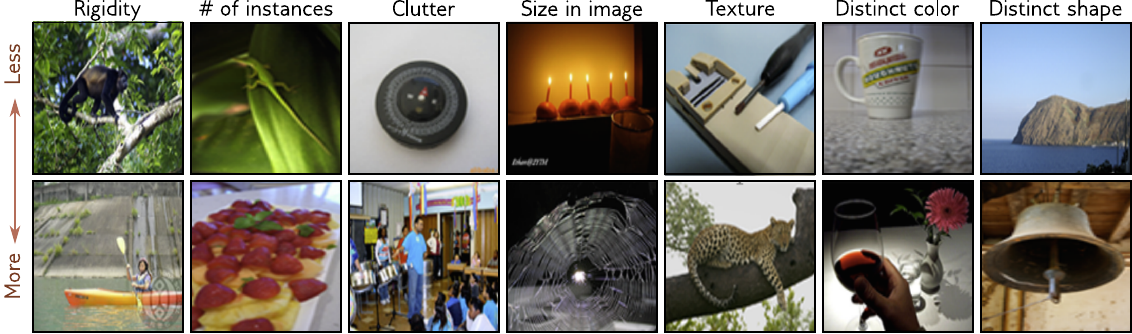
图 10.15 ImageNet 分类图像示例。模型旨在将输入图像分配到 1000 个类别之一。该任务具有挑战性,因为图像沿不同属性(列)变化很大。这些属性包括刚度、实例数量、杂乱程度、图像中的大小、纹理、颜色的区分度和形状的区分度。
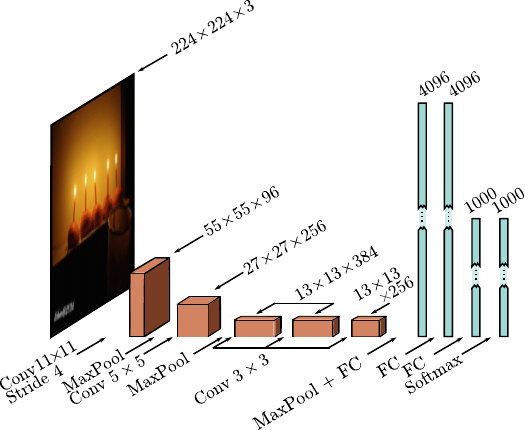
图 10.16 AlexNet(Krizhevsky 等,2012)。网络将
的彩色图像映射为代表类别概率的 1000 维向量。网络首先用 核步幅四卷积创建 96 个通道,通过最大池化降低分辨率后应用 卷积层,接着是三个 卷积层。最终的最大池化后,结果被向量化并通过三个全连接层(FC)和 softmax 层。
数据集通过(i)空间变换和(ii)修改输入强度的方式增强了 2048 倍。测试时,五个不同的裁剪和镜像版本的图像通过网络运行,并平均它们的预测。系统使用动量系数为 0.9、批量大小为 128 的 SGD 学习。在全连接层应用了 Dropout 和 L2(权重衰减)正则化。该系统实现了 16.4% 的 top-5 错误率和 38.1% 的 top-1 错误率。这在当时是一个巨大的性能飞跃,远超当时方法的能力。这一结果揭示了深度学习的潜力,并开启了现代 AI 研究时代。
VGG 网络也针对 ImageNet 任务的分类,取得了更好的性能:6.8% 的 top-5 错误率和 23.7% 的 top-1 错误率。该网络类似地由一系列交替排列的卷积层和最大池化层组成,其中表示的空间大小逐渐减小而通道数逐渐增加。之后是三个全连接层(图 10.17)。VGG 网络同样使用了数据增强、权重衰减和 Dropout 进行训练。
虽然训练方案有各种细微差异,但 AlexNet 和 VGG 之间最重要的变化是网络的深度。后者使用了 19 个隐藏层和 1.44 亿个参数。在几年时间里,随着网络深度的增加,该任务的性能有了普遍提升的趋势,这表明深度在神经网络中很重要。
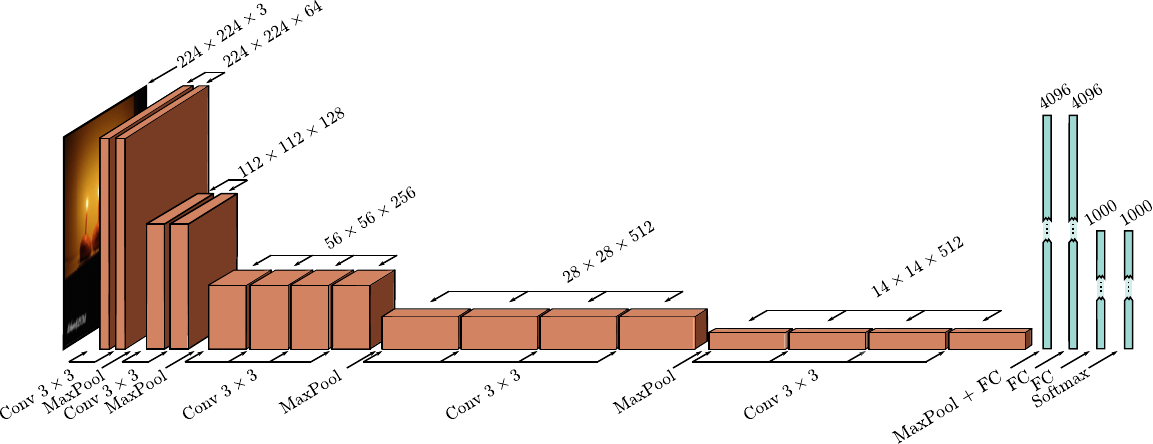
图 10.17 VGG 网络(Simonyan & Zisserman,2014)以与 AlexNet 相同的比例绘制(见图 10.16)。该网络由一系列卷积层和最大池化操作组成,其中表示的空间尺度逐渐减小而通道数逐渐增加。最后一个卷积操作后的隐藏层被重塑为一维向量,接着是三个全连接层。网络输出 1000 个对应类别标签的激活值,通过 softmax 函数创建类别概率。
10.5.2 目标检测
在目标检测(object detection)中,目标是识别并定位图像中的多个物体。一个基于卷积网络的早期方法是 You Only Look Once,简称 YOLO。YOLO 网络的输入是
输出值编码了
网络运行后,使用启发式过程来移除低置信度的矩形,并抑制对应同一物体的多个预测边界框,只保留最有信心的那个。
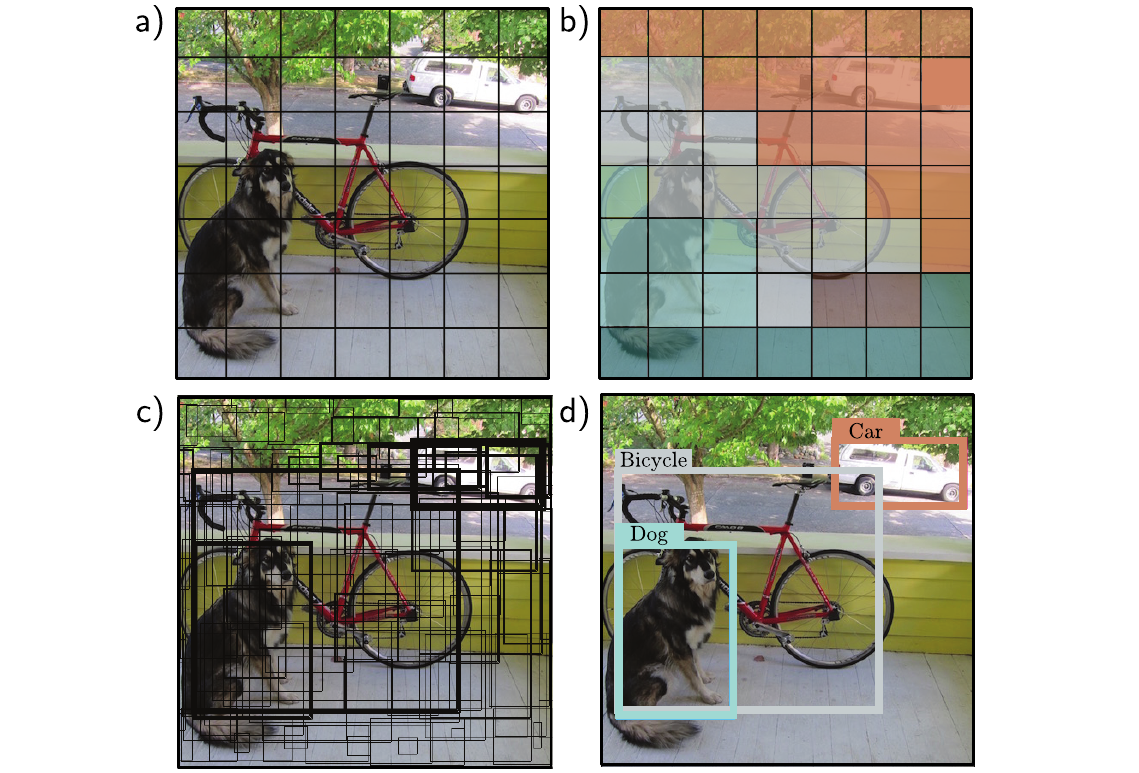
图 10.18 YOLO 目标检测。a)输入图像被调整为
并划分为规则的 网格。b)系统在每个网格单元预测最可能的类别。c)它还在每个单元预测两个边界框和一个置信度值(用线条粗细表示)。d)推理时,保留最可能的边界框,属于同一物体的低置信度框被抑制。
10.5.3 语义分割
语义分割(semantic segmentation)的目标是根据像素所属的物体为每个像素分配标签,如果该像素不对应训练数据库中的任何物体则不分配标签。图 10.19 描述了一个早期的语义分割网络。输入是
网络的前半部分是 VGG 的较小版本(图 10.17),包含十三而非十六个卷积层,将表示下采样到
在此处,架构与 VGG 不同。另一个全连接层将表示重组为
最终的分割结果使用启发式方法生成,贪心地搜索最多代表的类别并推断其区域(同时考虑概率和空间连通性)。然后在剩余未标注像素中添加下一个最多代表的类别,以此类推(图 10.20)。
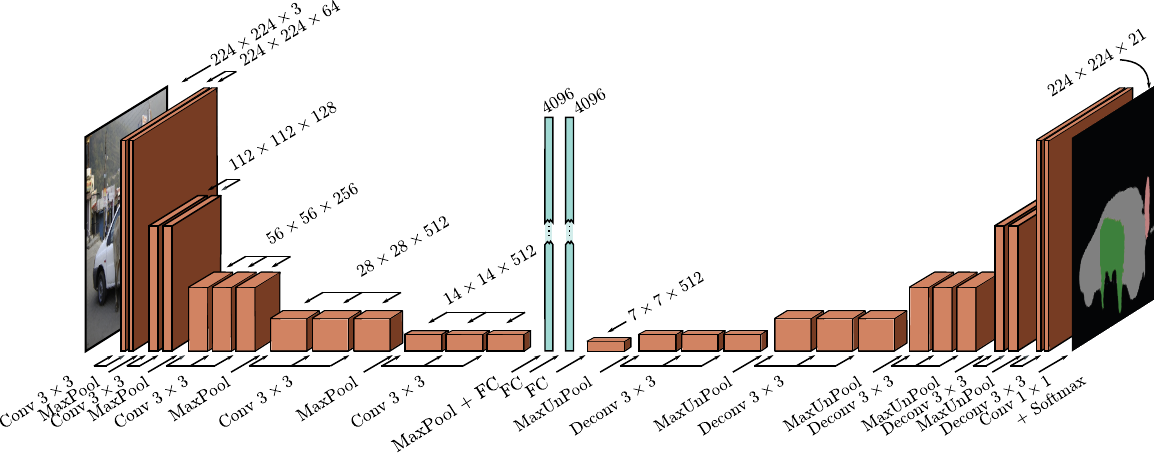
图 10.19 语义分割网络(Noh 等,2015)。输入是
图像,通过 VGG 网络的一个版本传递,最终使用全连接层转换为大小 4096 的表示。它包含了整幅图像的信息。然后使用另一个全连接层重组为 大小的表示,图像被上采样和反卷积(无上采样的转置卷积),形成 VGG 网络的镜像。输出是 的表示,给出每个位置 21 个类别的输出概率。
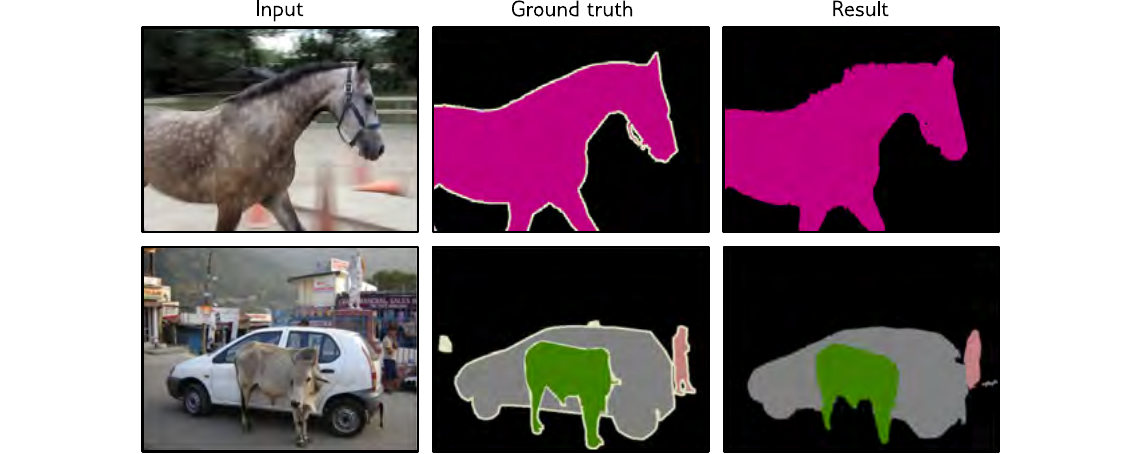
图 10.20 语义分割结果。最终结果从 21 个概率图中创建,贪心地选择最佳类别并使用启发式方法根据概率和空间邻近性找到合理的二值图。如果有足够证据,后续类别被添加,它们的分割图被组合。
10.6 总结
在卷积层中,每个隐藏单元通过取邻近输入的加权和、加偏置并应用激活函数来计算。权重和偏置在每个空间位置都相同,因此参数远少于全连接网络,且参数数量不随输入图像大小增长。为了确保信息不丢失,这个操作使用不同的权重和偏置重复进行,在每个空间位置创建多个通道。
典型的卷积网络由卷积层和以二倍因子下采样的层交替组成。当数据通过网络时,空间维度通常按二的因子减小,通道按二的因子增加。在网络末端,通常有一个或多个全连接层来整合整个输入的信息并创建所需的输出。如果输出是图像,镜像的"解码器"将表示上采样回原始大小。
卷积层的平移等变性施加了有用的归纳偏置,相比全连接网络提高了基于图像任务的性能。我们描述了图像分类、目标检测和语义分割网络。随着网络变得更深,图像分类性能不断提升。然而,后续实验表明,无限增加网络深度并不能持续带来改善;超过一定深度后,系统变得难以训练。这就是残差连接(residual connections)的动机,这是下一章的主题。