
第14章 无监督学习
第 2-9 章介绍了监督学习(supervised learning)的流程。我们定义了将观测数据
无监督学习模型(unsupervised learning models)的核心特征是它们从一组无标签的观测数据
本章介绍无监督学习模型的分类体系,然后讨论模型的理想属性以及如何衡量其性能。随后四章分别讨论四种特定模型:生成对抗网络(GANs)、归一化流、变分自编码器(VAEs)和扩散模型。
14.1 无监督学习模型的分类
无监督学习中的一个常见策略是定义数据样本
原则上,观测变量和潜变量之间的映射可以是任意方向的。一些模型从数据
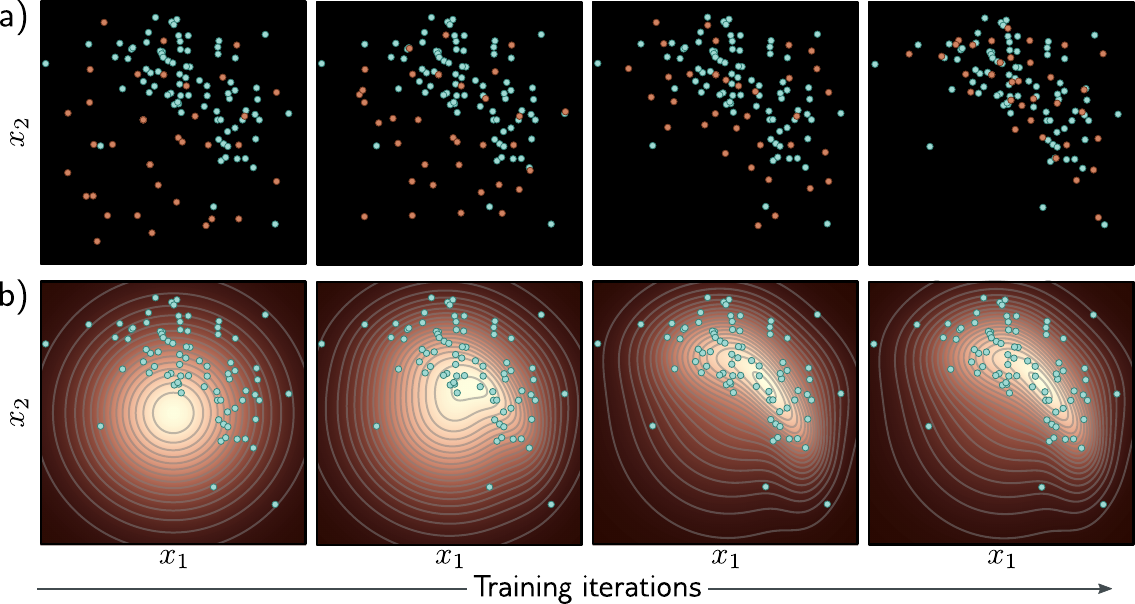
图 14.1 无监督学习模型的分类。无监督学习指在无标签数据集上训练的任何模型。生成模型可以合成(生成)与训练数据具有相似统计特性的新样本。其中一个子集是概率性的,定义数据上的分布。我们从该分布中采样以生成新样本。潜变量模型定义底层解释性(潜)变量与数据之间的映射,可能属于上述任何类别。
第 15-18 章中的四种模型都是使用潜变量的生成模型。生成对抗网络(第 15 章)学习从潜变量
归一化流、变分自编码器和扩散模型(第 16-18 章)是概率生成模型(probabilistic generative models)。除了生成新样本外,它们还为每个数据点
由于概率分布必须和为一,这隐含地降低了远离观测数据的样本的概率。除了提供训练准则外,分配概率本身也很有用;测试集上的概率可以用来定量比较两个模型,单个样本的概率可以通过阈值判断来确定它是否属于同一数据集或是异常值(outlier)。
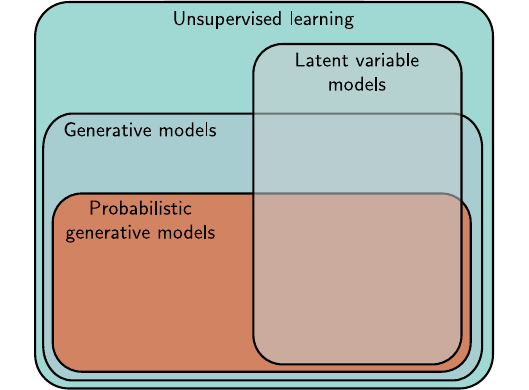
图 14.2 拟合生成模型。a) 生成对抗模型提供生成样本(橙色点)的机制。随着训练进行(从左到右),损失函数鼓励这些样本逐渐变得与真实样本(青色点)不可区分。b) 概率模型(包括变分自编码器、归一化流和扩散模型)学习训练数据上的概率分布。随着训练进行(从左到右),真实样本在该分布下的似然增加,可用于采样新样本和评估新数据点的概率。
14.2 什么是好的生成模型?
基于潜变量的生成模型应具备以下属性:
- 高效采样: 从模型生成样本应该计算代价低廉,并能利用现代硬件的并行性。
- 高质量采样: 生成的样本应该与训练模型所用的真实数据不可区分。
- 覆盖性: 样本应该覆盖整个训练分布。仅生成看起来像训练样本子集的样本是不够的。
- 良好的潜空间: 每个潜变量
都对应一个合理的数据样本 。 中的平滑变化对应 中的平滑变化。 - 解缠的潜空间: 操纵
的每个维度应该对应改变数据的一个可解释属性。例如,在语言模型中,它可能改变主题、时态或详细程度。 - 高效似然计算: 如果模型是概率性的,我们希望能够高效准确地计算新样本的概率。
这自然引出了一个问题:我们考虑的生成模型是否满足这些属性。答案是主观的,但图 14.3 提供了指导。具体的判定可以商榷,但大多数从业者会同意:没有任何单一模型满足所有这些特性。
| 模型 | 高效采样 | 高质量采样 | 覆盖性 | 良好的潜空间 | 解缠的潜空间 | 高效似然计算 |
|---|---|---|---|---|---|---|
| GANs | ✓ | ✓ | ✗ | ✓ | ? | n/a |
| VAEs | ✓ | ✗ | ? | ✓ | ? | ✗ |
| Flows | ✓ | ✗ | ? | ✓ | ? | ✓ |
| Diffusion | ✗ | ✓ | ? | ✗ | ✗ | ✗ |
图 14.3 四种生成模型的属性。无论是生成对抗网络(GANs)、变分自编码器(VAEs)、归一化流(Flows)还是扩散模型(Diffusion),都不具备全部理想属性。
14.3 量化性能
上一节讨论了生成模型的理想属性。我们现在考虑生成模型成功与否的定量度量。由于图像数据的广泛可用性和评判样本的便利性,大量生成模型的实验都使用了图像。因此,其中一些指标仅适用于图像。
测试似然: 比较概率模型的一种方法是衡量它们在测试数据集上的似然。使用训练数据似然是无效的,因为模型可能对每个训练点赋予很高的概率而在它们之间赋予很低的概率。这样的模型训练似然很高但只能重现训练数据。测试似然捕获了模型从训练数据泛化的能力以及覆盖性;如果模型只对训练数据的子集赋予高概率,就必须在其他地方赋予较低的概率,因此部分测试样本将具有低概率。
测试似然是量化概率模型的合理方式,但不幸的是,它不适用于生成对抗网络(不分配概率),对变分自编码器和扩散模型的估计代价高昂(虽然可以计算对数似然的下界)。归一化流是唯一可以精确高效计算似然的模型。
Inception 分数: Inception 分数(IS)专门用于图像,理想地用于在 ImageNet 数据库上训练的生成模型。该分数使用预训练分类模型计算——通常是"Inception"模型,名称由此而来。它基于两个标准。首先,每个生成的图像
Inception 分数衡量这两个分布在生成集合上的平均距离。如果一个分布集中而另一个平坦,则距离大(图 14.4)。更精确地说,它返回
其中
这个指标仅对 ImageNet 数据库的生成模型合理,且对特定分类模型敏感;重新训练该模型可能给出截然不同的数值结果。此外,它不奖励物体类别内的多样性;如果模型只生成每个类别的一个逼真样本,它也会返回高值。
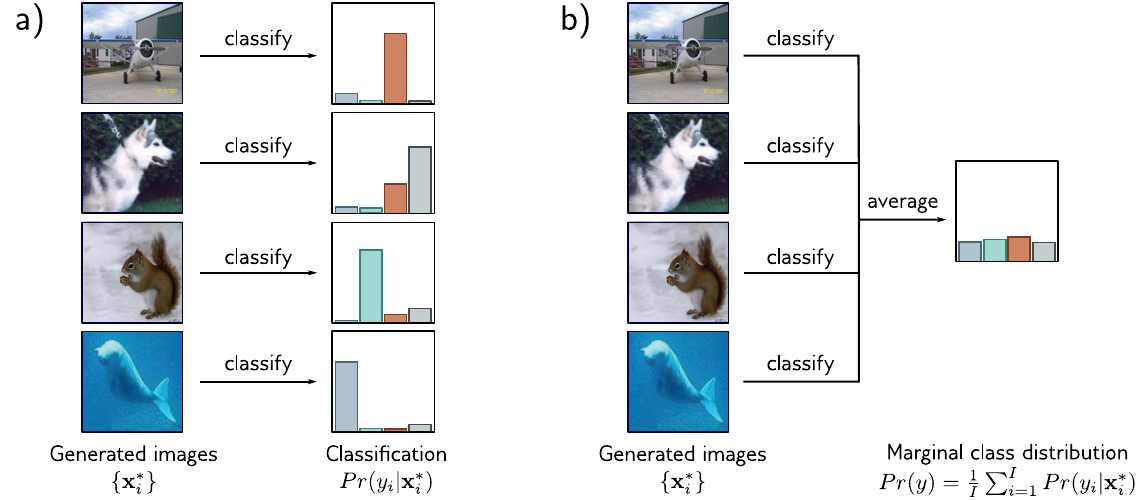
图 14.4 Inception 分数。a) 预训练网络对生成的图像进行分类。如果图像逼真,得到的类别概率
应该集中在正确类别上。b) 如果模型以相等频率生成所有类别,边缘(平均)类别概率应该是平坦的。Inception 分数衡量 (a) 中的分布和 (b) 中的分布之间的平均距离。
Fréchet Inception 距离: 该度量也适用于图像,计算生成样本和真实样本的分布之间的对称距离。这必须是近似的,因为直接表征任一分布都是困难的(实际上,表征真实样本的分布正是生成模型的任务)。因此,Fréchet Inception 距离用多元高斯分布近似两个分布,并(如名称所示)用 Fréchet 距离估计它们之间的距离。
然而,它不是对原始数据建模距离,而是对 Inception 分类网络最深层的激活值建模。这些隐藏单元与物体类别最为关联,因此比较发生在语义层面,忽略了图像更精细的细节。这个指标考虑了类别内的多样性,但严重依赖 Inception 网络保留的信息;网络丢弃的信息对结果没有贡献。这些被丢弃的信息中的一些可能对生成逼真样本仍然很重要。
流形精度/召回率: Fréchet Inception 距离同时对样本的真实性和多样性敏感,但不区分这两个因素。为了解缠这些品质,我们考虑数据流形(manifold)(即真实样本所在的数据空间子集)和模型流形(即生成样本所在之处)之间的重叠。精度(precision)是落入数据流形的模型样本的比例。这衡量的是生成样本中真实样本的比例。召回率(recall)是落入模型流形的数据样本的比例。这衡量的是模型能够生成的真实数据的比例(图 14.5)。
为了估计流形,我们在每个数据样本周围放置一个超球体,其半径是到第
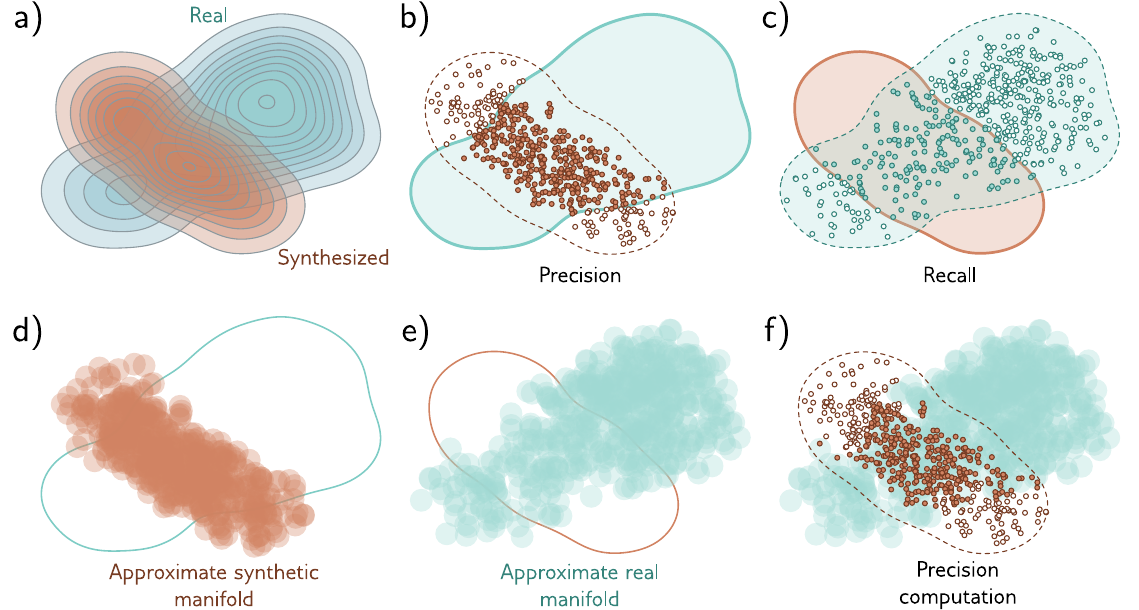
图 14.5 流形精度/召回率。a) 真实样本和生成模型合成样本的真实分布。b) 重叠可以用精度(合成样本中落入真实样本分布或流形中的比例)和 c) 召回率(落入合成样本流形中的真实样本比例)来概括。d) 合成样本的流形可以通过在每个样本上取以其为中心的超球体的并集来近似。这里球体有恒定半径,但更常见的是半径基于到第
个最近邻的距离。e) 真实样本的流形以类似方式近似。f) 精度可以计算为落入近似的真实样本流形内的合成样本比例。类似地,召回率计算为落入近似的合成样本流形内的真实样本比例(未展示)。
14.4 总结
无监督模型在无标签的情况下学习数据集的结构。这些模型中的一个子集是生成性的,可以合成新的数据样本。更进一步的一个子集是概率性的,既可以生成新样本又可以为观测数据分配概率。接下来四章考虑的模型都以具有已知分布的潜变量