Skip to content

附录B 数学基础

本附录回顾正文中使用的数学概念。

B.1 函数

函数(function)定义了从一个集合 X(例如实数集)到另一个集合 Y 的映射。单射(injection)是一对一函数,其中第一个集合的每个元素映射到第二个集合中的唯一位置(但第二个集合中可能有未被映射到的元素)。满射(surjection)是一个函数,其中第二个集合的每个元素都接收来自第一个集合的映射(但第一个集合中可能有多个元素映射到第二个集合的同一个元素)。双射(bijection)或双射映射(bijective mapping)是一个既是单射又是满射的函数。它提供了两个集合所有成员之间的一一对应关系。微分同胚(diffeomorphism)是双射的一个特殊情况,其中正向和反向映射都是可微的。

B.1.1 利普希茨常数

如果对所有 z1,z2 满足以下条件,则函数 f[z]利普希茨连续(Lipschitz continuous)的:

(B.1)||f[z1]f[z2]||β||z1z2||,

其中 β 被称为利普希茨常数(Lipschitz constant),它决定了函数相对于距离度量可以变化的最大速率(即函数的最大梯度)。如果利普希茨常数小于1,则该函数是一个收缩映射(contraction mapping),我们可以使用巴拿赫定理找到任意点的逆(参见图16.9)。

将两个利普希茨常数分别为 β1β2 的函数复合,会产生一个新的利普希茨连续函数,其常数小于或等于 β1β2。将两个利普希茨常数分别为 β1β2 的函数相加,会产生一个新的利普希茨连续函数,其常数小于或等于 β1+β2。线性变换 f[z]=Az+b 相对于欧几里得距离度量的利普希茨常数是 A 的最大特征值。

B.1.2 凸性

如果我们可以在函数上任意两点之间画一条直线,且该直线始终位于函数之上,则函数是凸的(convex)。类似地,如果任意两点之间的直线始终位于函数之下,则函数是凹的(concave)。根据定义,凸(凹)函数最多有一个最小值(最大值)。

RD 的一个区域是凸的,如果我们可以在该区域边界上任意两点之间画一条直线,而不会在其他地方与边界相交。梯度下降保证能找到任何既是凸的又定义在凸区域上的函数的全局最小值。

B.1.3 特殊函数

以下函数在正文中使用:

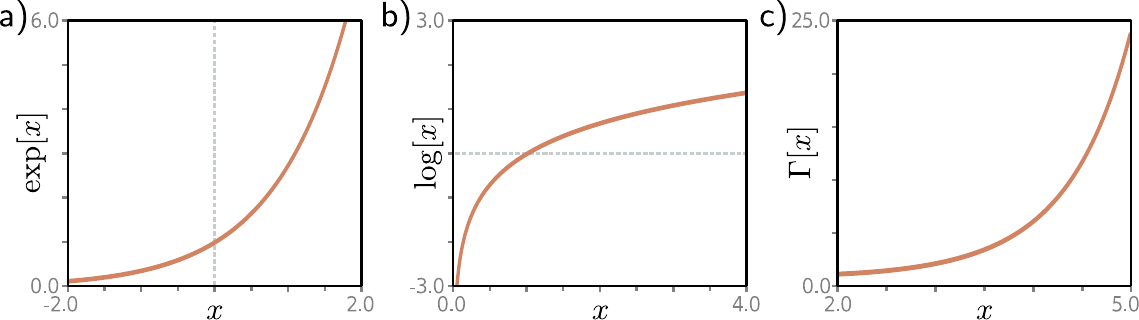
  • 指数函数(exponential function)y=exp[x](图 B.1a)将实变量 xR 映射为非负数 yR+,即 y=ex
  • 对数(logarithm)x=log[y](图 B.1b)是指数函数的逆函数,将非负数 yR+ 映射为实变量 xR。注意本书中所有对数均为自然对数(即以 e 为底)。
  • 伽马函数(gamma function)Γ[x](图 B.1c)定义为:
(B.2)Γ[x]=0tx1etdt.

这将阶乘函数扩展到连续值,使得 Γ[x]=(x1)!,对 x{1,2,}

  • 狄拉克δ函数(Dirac delta function)δ[z] 的总面积为1,全部集中在 z=0 的位置。一个包含 N 个元素的数据集可以被看作一个概率分布,由以每个数据点 xi 为中心的 N 个δ函数之和组成,并缩放 1/N。δ函数通常画成一个箭头(例如图5.12)。δ函数具有以下关键性质:
(B.3)f[x]δ[xx0]dx=f[x0].

图 B.1

图 B.1 指数函数、对数函数和伽马函数。a) 指数函数将实数映射为正数,它是一个凸函数。b) 对数是指数函数的逆函数,将正数映射为实数,它是一个凹函数。c) 伽马函数是阶乘函数的连续扩展,使得 Γ[x]=(x1)!,对 x{1,2,}

B.1.4 斯特林公式

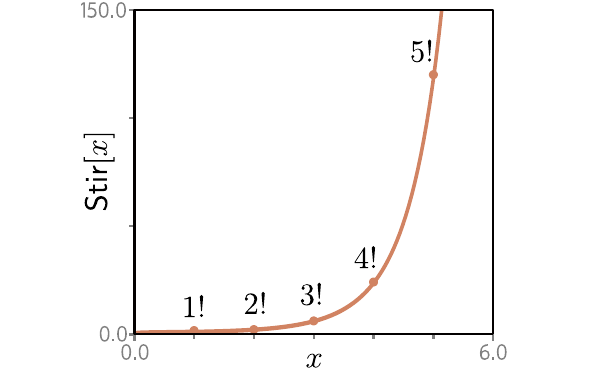
斯特林公式(Stirling's formula)(图 B.2)使用以下公式近似阶乘函数(以及伽马函数):
(B.4)x!2πx(xe)x.

图 B.2

图 B.2 斯特林公式。阶乘函数 x! 可以用斯特林公式 Stir[x] 近似,后者对每个实数值都有定义。

B.2 二项式系数

二项式系数(binomial coefficient)写作 (nk),读作"n 选 k"。它们是正整数,表示从 n 个项目的集合中无放回地选取 k 个项目的无序子集的方式数。二项式系数可以使用以下简单公式计算:

(B.5)(nk)=n!k!(nk)!.

B.2.1 自相关

连续函数 f[z]自相关(autocorrelation)r[τ] 定义为:

(B.6)r[τ]=f[t+τ]f[t]dt,

其中 τ 是时间延迟。有时将其归一化为 r[0],使得零时间延迟处的自相关为1。自相关函数是函数与自身在某个偏移(即时间延迟)处的相关性的度量。如果函数变化缓慢且可预测,则自相关函数随时间延迟从零开始缓慢下降。如果函数变化快速且不可预测,则它将快速下降到零。

B.3 向量、矩阵和张量

在机器学习中,向量 xRD 是一个 D 维数组,我们假设它以列的形式组织。类似地,矩阵 YRD1×D2 是一个具有 D1 行和 D2 列的二维数组。张量 zRD1×D2××DN 是一个 N 维数组。令人困惑的是,在 PyTorch 和 TensorFlow 等深度学习 API 中,这三种量都存储在被称为"张量"的对象中。

B.3.1 转置

矩阵 ARD1×D2 的转置 ATRD2×D1 是通过沿主对角线翻转形成的,使得第 k 列变为第 k 行,反之亦然。如果我们对矩阵乘积 AB 取转置,则取各个矩阵的转置并反转顺序,即:

(B.7)(AB)T=BTAT.

列向量 a 的转置是行向量 aT,反之亦然。

B.3.2 向量和矩阵范数

对于向量 zp 范数定义为:

(B.8)||z||p=(d=1D|zd|p)1/p,

对于实数值 p>1。当 p=2 时,它返回向量的长度,称为欧几里得范数(Euclidean norm)。这是深度学习中最常用的情况,因此指数 p 通常被省略,欧几里得范数直接写为 ||z||。当 p= 时,算子返回向量中绝对值最大的元素。

范数也可以类似地为矩阵计算。例如,矩阵 Z2 范数(称为 Frobenius 范数)计算为:

(B.9)||Z||F=(i=1Ij=1J|zij|2)1/2.

B.3.3 矩阵乘积

两个矩阵 ARD1×D2BRD2×D3 的乘积 C=AB 是一个第三个矩阵 CRD1×D3,其中:

(B.10)Cij=d=1D2AidBdj.

B.3.4 向量点积

两个向量 aRDbRD点积(dot product)aTb 是一个标量,定义为:

(B.11)aTb=bTa=d=1Dadbd.

可以证明,点积正比于第一个向量的欧几里得范数乘以第二个向量的欧几里得范数乘以它们之间夹角 θ 的余弦:

(B.12)aTb=||a||||b||cos[θ].

B.3.5 逆

方阵 A 可能有也可能没有逆矩阵 A1,使得 A1A=AA1=I。如果矩阵没有逆,则称其为奇异的(singular)。如果我们对矩阵乘积 AB(其中 AB 都是方阵且可逆)取逆,则可以等价地分别取每个矩阵的逆并反转乘法顺序:

(B.13)(AB)1=B1A1.

一般而言,求逆一个 D×D 矩阵需要 O[D3] 次运算。然而,对于特殊类型的矩阵,包括对角矩阵、正交矩阵和三角矩阵,求逆更加高效(参见B.4节)。

B.3.6 子空间

考虑矩阵 ARD1×D2。如果矩阵的列数 D2 少于行数 D1(即矩阵是"纵向"的),则乘积 Ax 无法到达 D1 维输出空间中的所有可能位置。这个乘积由 AD2 列组成,由 xD2 个元素加权,只能到达由这些列张成的线性子空间(linear subspace)。这被称为矩阵的列空间(column space)。反之,对于横向矩阵 A,输入空间中映射为零的部分(即那些 Ax=0x)被称为矩阵的零空间(nullspace)。

B.3.7 特征谱

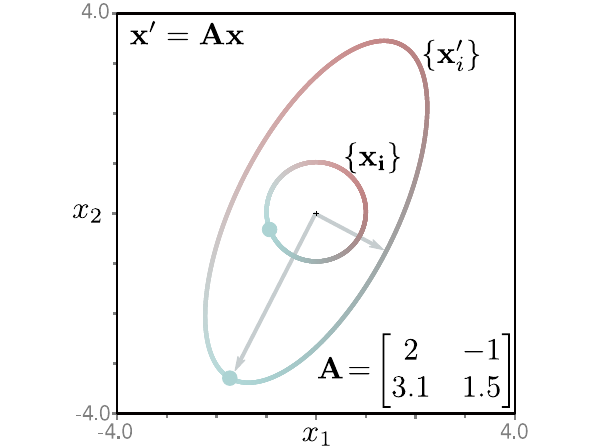
如果我们将单位圆上的一组二维点乘以一个 2×2 矩阵 A,它们会映射到一个椭圆(图 B.3)。该椭圆的长轴和短轴的半径(即最长和最短方向)对应于矩阵奇异值(singular value)λ1λ2 的大小。同样的思想适用于更高维度。一个 D 维球体被 D×D 矩阵 A 映射为一个 D 维椭球体。该椭球体的 D 个主轴的半径决定了奇异值的大小。对于对称方阵,相同的信息由特征值(eigenvalue)捕获,此时特征值与奇异值相同。

图 B.3

图 B.3 奇异值。当单位圆上的点 {xi} 通过线性变换 xi=Axi 变换为点 {xi} 时,它们被映射到一个椭圆。椭圆长轴(最长)轴的长度是矩阵第一个奇异值的大小,短轴(最短)轴的长度是第二个奇异值的大小。

方阵的谱范数(spectral norm)是最大的绝对特征值。它捕获了当矩阵作用于单位长度向量时可能产生的最大变化量。因此,它告诉我们该变换的利普希茨常数。特征值的集合有时被称为特征谱(eigenspectrum),它告诉我们矩阵在所有方向上施加的缩放大小。这些信息可以用矩阵的行列式来概括。

B.3.8 行列式和迹

每个方阵 A 都有一个与之关联的标量,称为行列式(determinant),记为 |A|det[A],它是特征值的乘积。因此,它与矩阵对不同输入施加的平均缩放有关。行列式绝对值小的矩阵在乘法时倾向于减小向量的范数。行列式绝对值大的矩阵在乘法时倾向于增大范数。如果矩阵是奇异的,行列式为零,且在矩阵作用时空间中至少有一个方向会被映射到原点。矩阵表达式的行列式遵循以下规则:

|AT|=|A||AB|=|A||B|(B.14)|A1|=1/|A|.

矩阵的(trace)是对角线元素之和(矩阵本身不必是对角的)或特征值之和。迹遵循以下规则:

trace[AT]=trace[A]trace[AB]=trace[BA]trace[A+B]=trace[A]+trace[B](B.15)trace[ABC]=trace[BCA]=trace[CAB],

其中在最后一个关系中,迹仅对循环置换是不变的,因此一般而言,trace[ABC]trace[BAC]

B.4 特殊矩阵类型

计算方阵 ARD×D 的逆的复杂度为 O[D3],行列式的计算亦是如此。然而,对于某些具有特殊性质的矩阵,这些计算可以更加高效。

B.4.1 对角矩阵

对角矩阵(diagonal matrix)除主对角线外所有位置都为零。如果这些对角元素全部非零,则逆也是对角矩阵,每个对角元素 dii 替换为 1/dii。行列式是对角线上值的乘积。它的一个特殊情况是单位矩阵(identity matrix),对角线上全部为1。因此,它的逆也是单位矩阵,行列式为1。

B.4.2 三角矩阵

下三角矩阵(lower triangular matrix)的所有非零值都在主对角线上和/或主对角线以下。上三角矩阵(upper triangular matrix)的所有非零值都在主对角线上和/或主对角线以上。在两种情况下,矩阵都可以在 O[D2] 内求逆(参见问题16.4),行列式就是对角线上值的乘积。

B.4.3 正交矩阵

正交矩阵(orthogonal matrix)表示围绕原点的旋转和反射,因此在图 B.3 中,圆将被映射到另一个单位半径的圆,但可能被旋转和/或反射。因此,特征值的大小必须全部为1,行列式必须是1或-1。正交矩阵的逆是其转置,即 A1=AT

B.4.4 置换矩阵

置换矩阵(permutation matrix)在每行每列恰好有一个非零元素,且所有这些元素的值都为1。它是正交矩阵的一个特殊情况,因此它的逆是其转置,行列式始终为 ±1。顾名思义,它的作用是置换向量中元素的位置。例如:

(B.16)[010001100][abc]=[bca].

B.4.5 线性代数

线性代数(linear algebra)是研究线性函数的数学,线性函数具有以下形式:

(B.17)f[z1,z2,zD]=ϕ1z1+ϕ2z2++ϕDzD,

其中 ϕ1,,ϕD 是定义函数的参数。我们通常还会添加一个常数项 ϕ0 到右边。严格来说这是仿射(affine)函数,但在机器学习中通常称为线性的。我们在全书中采用这一惯例。

B.4.6 矩阵形式的线性方程

考虑一组线性函数:

y1=ϕ10+ϕ11z1+ϕ12z2+ϕ13z3y2=ϕ20+ϕ21z1+ϕ22z2+ϕ23z3(B.18)y3=ϕ30+ϕ31z1+ϕ32z2+ϕ33z3.

这些可以写成矩阵形式:

(B.19)[y1y2y3]=[ϕ10ϕ20ϕ30]+[ϕ11ϕ12ϕ13ϕ21ϕ22ϕ23ϕ31ϕ32ϕ33][z1z2z3],

或简写为 y=ϕ0+Φz,其中 yi=ϕi0+j=13ϕijzj

B.5 矩阵微积分

本书的大多数读者都习惯了这样的思想:如果我们有一个函数 y=f[x],我们可以计算导数 y/x,它表示当我们对 x 做一个小变化时 y 如何变化。这一思想可以扩展到函数 y=f[x](将向量 x 映射到标量 y)、函数 y=f[x](将向量 x 映射到向量 y)、函数 y=f[X](将矩阵 X 映射到向量 y)等等。矩阵微积分(matrix calculus)的规则帮助我们计算这些量的导数。导数具有以下形式:

  • 对于函数 y=f[x](其中 yRxRD),导数 y/x 也是一个 D 维向量,其第 i 个元素计算为 y/xi
  • 对于函数 y=f[x](其中 yRDyxRDx),导数 y/x 是一个 Dx×Dy 矩阵,其中元素 (i,j) 包含导数 yj/xi。这被称为雅可比矩阵(Jacobian),在其他文献中有时写作 xy
  • 对于函数 y=f[X](其中 yRDyXRD1×Dx),导数 y/X 是一个包含导数 yi/xjk 的三维张量。

这些矩阵和向量导数的形式通常与标量情况表面上相似。例如,我们有:

(B.20)y=axyx=a,

以及

(B.21)y=Axyx=AT.

基于 CC-BY-NC-ND 许可协议