Skip to content

第5章 损失函数

前三章描述了线性回归、浅层神经网络和深度神经网络。每一种都代表一族将输入映射到输出的函数,而模型参数 ϕ 决定了该族中的具体成员。当我们训练这些模型时,我们寻找能使输入到输出的映射在所考虑的任务上尽可能好的参数。本章定义什么是"尽可能好"的映射。

这一定义需要一个输入/输出对的训练数据集 {xi,yi}损失函数(loss function)或代价函数(cost function)L[ϕ] 返回一个标量值,描述模型预测 f[xi,ϕ] 与其对应的真实输出 yi 之间的不匹配程度。在训练过程中,我们寻找使损失最小化的参数值 ϕ,从而使训练输入尽可能准确地映射到输出。我们在第 2 章中已经看到了一个损失函数的例子——最小二乘损失函数适用于目标为实数 yR 的单变量回归问题。它计算模型预测 f[xi,ϕ] 与真实值 yi 之间偏差的平方和。

本章提供一个框架,既可以证明最小二乘准则对于实值输出的合理性,又可以为其他预测类型构建损失函数。我们考虑二元分类(binary classification),其中预测 y{0,1} 是两个类别之一;多类分类(multiclass classification),其中预测 y{1,2,,K}K 个类别之一;以及更复杂的情形。在接下来的两章中,我们将讨论如何找到使这些损失函数最小化的参数值。

5.1 最大似然

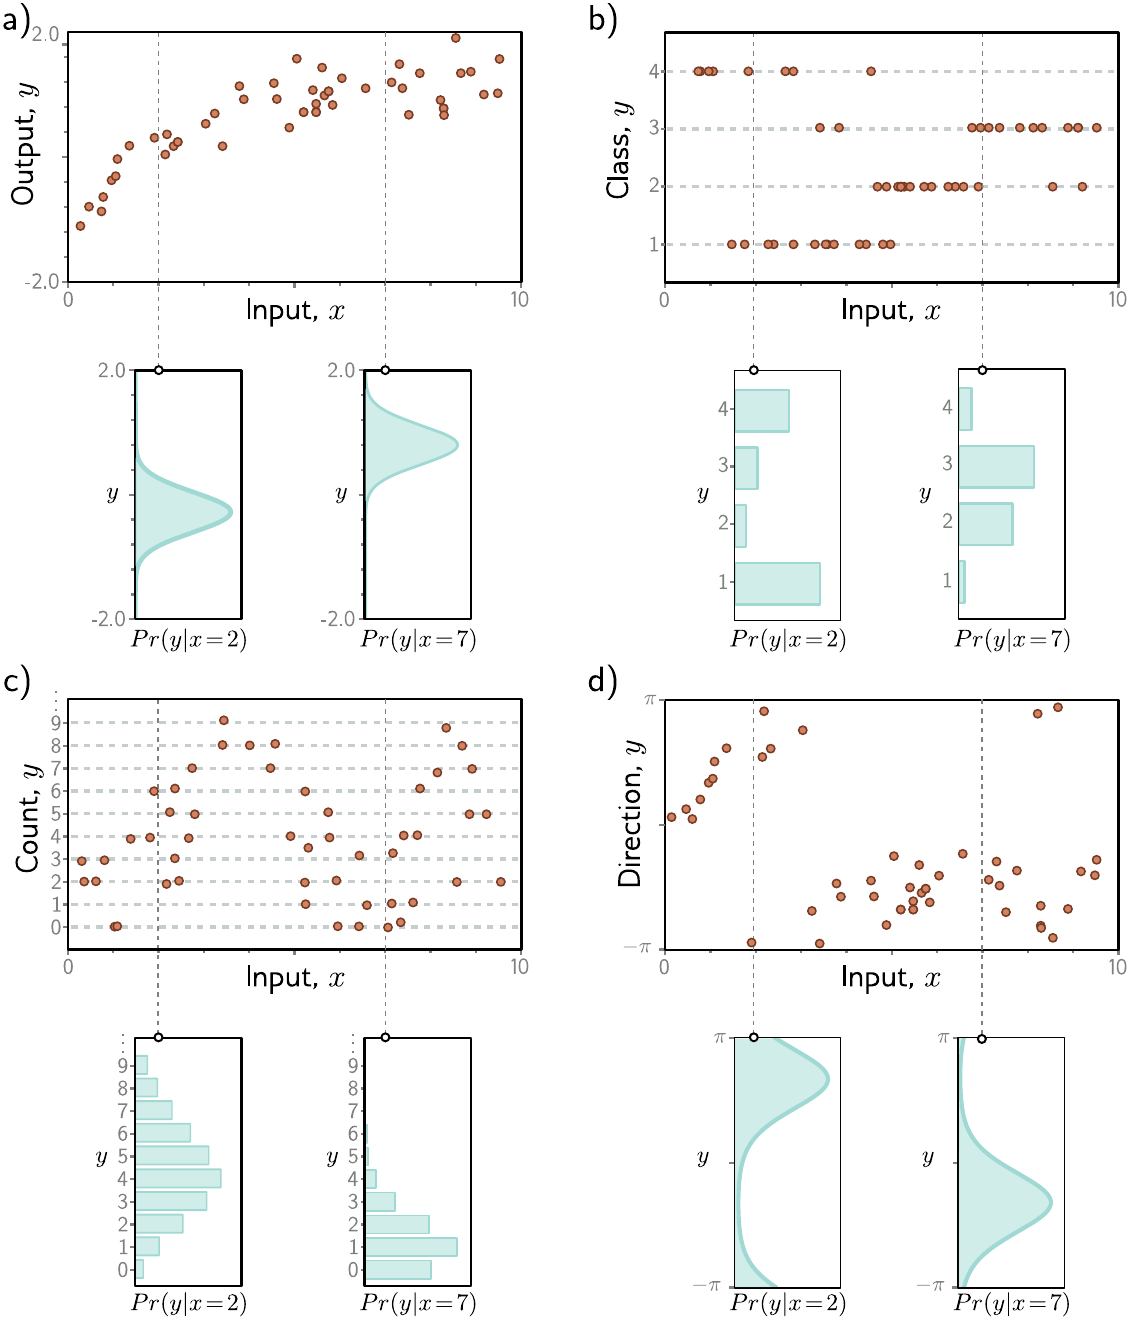
本节我们推导一种构建损失函数的方法。考虑一个模型 f[x,ϕ],它以参数 ϕ 从输入 x 计算输出。到目前为止,我们一直认为模型直接计算预测 y。现在我们转换视角,将模型视为计算给定输入 x 时可能输出 y 上的条件概率分布 Pr(y|x)。损失鼓励每个训练输出 yi 在由对应输入 xi 计算得到的分布 Pr(yi|xi) 下具有高概率(图 5.1)。

图 5.1

图 5.1 预测输出上的分布。a) 回归任务,目标是根据训练数据 {xi,yi}(橙色点)从输入 x 预测实值输出 y。对于每个输入值 x,机器学习模型预测输出 yR 上的一个分布 Pr(y|x)(青色曲线展示了 x=2.0x=7.0 处的分布)。最小化损失函数对应于最大化训练输出 yi 在由对应输入 xi 预测的分布下的概率。b) 对于离散类别 y{1,2,3,4} 的分类任务,我们使用离散概率分布,因此模型为每个 xi 值预测四个可能 yi 值上的不同直方图。c) 对于计数预测 y{0,1,2,} 和 d) 方向预测 y(π,π],我们分别使用定义在正整数和圆形域上的分布。

5.1.1 计算输出上的分布

这种视角转换引出了一个问题:模型 f[x,ϕ] 究竟如何被改造以计算概率分布。解决方案很简单。首先,我们选择一个定义在输出域 y 上的参数化分布 Pr(y|θ)。然后我们使用网络来计算该分布的一个或多个参数 θ

例如,假设预测域是实数集,即 yR。此时我们可以选择单变量正态分布,它定义在 R 上。该分布由均值 μ 和方差 σ2 定义,因此 θ={μ,σ2}。机器学习模型可以预测均值 μ,而方差 σ2 则被视为一个未知常数。

5.1.2 最大似然准则

现在模型为每个训练输入 xi 计算不同的分布参数 θi=f[xi,ϕ]。每个观测到的训练输出 yi 在其对应分布 Pr(yi|θi) 下应具有高概率。因此,我们选择模型参数 ϕ 使得所有 I 个训练样本的联合概率最大化:

(5.1)ϕ^=argmaxϕ[i=1IPr(yi|xi)]=argmaxϕ[i=1IPr(yi|θi)]=argmaxϕ[i=1IPr(yi|f[xi,ϕ])].

联合概率项就是参数的似然(likelihood),因此方程 5.1 被称为最大似然(maximum likelihood)准则。

这里我们隐含地做了两个假设。第一,我们假设输出 yi 上的概率分布形式对于每个数据点都相同。第二,我们假设给定输入后输出的条件分布 Pr(yi|xi)独立的,因此训练数据的总似然可以分解为:

(5.2)Pr(y1,y2,,yI|x1,x2,,xI)=i=1IPr(yi|xi).

5.1.3 最大化对数似然

最大似然准则(方程 5.1)在实践中并不太实用。每一项 Pr(yi|f[xi,ϕ]) 都可能很小,所以许多项的乘积可能会非常微小。在有限精度算术下,可能难以表示这个量。幸运的是,我们可以等价地最大化似然的对数:

(5.3)ϕ^=argmaxϕ[i=1IPr(yi|f[xi,ϕ])]=argmaxϕ[log[i=1IPr(yi|f[xi,ϕ])]]=argmaxϕ[i=1Ilog[Pr(yi|f[xi,ϕ])]].

这个对数似然(log-likelihood)准则是等价的,因为对数是单调递增函数:若 z>z,则 log[z]>log[z],反之亦然(图 5.2)。因此,当我们改变模型参数 ϕ 来改进对数似然准则时,也同时改进了原始的最大似然准则。这也意味着两个准则的全局最大值必定在同一位置,所以最优模型参数 ϕ^ 在两种情况下是相同的。然而,对数似然准则具有使用项的和而非乘积的实际优势,因此用有限精度表示不会有问题。
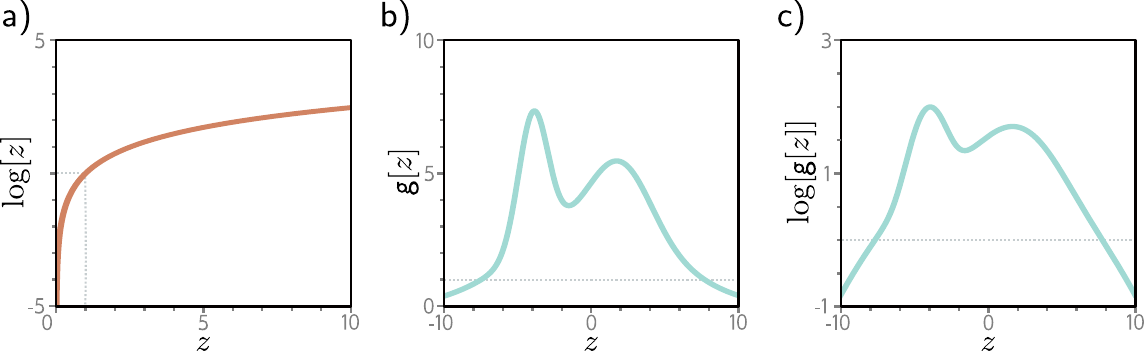
图 5.2

图 5.2 对数变换。a) 对数函数是单调递增的。若 z>z,则 log[z]>log[z]。由此可知,任何函数 g[z] 的最大值与 log[g[z]] 的最大值将出现在同一位置。b) 一个函数 g[z]。c) 该函数的对数 log[g[z]]g[z] 上所有具有正斜率的位置在对数变换后保持正斜率,具有负斜率的位置保持负斜率。最大值的位置不变。

5.1.4 最小化负对数似然

最后,我们注意到,按照惯例,模型拟合问题通常被表述为最小化损失。为了将最大对数似然准则转化为最小化问题,我们乘以负一,得到负对数似然(negative log-likelihood)准则:

(5.4)ϕ^=argminϕ[i=1Ilog[Pr(yi|f[xi,ϕ])]]=argminϕ[L[ϕ]],

这就构成了最终的损失函数 L[ϕ]

5.1.5 推断

网络不再直接预测输出 y,而是确定 y 上的一个概率分布。当我们进行推断时,我们通常需要一个点估计而非一个分布,因此我们返回该分布的最大值:

(5.5)y^=argmaxy[Pr(y|f[x,ϕ^])].

通常可以用模型预测的分布参数 θ 的表达式来求解。例如,在单变量正态分布中,最大值出现在均值 μ 处。

5.2 构建损失函数的方法

使用最大似然方法为训练数据 {xi,yi} 构建损失函数的方法如下:

  1. 选择一个合适的概率分布 Pr(y|θ),定义在预测 y 的域上,具有分布参数 θ
  2. 设定机器学习模型 f[x,ϕ] 来预测这些参数中的一个或多个,使得 θ=f[x,ϕ],且 Pr(y|θ)=Pr(y|f[x,ϕ])
  3. 为训练模型,找到使训练数据集 {xi,yi} 上负对数似然损失函数最小化的网络参数 ϕ^
(5.6)ϕ^=argminϕ[L[ϕ]]=argminϕ[i=1Ilog[Pr(yi|f[xi,ϕ])]].
  1. 对于新的测试样本 x,进行推断时返回完整分布 Pr(y|f[x,ϕ^]) 或该分布取最大值处的值。

本章剩余部分主要使用这一方法为常见的预测类型构建损失函数。

5.3 示例 1:单变量回归

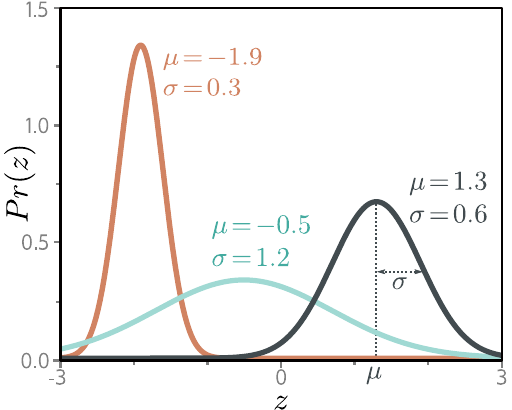
我们首先考虑单变量回归模型。这里的目标是使用模型 f[x,ϕ](参数为 ϕ)从输入 x 预测单个标量输出 yR。按照上述方法,我们选择输出域 y 上的一个概率分布。我们选择单变量正态分布(univariate normal distribution)(图 5.3),它定义在 yR 上。该分布有两个参数(均值 μ 和方差 σ2),密度函数为:

(5.7)Pr(y|μ,σ2)=12πσ2exp[(yμ)22σ2].

然后,我们设定机器学习模型 f[x,ϕ] 来计算该分布的一个或多个参数。这里我们只计算均值,即 μ=f[x,ϕ]

(5.8)Pr(y|f[x,ϕ],σ2)=12πσ2exp[(yf[x,ϕ])22σ2].

我们的目标是找到使训练数据 {xi,yi} 在该分布下最为可能的参数 ϕ(图 5.4)。为此,我们基于负对数似然选择损失函数 L[ϕ]

(5.9)L[ϕ]=i=1Ilog[Pr(yi|f[xi,ϕ],σ2)]=i=1Ilog[12πσ2exp[(yif[xi,ϕ])22σ2]].

训练模型时,我们寻找使该损失最小化的参数 ϕ^

图 5.3

图 5.3 单变量正态分布(也称高斯分布)定义在实数线 zR 上,有参数 μσ2。均值 μ 决定峰值的位置。方差 σ2 的正平方根(标准差)决定分布的宽度。由于概率密度总和为一,随着方差减小,峰值变高,分布变窄。

5.3.1 最小二乘损失函数

现在我们对损失函数进行一些代数化简。我们要求:

ϕ^=argminϕ[i=1Ilog[12πσ2exp[(yif[xi,ϕ])22σ2]]]=argminϕ[i=1I(log[12πσ2](yif[xi,ϕ])22σ2)]=argminϕ[i=1I(yif[xi,ϕ])22σ2](5.10)=argminϕ[i=1I(yif[xi,ϕ])2],

其中第二行到第三行之间去掉了第一项,因为它不依赖于 ϕ。第三行到第四行之间去掉了分母,因为这只是一个不影响最小值位置的正常数缩放因子。

这些化简的结果就是我们在第 2 章讨论线性回归时最初引入的最小二乘损失函数:

(5.11)L[ϕ]=i=1I(yif[xi,ϕ])2.

我们看到,最小二乘损失函数自然地从以下假设中推导出来:(i) 预测是独立的,且 (ii) 从均值为 μ=f[xi,ϕ] 的正态分布中抽取(图 5.4)。
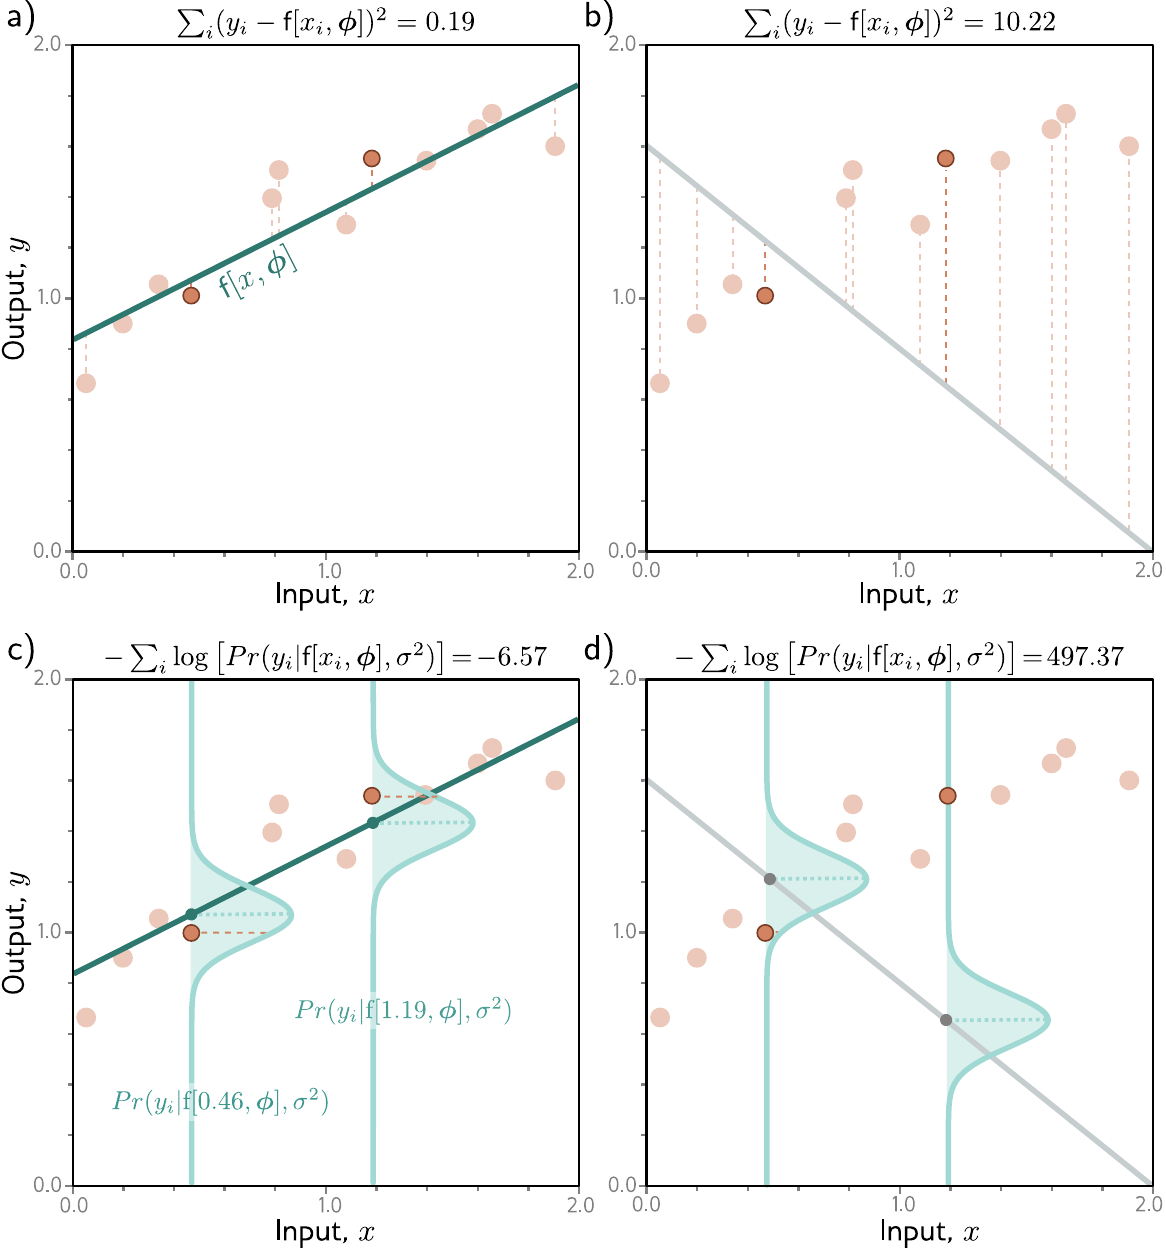
图 5.4

图 5.4 正态分布下最小二乘与最大似然损失的等价性。a) 考虑图 2.2 中的线性模型。最小二乘准则最小化模型预测 f[xi,ϕ](绿色线)与真实输出值 yi(橙色点)之间偏差(虚线)的平方和。此处拟合效果好,因此偏差很小。b) 对于这组参数,拟合效果差,偏差的平方和很大。c) 最小二乘准则源于假设模型预测的是输出上正态分布的均值,且我们最大化概率。对于第一种情况,模型拟合良好,所以数据的概率 Pr(yi|xi)(水平橙色虚线)很大(负对数概率很小)。d) 对于第二种情况,模型拟合差,概率很小,负对数概率很大。

5.3.2 推断

网络不再直接预测 y,而是预测正态分布在 y 上的均值 μ=f[x,ϕ]。当我们进行推断时,我们通常需要一个单一的"最佳"点估计 y^,因此我们取预测分布的最大值:

(5.12)y^=argmaxy[Pr(y|f[x,ϕ^],σ2)].

对于单变量正态分布,最大值由均值参数 μ 决定(图 5.3)。这恰恰就是模型计算的值,因此 y^=f[x,ϕ^]

5.3.3 方差估计

为了推导最小二乘损失函数,我们假设网络预测正态分布的均值。方程 5.11 中的最终表达式(或许令人惊讶地)不依赖于方差 σ2。然而,我们完全可以将 σ2 也作为学习参数,同时对模型参数 ϕ 和分布方差 σ2 最小化方程 5.9:

(5.13)ϕ^,σ^2=argminϕ,σ2[i=1Ilog[12πσ2exp[(yif[xi,ϕ])22σ2]]].

在推断时,模型从输入预测均值 μ=f[x,ϕ^],而方差 σ^2 则在训练过程中学习得到。前者是最佳预测,后者告诉我们预测的不确定性。

5.3.4 异方差回归

上述模型假设数据的方差处处恒定。然而,这可能不现实。当模型的不确定性随输入数据的变化而变化时,我们称之为异方差(heteroscedastic)(与不确定性恒定的同方差(homoscedastic)相对)。

建模这种情况的一种简单方式是训练一个同时计算均值和方差的神经网络 f[x,ϕ]。例如,考虑一个具有两个输出的浅层网络。我们将第一个输出记为 f1[x,ϕ] 并用它来预测均值,将第二个输出记为 f2[x,ϕ] 并用它来预测方差。

这里有一个复杂之处:方差必须为正,但我们无法保证网络总是产生正的输出。为确保计算出的方差为正,我们将第二个网络输出通过一个将任意值映射为正值的函数。一个合适的选择是平方函数,这给出:

μ=f1[x,ϕ](5.14)σ2=f2[x,ϕ]2,

由此得到的损失函数为:

(5.15)ϕ^=argminϕ[i=1I(log[12πf2[xi,ϕ]2](yif1[xi,ϕ])22f2[xi,ϕ]2)].

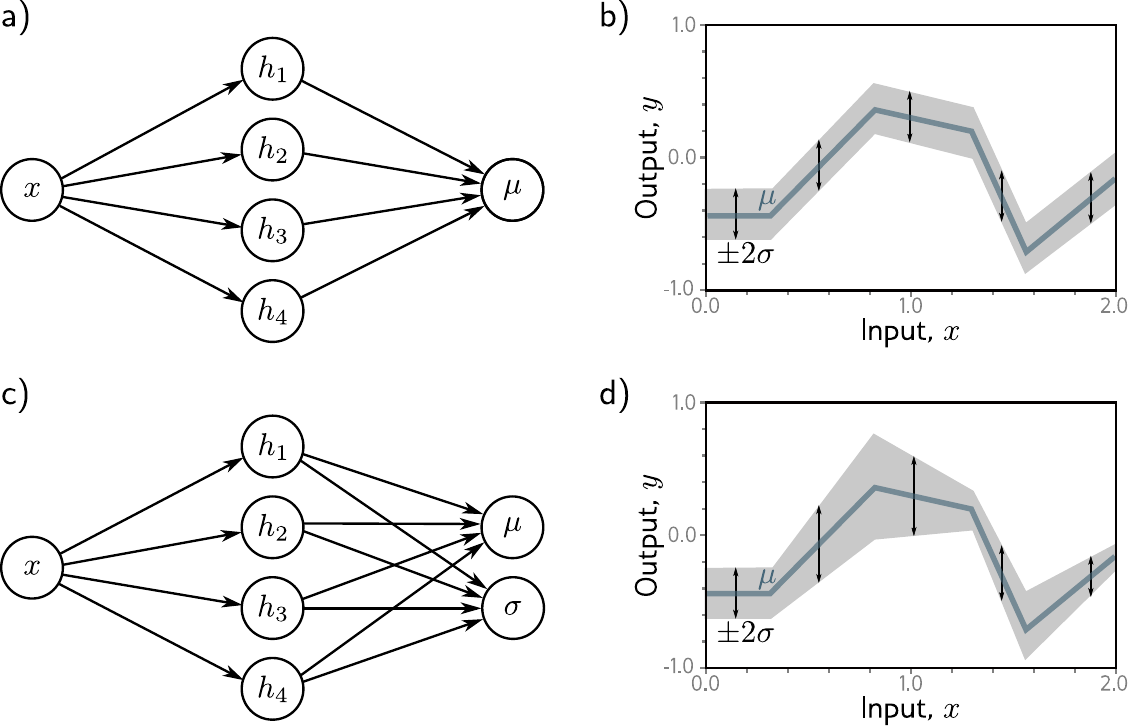
同方差和异方差模型在图 5.5 中进行了比较。

图 5.5

图 5.5 同方差与异方差回归。a) 同方差回归的浅层神经网络仅预测输出分布的均值 μ。b) 结果是,虽然均值(蓝色线)是输入 x 的分段线性函数,但方差处处恒定(箭头和灰色区域表示 ±2 个标准差)。c) 异方差回归的浅层神经网络还预测方差 σ2(或更精确地说,计算其平方根后再平方)。d) 标准差现在也成为输入 x 的分段线性函数。

5.4 示例 2:二元分类

二元分类(binary classification)中,目标是将数据 x 分配到两个离散类别 y{0,1} 之一。在此情境下,我们将 y 称为标签(label)。二元分类的例子包括:(i) 根据文本数据 x 预测餐厅评论是正面的(y=1)还是负面的(y=0),以及 (ii) 根据 MRI 扫描图像 x 预测肿瘤是存在的(y=1)还是不存在的(y=0)。

我们再次按照第 5.2 节的方法来构建损失函数。首先,我们选择输出空间 y{0,1} 上的概率分布。一个合适的选择是伯努利分布(Bernoulli distribution),它定义在域 {0,1} 上。它有一个参数 λ[0,1],表示 y 取值为 1 的概率(图 5.6):

(5.16)Pr(y|λ)={1λy=0λy=1,

也可以等价地写为:

(5.17)Pr(y|λ)=(1λ)1yλy.

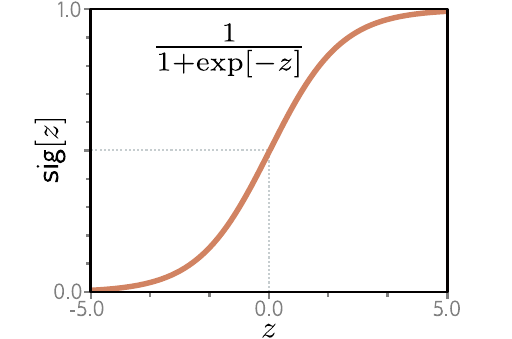
然后,我们设定机器学习模型 f[x,ϕ] 来预测唯一的分布参数 λ。然而,λ 只能取 [0,1] 范围内的值,而我们无法保证网络输出也在此范围内。因此,我们将网络输出通过一个将 R 映射到 [0,1] 的函数。一个合适的函数是逻辑 sigmoid(logistic sigmoid)(图 5.7):

(5.18)sig[z]=11+exp[z].

因此,我们将分布参数预测为 λ=sig[f[x,ϕ]]。似然函数现在为:

(5.19)Pr(y|x)=(1sig[f[x,ϕ]])1ysig[f[x,ϕ]]y.

图 5.8 展示了浅层神经网络模型的这一情形。损失函数是训练集的负对数似然:

(5.20)L[ϕ]=i=1I(1yi)log[1sig[f[xi,ϕ]]]yilog[sig[f[xi,ϕ]]].

正如将在第 5.7 节中解释的,这被称为二元交叉熵损失(binary cross-entropy loss)。

经过变换的模型输出 sig[f[x,ϕ]] 预测伯努利分布的参数 λ。它表示 y=1 的概率,由此可得 1λ 表示 y=0 的概率。当我们进行推断时,我们可能需要 y 的点估计,因此如果 λ>0.5 则令 y=1,否则令 y=0
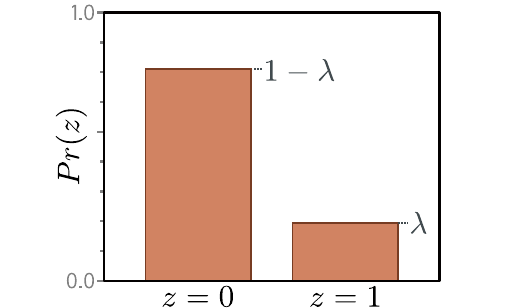
图 5.6

图 5.6 伯努利分布。伯努利分布定义在域 z{0,1} 上,有一个参数 λ,表示观测到 z=1 的概率。由此可得观测到 z=0 的概率为 1λ

图 5.7

图 5.7 逻辑 sigmoid 函数。该函数将实数线 zR 映射到零和一之间的数,即 sig[z][0,1]。输入 0 被映射到 0.5。负输入被映射到小于 0.5 的数,正输入被映射到大于 0.5 的数。
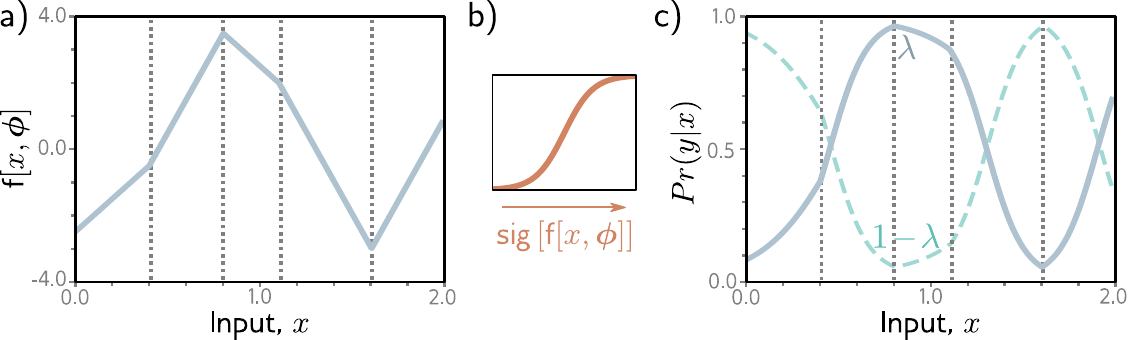
图 5.8

图 5.8 二元分类模型。a) 网络输出是一个可以取任意实数值的分段线性函数。b) 经逻辑 sigmoid 函数变换后,将这些值压缩到 [0,1] 范围。c) 变换后的输出预测 y=1 的概率 λ(实线)。y=0 的概率因此为 1λ(虚线)。对于任何固定的 x(垂直切面),我们可以得到类似于图 5.6 中伯努利分布的两个值。损失函数偏好使与正例 yi=1 关联的 xi 位置处的 λ 值较大、与负例 yi=0 关联的 xi 位置处的 λ 值较小的模型参数。

5.5 示例 3:多类分类

多类分类(multiclass classification)的目标是将输入数据样本 x 分配到 K>2 个类别之一,即 y{1,2,,K}。实际应用包括:(i) 预测一幅手写数字图像 x 中存在 K=10 个数字中的哪一个,以及 (ii) 预测 K 个可能的单词 y 中哪一个跟在不完整句子 x 之后。

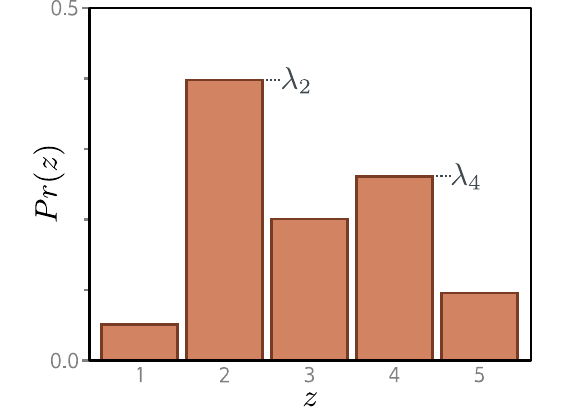
我们再次按照第 5.2 节的方法。首先在预测空间 y 上选择一个分布。在本例中,y{1,2,,K},因此我们选择类别分布(categorical distribution)(图 5.9),它定义在此域上。该分布有 K 个参数 λ1,λ2,,λK,决定每个类别的概率:

(5.21)Pr(y=k)=λk.

这些参数被约束在零和一之间取值,且必须总和为一,以确保构成有效的概率分布。

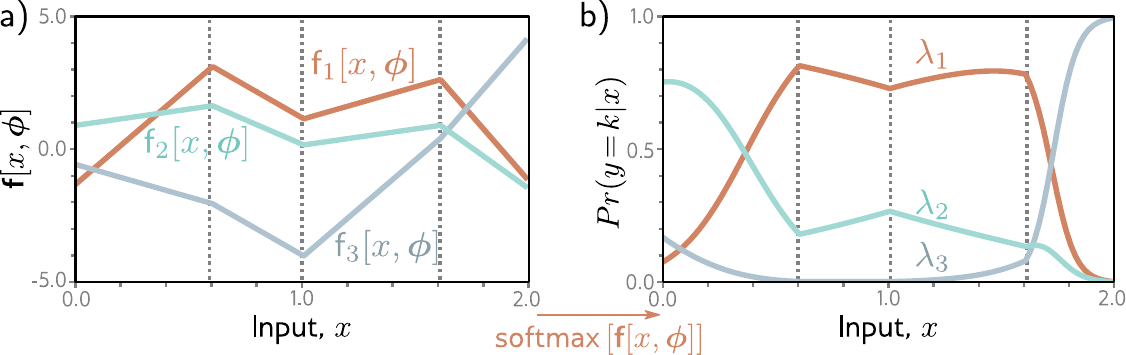
然后我们使用一个具有 K 个输出的网络 f[x,ϕ],从输入 x 计算这 K 个参数。不幸的是,网络输出不一定满足上述约束。因此,我们将网络的 K 个输出通过一个确保满足约束的函数。一个合适的选择是 softmax 函数(图 5.10)。它接收一个长度为 K 的任意向量,返回一个同样长度的向量,但其中元素位于 [0,1] 范围内且总和为一。softmax 函数的第 k 个输出为:

(5.22)softmaxk[z]=exp[zk]k=1Kexp[zk],

其中指数函数确保正性,分母中的求和确保这 K 个数之和为一。

输入 x 具有标签 y=k 的似然(图 5.10)因此为:

(5.23)Pr(y=k|x)=softmaxk[f[x,ϕ]].

损失函数是训练数据的负对数似然:

(5.24)L[ϕ]=i=1Ilog[softmaxyi[f[xi,ϕ]]]=i=1I(fyi[xi,ϕ]log[k=1Kexp[fk[xi,ϕ]]]),

其中 fyi[xi,ϕ]fk[xi,ϕ] 分别表示网络的第 yi 个和第 k 个输出。正如将在第 5.7 节中解释的,这被称为多类交叉熵损失(multiclass cross-entropy loss)。

经变换的模型输出表示可能类别 y{1,2,,K} 上的类别分布。为获得点估计,我们取最可能的类别 y^=argmaxk[Pr(y=k|f[x,ϕ^])]。这对应于图 5.10 中该 x 值处最高曲线所属的类别。

图 5.9

图 5.9 类别分布。类别分布将概率分配给 K>2 个类别,其关联概率为 λ1,λ2,,λK。此处有五个类别,即 K=5。为确保这是一个有效的概率分布,每个参数 λk 必须在 [0,1] 范围内,且所有 K 个参数之和必须为一。

图 5.10

图 5.10 K=3 类的多类分类。a) 网络有三个分段线性输出,可取任意值。b) 经 softmax 函数处理后,这些输出被约束为非负且和为一。因此,对于给定输入 x,我们计算出类别分布的有效参数:该图的任何垂直切面产生三个和为一的值,它们构成类似于图 5.9 中类别分布的条形高度。

5.5.1 预测其他数据类型

本章我们聚焦于回归和分类,因为这些问题最为普遍。然而,对于不同类型的预测,我们只需在该域上选择合适的分布,并按照第 5.2 节的方法即可。图 5.11 列举了一系列概率分布及其预测域。其中一些在本章末尾的习题中进行了探讨。

图 5.11 不同预测类型对应的分布。

数据类型分布用途
单变量、连续、无界yR单变量正态回归
单变量、连续、无界yR拉普拉斯或 t 分布鲁棒回归
单变量、连续、无界yR混合高斯多模态回归
单变量、连续、下有界yR+指数或伽马预测幅度
单变量、连续、有界y[0,1]beta预测比例
多变量、连续、无界yRK多变量正态多变量回归
单变量、连续、圆形y(π,π]von Mises预测方向
单变量、离散、二元y{0,1}伯努利二元分类
单变量、离散、有界y{1,2,,K}类别多类分类
单变量、离散、下有界y{0,1,2,3,}泊松预测事件计数
多变量、离散、排列yPerm[1,2,,K]Plackett-Luce排序

5.6 多输出

通常我们希望用同一个模型做出不止一个预测,因此目标输出 y 是一个向量。例如,我们可能想预测某分子的熔点和沸点(多变量回归问题,图 1.2b),或图像中每个像素的物体类别(多变量分类问题,图 1.4a)。虽然可以定义多变量概率分布并使用神经网络将其参数建模为输入的函数,但更常见的做法是将每个预测视为独立的。

独立性意味着我们将概率 Pr(y|f[x,ϕ]) 处理为 y 中每个元素 yd 的单变量项的乘积:

(5.25)Pr(y|f[x,ϕ])=dPr(yd|fd[x,ϕ]),

其中 fd[x,ϕ] 是网络输出的第 d 组,描述 yd 上分布的参数。例如,要预测多个连续变量 ydR,我们对每个 yd 使用正态分布,网络输出 fd[x,ϕ] 预测这些分布的均值。要预测多个离散变量 yd{1,2,,K},我们对每个 yd 使用类别分布。此时,每组网络输出 fd[x,ϕ] 预测 yd 的类别分布所需的 K 个值。

当我们最小化负对数概率时,这个乘积变成项的和:

(5.26)L[ϕ]=i=1Ilog[Pr(yi|f[xi,ϕ])]=i=1Idlog[Pr(yid|fd[xi,ϕ])],

其中 yid 是第 i 个训练样本的第 d 个输出。

要同时进行两种或更多预测类型,我们类似地假设各自的误差是独立的。例如,要预测风向和风力,我们可以选择 von Mises 分布(定义在圆形域上)来预测方向,选择指数分布(定义在正实数上)来预测强度。独立性假设意味着两个预测的联合似然是各自似然的乘积。在计算负对数似然时,这些项变成加和关系。

5.7 交叉熵损失

本章我们推导了最小化负对数似然的损失函数。然而,交叉熵(cross-entropy)损失这一术语也很常见。本节描述交叉熵损失,并证明它等价于使用负对数似然。

交叉熵损失基于这样一种思想:找到参数 θ,使得观测数据 y 的经验分布 q(y) 与模型分布 Pr(y|θ) 之间的距离最小化(图 5.12)。两个概率分布 q(z)p(z) 之间的距离可以用 Kullback-Leibler (KL) 散度来衡量:

(5.27)DKL[q||p]=q(z)log[q(z)]dzq(z)log[p(z)]dz.

现在考虑我们在点 {yi}i=1I 处观察到一个经验数据分布。我们可以将其描述为点质量的加权和:

(5.28)q(y)=1Ii=1Iδ[yyi],

其中 δ[]Dirac delta 函数。我们希望最小化模型分布 Pr(y|θ) 与该经验分布之间的 KL 散度:

θ^=argminθ[q(y)log[q(y)]dyq(y)log[Pr(y|θ)]dy](5.29)=argminθ[q(y)log[Pr(y|θ)]dy],

其中第一项消失了,因为它不依赖于 θ。剩余的第二项称为交叉熵(cross-entropy)。它可以被解释为在考虑了我们从另一个分布中已知信息后,一个分布中剩余的不确定性量。现在将方程 5.28 中 q(y) 的定义代入:

θ^=argminθ[(1Ii=1Iδ[yyi])log[Pr(y|θ)]dy]=argminθ[1Ii=1Ilog[Pr(yi|θ)]](5.30)=argminθ[i=1Ilog[Pr(yi|θ)]].

第一行到第二行的乘积对应于将图 5.12a 中的点质量与图 5.12b 中分布的对数逐点相乘。我们得到以数据点为中心的加权概率质量的有限集。在最后一行,我们消去了常数缩放因子 1/I,因为它不影响最小值的位置。

在机器学习中,分布参数 θ 由模型 f[xi,ϕ] 计算,因此我们有:

(5.31)ϕ^=argminϕ[i=1Ilog[Pr(yi|f[xi,ϕ])]].

这恰恰就是第 5.2 节方法中的负对数似然准则。

由此可知,负对数似然准则(来自最大化数据似然)和交叉熵准则(来自最小化模型分布与经验数据分布之间的距离)是等价的。
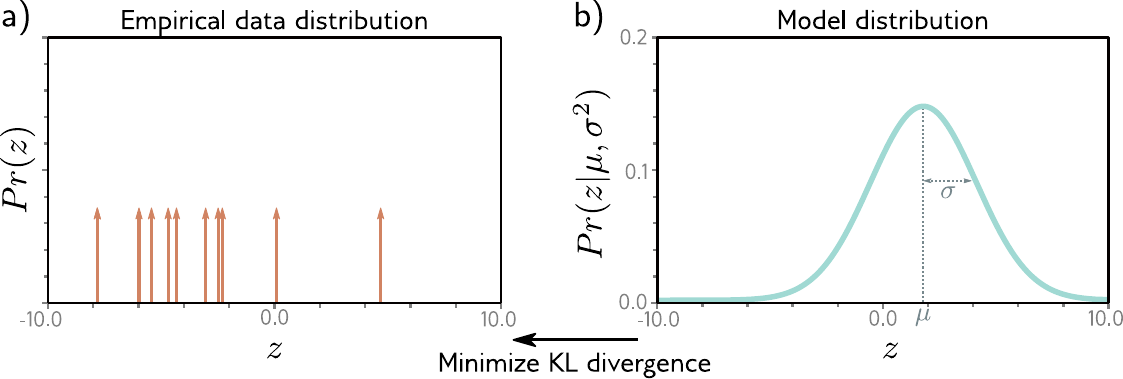
图 5.12

图 5.12 交叉熵方法。a) 训练样本的经验分布(箭头表示 Dirac delta 函数)。b) 具有参数 θ={μ,σ2} 的模型分布(正态分布)。在交叉熵方法中,我们最小化这两个分布之间的距离(KL 散度),将其作为模型参数 θ 的函数。

5.8 总结

我们之前将神经网络视为直接从数据 x 预测输出 y。在本章中,我们转换视角,将神经网络视为计算输出空间上概率分布 Pr(y|θ) 的参数 θ。这导出了一种构建损失函数的有原则方法。我们选择使观测数据在这些分布下的似然最大化的模型参数 ϕ。我们看到这等价于最小化负对数似然。

最小二乘回归准则是这一方法的自然结果;它源于假设 y 服从正态分布且我们预测的是均值。我们还讨论了如何将回归模型扩展为 (i) 估计预测的不确定性,以及 (ii) 使不确定性依赖于输入(异方差模型)。我们将同样的方法应用于二元分类和多类分类,并推导出各自的损失函数。我们讨论了如何处理更复杂的数据类型以及如何处理多输出。最后,我们论证了交叉熵是思考模型拟合的一种等价方式。

在前面的章节中,我们建立了神经网络模型。在本章中,我们建立了损失函数来判断模型在给定参数下对训练数据的描述效果。下一章考虑模型训练,目标是找到使该损失最小化的模型参数。

基于 CC-BY-NC-ND 许可协议