
第17章 变分自编码器
生成对抗网络学习一种机制,生成与训练样本
常见的说法是把 VAE 当作
本章首先介绍一般的潜变量模型,然后考虑非线性潜变量模型的特定情形。我们将看到,该模型的最大似然学习并不直观。然而,可以定义似然的一个下界,VAE 架构使用蒙特卡罗(采样)方法来近似这个下界。本章最后介绍 VAE 的若干应用。
17.1 潜变量模型
潜变量模型采用一种间接方法来描述多维变量
通常,联合概率
这是描述
17.1.1 示例:高斯混合模型
在一维高斯混合模型(图 17.1a)中,潜变量
如等式 17.2 所述,概率
通过简单的似然和先验表达式,我们描述了一个复杂的多模态概率分布。
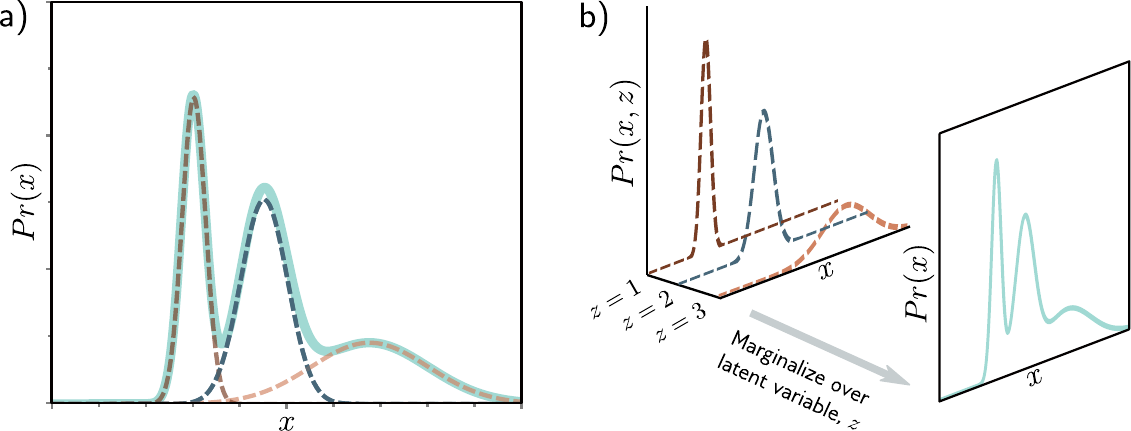
图 17.1 高斯混合模型(MoG)。a) MoG 将一个复杂的概率分布(青色曲线)描述为高斯分量(虚线曲线)的加权和。b) 这个和是连续观测数据
与离散潜变量 之间的联合密度 的边缘化。
17.2 非线性潜变量模型
在非线性潜变量模型中,数据
似然
函数
数据概率
这可以看作球形高斯的无限加权和(即无限混合),其中权重是
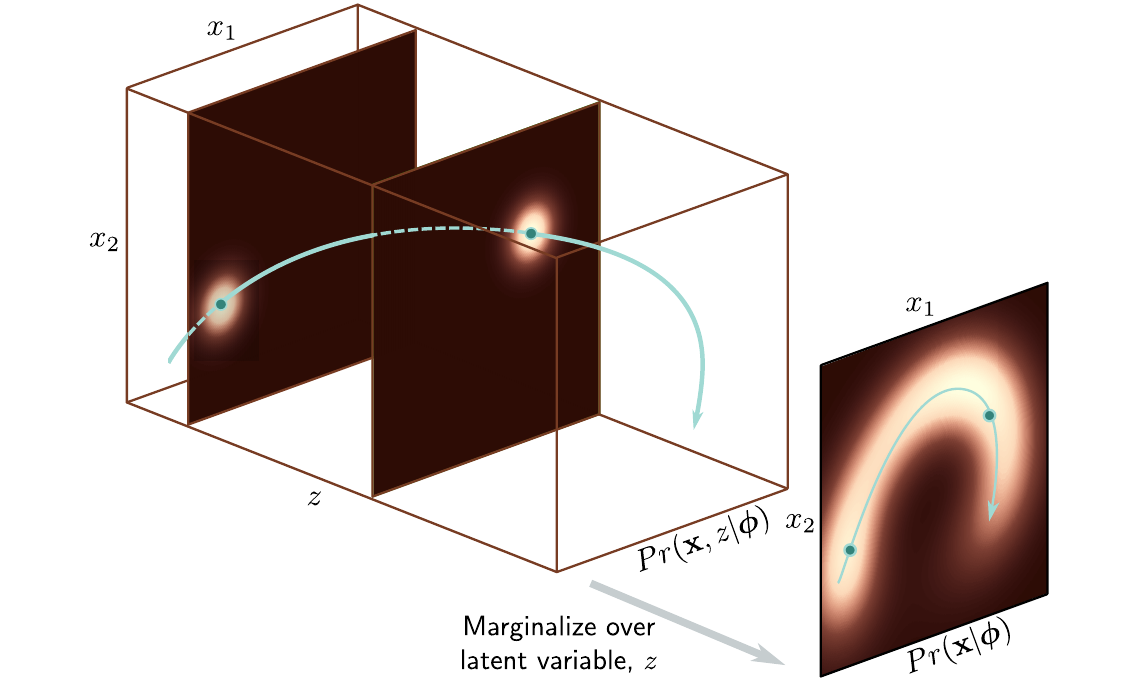
图 17.2 非线性潜变量模型。一个复杂的二维密度
(右)是通过对联合分布 (左)在潜变量 上的边缘化来创建的;为了创建 ,我们对 维度上的三维体积进行积分。对于每个 , 上的分布是一个球形高斯(展示了两个切片),其均值 是 的非线性函数且依赖于参数 。分布 是这些高斯的加权和。
17.2.1 生成
可以使用祖先采样(ancestral sampling)生成新样本
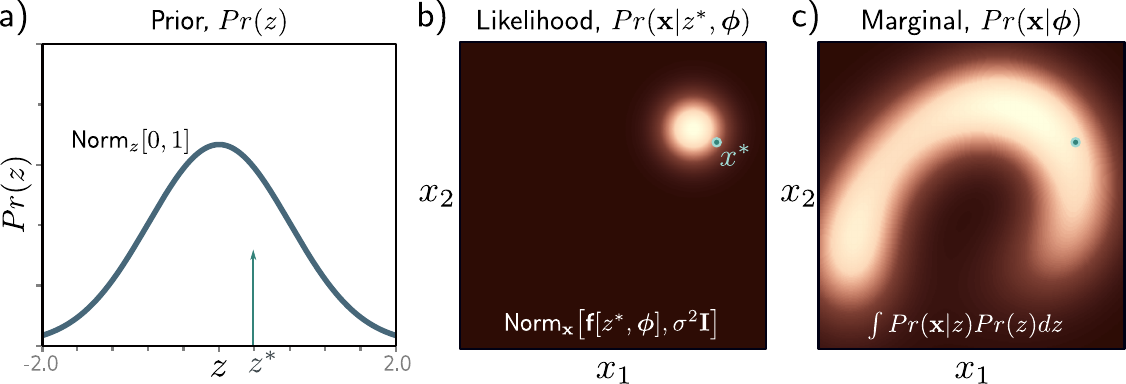
图 17.3 从非线性潜变量模型生成。a) 从潜变量的先验概率
中抽取样本 。b) 从 中抽取样本 。这是一个球形高斯,其均值是 的非线性函数 且方差固定为 。c) 如果重复多次这个过程,就恢复了密度 。
17.3 训练
为了训练模型,我们最大化训练数据集
其中:
不幸的是,这个积分是不可处理的(intractable)。对于该积分不存在封闭形式的表达式,也没有简便方法对特定值
17.3.1 证据下界(ELBO)
为了取得进展,我们定义对数似然的一个下界(lower bound)。这是一个函数,对于给定的
17.3.2 Jensen 不等式
Jensen 不等式指出,凹函数(concave function)
在此情形下,凹函数是对数函数,因此有:
或者将期望写成完整表达式:
这在图 17.4-17.5 中有所探讨。事实上,稍微更一般的陈述也成立:
其中
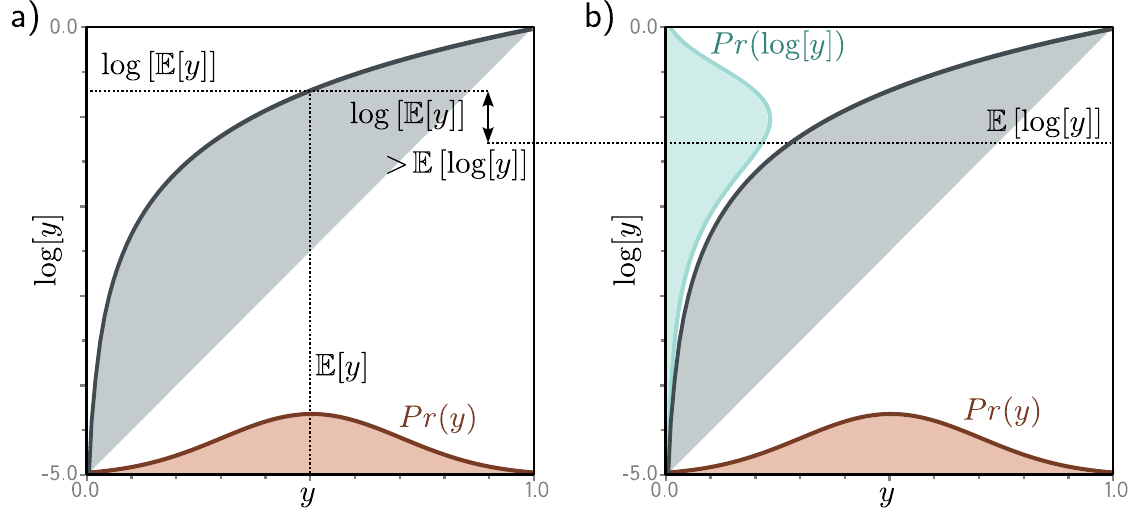
图 17.4 Jensen 不等式(离散情形)。对数函数(黑色曲线)是一个凹函数;你可以在曲线上任意两点之间画一条直线,这条直线始终在曲线下方。因此,对数函数上六个点的任何凸组合(正权重且和为一的加权和)都必须落在曲线下方的灰色区域中。这里,我们对这些点等权平均,得到青色点。由于该点在曲线下方,
。
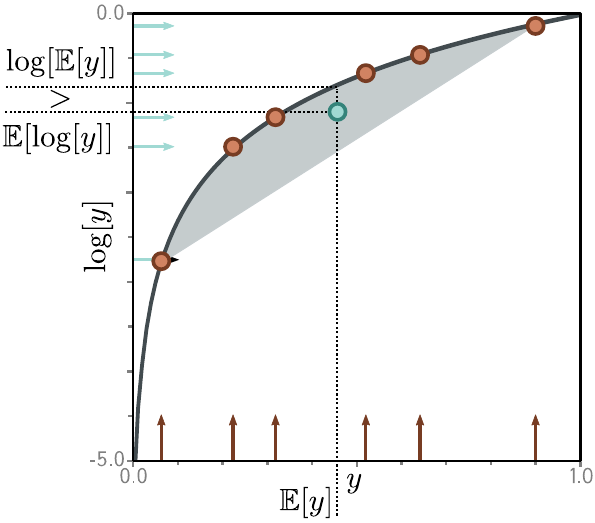
图 17.5 Jensen 不等式(连续情形)。对于凹函数,计算分布
的期望并将其通过函数,得到的结果大于或等于先将变量 通过函数再计算新变量的期望。对于对数函数,有 。
17.3.3 推导下界
我们现在使用 Jensen 不等式来推导对数似然的下界。首先,将对数似然乘以并除以关于潜变量的任意概率分布
然后对对数函数使用 Jensen 不等式(等式 17.12)来求下界:
其中右边的项称为证据下界(evidence lower bound)或 ELBO。之所以得此名称,是因为
实际上,分布
为了学习非线性潜变量模型,我们将这个量作为
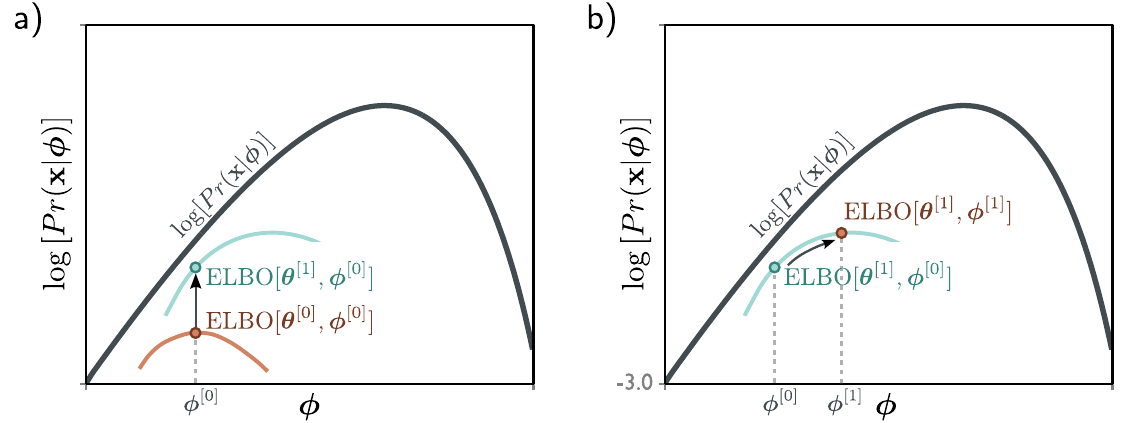
图 17.6 证据下界(ELBO)。目标是最大化关于参数
的对数似然 (黑色曲线)。ELBO 是一个处处位于对数似然下方的函数。它是 和第二组参数 的函数。固定 ,我们得到 的一条曲线(两条彩色曲线对应 的不同值)。因此,我们可以通过改进 a) 新参数 (从彩色曲线移到彩色曲线)或 b) 原参数 (沿当前彩色曲线移动)来增加对数似然。
17.4 ELBO 的性质
初次遇到 ELBO 时,它是一个有些神秘的对象,因此我们现在提供一些关于其性质的直觉。考虑原始的数据对数似然是参数
17.4.1 下界的紧致性
当对于固定的
其中,第三行和第四行之间,第一个积分消失了,因为
这个等式表明,ELBO 是原始对数似然减去 KL 散度
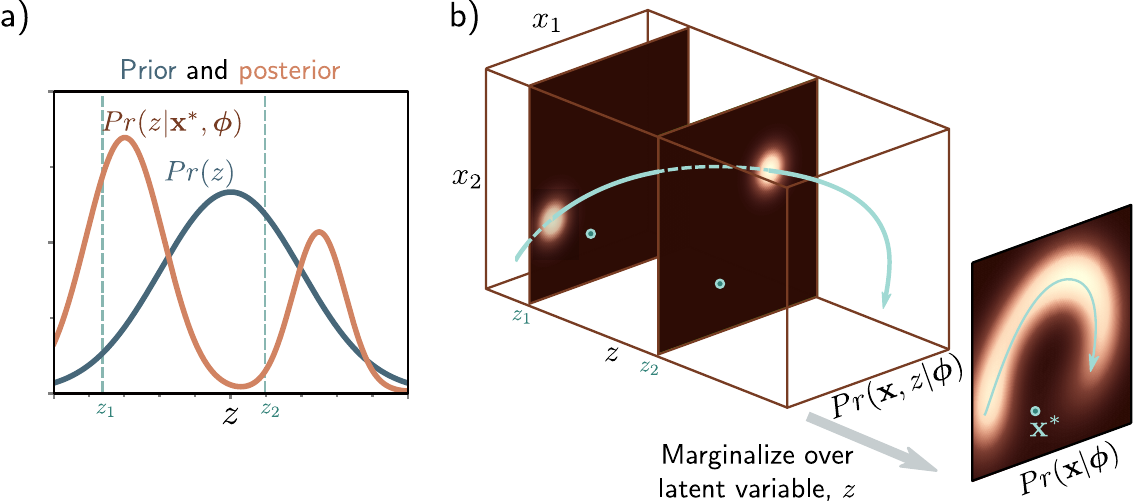
图 17.7 潜变量上的后验分布。a) 后验分布
是在给定数据点 时,潜变量 的取值上的分布。我们通过贝叶斯法则 来计算。b) 右侧第一项(似然)通过评估 对于每个 值在对称高斯下的概率来计算。这里,它更可能由 而非 产生。第二项是潜变量上的先验概率 。将这两个因子相乘并归一化使分布和为一,就得到后验 。
17.4.2 ELBO 作为重构损失减去与先验的 KL 距离
等式 17.16 和 17.17 是表达 ELBO 的两种不同方式。第三种方式是将下界视为重构误差减去与先验的距离:
其中联合分布
在这个表述中,第一项衡量潜变量和数据之间
17.5 变分近似
我们在等式 17.17 中看到,当
但实际上这是不可处理的,因为我们无法计算分母中的证据项
一种解决方案是做变分近似(variational approximation):我们为
由于
其中
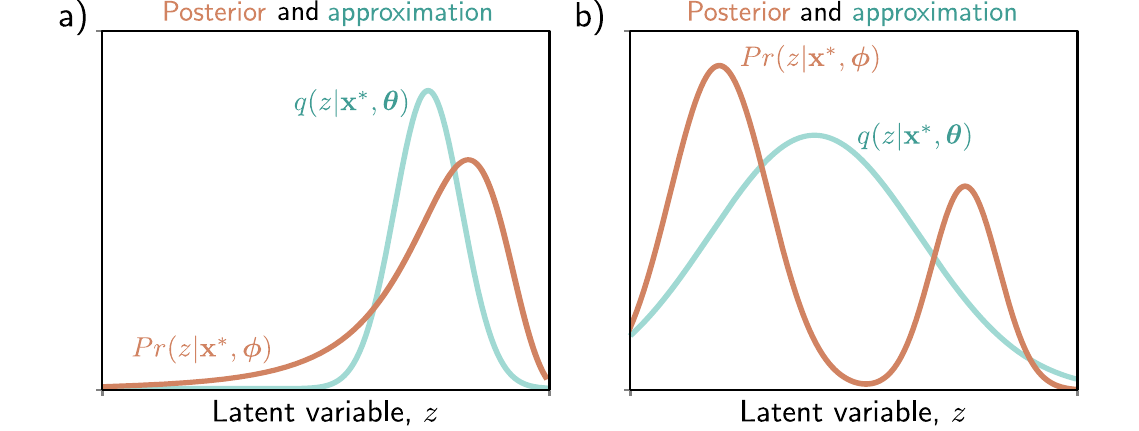
图 17.8 变分近似。后验
无法以封闭形式计算。变分近似选择一族分布 (这里是高斯分布),试图找到这个族中与真实后验最接近的成员。a) 有时近似效果很好(青色曲线),与真实后验(橙色曲线)很接近。b) 然而,如果后验是多模态的(如图 17.7),那么高斯近似就会很差。
17.6 变分自编码器
最后,我们可以描述 VAE。我们构建一个计算 ELBO 的网络:
其中分布
第一项仍然涉及一个不可处理的积分,但由于它是关于
其中
第二项是变分分布
其中
17.6.1 VAE 算法
总结一下,我们旨在构建一个计算数据点
- 使用网络
计算该数据点变分后验分布 的均值 和方差 , - 从该分布中抽取样本
,以及 - 使用等式 17.23 计算 ELBO。
相关的架构如图 17.9 所示。现在应该清楚为什么称之为变分自编码器了。它是变分的,因为它计算了后验的高斯近似。它是自编码器,因为它从数据点
VAE 将 ELBO 计算为
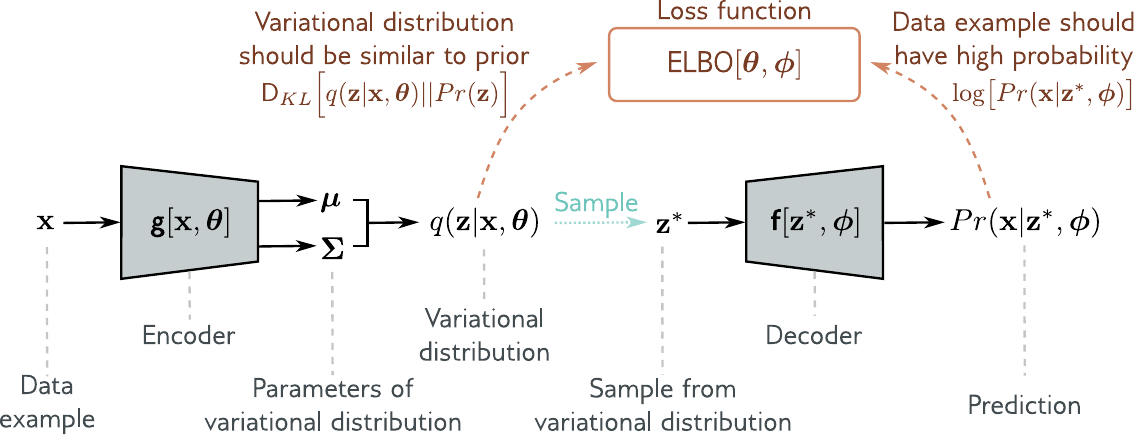
图 17.9 变分自编码器。编码器
接收训练样本 ,预测变分分布 的参数 。我们从该分布中采样,然后使用解码器 预测数据 。损失函数是负 ELBO,取决于预测的准确性以及变分分布 与先验 的相似程度(等式 17.21)。
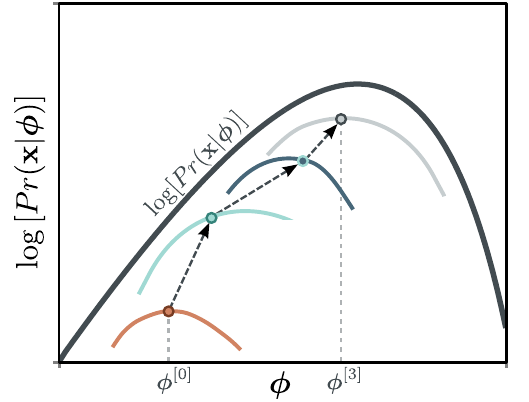
图 17.10 VAE 在每次迭代中更新决定下界的两个因素。解码器的参数
和编码器的参数 都被操纵以增加这个下界。
17.7 重参数化技巧
还有一个复杂之处;网络涉及一个采样步骤,很难对这个随机分量进行微分。然而,通过这个步骤进行微分对于更新网络中它之前的参数
幸运的是,有一个简单的解决方案;我们可以将随机部分移到网络的一个分支中,该分支从
从目标高斯分布中抽样。现在我们可以照常计算导数,因为反向传播算法不需要通过随机分支传递。这被称为重参数化技巧(reparameterization trick)(图 17.11)。
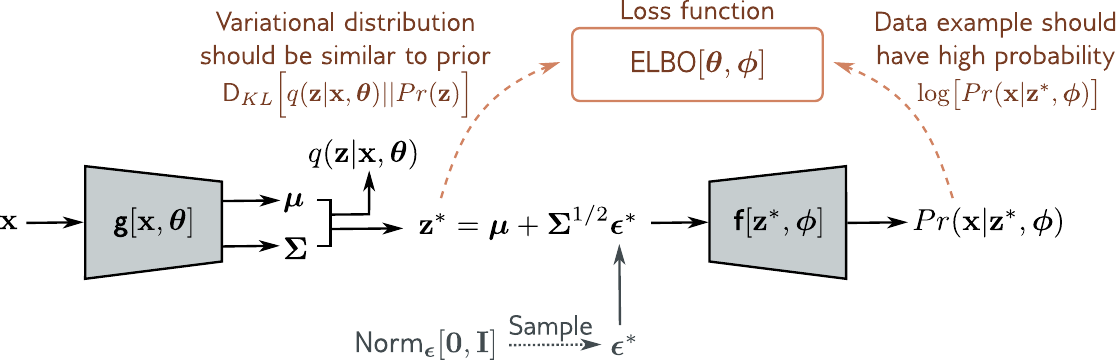
图 17.11 重参数化技巧。在原始架构(图 17.9)中,我们无法轻易地通过采样步骤进行反向传播。重参数化技巧将采样步骤从主管道中移出;我们从标准正态分布中抽样,并将其与预测的均值和协方差结合以获得变分分布的样本。
17.8 应用
变分自编码器有许多用途,包括去噪、异常检测和压缩。本节回顾图像数据的几个应用。
17.8.1 近似样本概率
在第 17.3 节中,我们论证了用 VAE 无法评估样本的概率,该模型将这个概率描述为:
原则上,我们可以使用等式 17.22,从
然而,维度灾难意味着几乎所有我们抽取的
其中现在样本从
我们尝试积分的乘积
这样,我们可以近似新样本的概率。有了足够多的样本,这将提供比下界更好的估计,可以用来通过评估测试数据的对数似然来评价模型质量。或者,它可以用作判断新样本是否属于该分布或是否异常的标准。
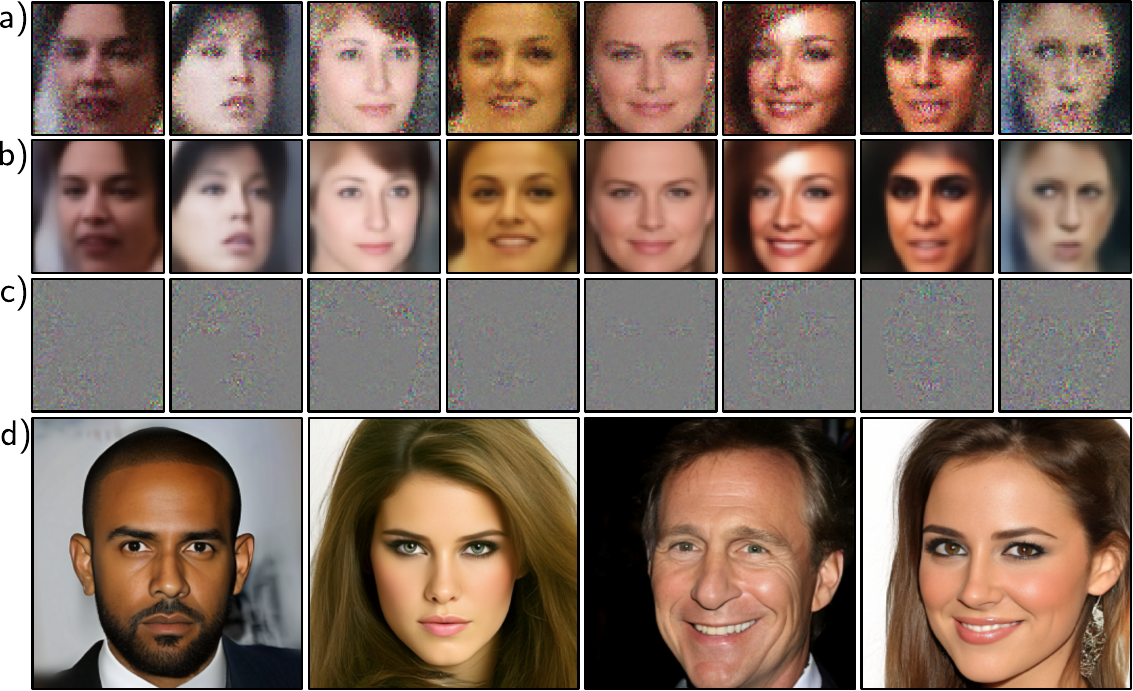
图 17.12 从在 CELEBA 上训练的标准 VAE 采样。每列中抽取一个潜变量
,通过模型预测均值 ,然后加上独立的高斯噪声(见图 17.3)。a) 一组样本,是 b) 预测均值和 c) 球形高斯噪声向量的和。加噪声前图像看起来太平滑,加噪声后又太嘈杂。这是典型的,通常展示无噪声版本,因为噪声被认为代表图像中未建模的方面。改编自 Dorta et al. (2018)。d) 现在可以使用层次先验、专门的架构和仔细的正则化从 VAE 生成高质量图像。改编自 Vahdat & Kautz (2020)。
17.8.2 生成
VAE 构建了一个概率模型,很容易从该模型中采样,方法是从潜变量上的先验
现代 VAE 可以产生高质量样本(图 17.12d),但只能通过使用层次先验和专门的网络架构与正则化技术实现。扩散模型(第 18 章)可以视为具有层次先验的 VAE。它们也能创建非常高质量的样本。
17.8.3 重合成
VAE 也可以用来修改真实数据。数据点
在图 17.13 中,多个标记为"中性"或"微笑"的图像被投影到潜空间中。表示这种变化的向量通过取这两组均值的差来估计。第二个向量估计表示"嘴巴闭合"与"嘴巴张开"。
现在,感兴趣的图像被投影到潜空间,然后通过加减这些向量来修改表示。为了生成中间图像,使用球面线性插值(spherical linear interpolation)或 Slerp 而非线性插值。在三维空间中,这就是沿球面表面插值与在球体内直接挖隧道之间的区别。
编码(并可能修改)输入数据然后再解码的过程被称为重合成(resynthesis)。这也可以用 GAN 和归一化流来完成。然而,在 GAN 中没有编码器,因此必须使用单独的过程来找到与观测数据对应的潜变量。
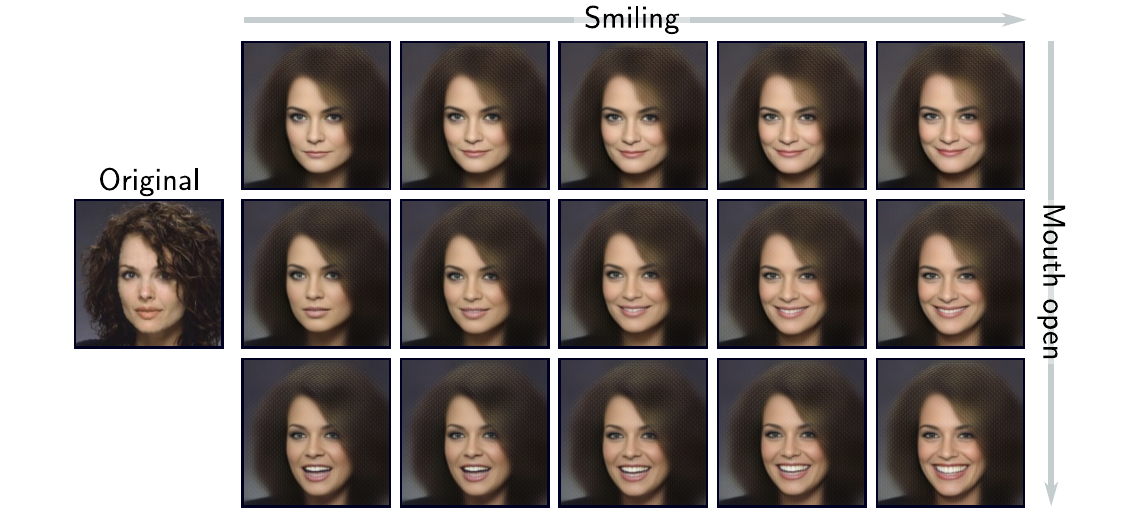
图 17.13 重合成。左侧的原始图像使用编码器投影到潜空间,预测的高斯均值被选为表示该图像。网格中心左侧的图像是输入的重构。其他图像是在潜空间中沿表示微笑/中性(水平)和嘴巴张开/闭合(垂直)方向操纵后的重构。改编自 White (2016)。
17.8.4 解缠
在上述重合成示例中,表示可解释属性的空间方向必须使用标注的训练数据来估计。其他工作试图改善潜空间的特性,使其坐标方向对应于真实世界的属性。当每个维度代表一个独立的真实世界因素时,潜空间被描述为解缠的(disentangled)。例如,在建模人脸图像时,我们可能希望将头部姿态或发色作为独立因素发现出来。
鼓励解缠的方法通常基于 (i) 后验
其中正则化项
例如,beta VAE 上调了 ELBO 中的第二项(等式 17.18):
其中
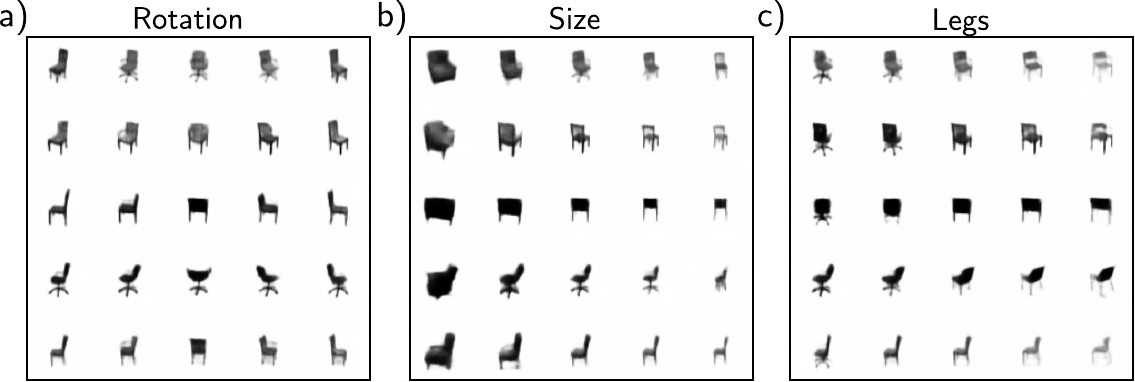
图 17.14 总相关 VAE 中的解缠。VAE 模型被修改使得损失函数鼓励潜变量的总相关性被最小化,从而鼓励解缠。在椅子图像数据集上训练时,几个潜维度具有清晰的真实世界解释,包括 a) 旋转、b) 整体大小和 c) 椅腿(转椅 vs 普通椅)。在每种情况下,中间列展示模型的样本,向左或向右移动时,我们在潜空间中减去或添加一个坐标向量。改编自 Chen et al. (2018d)。
17.9 总结
VAE 是一种帮助学习数据
无法以封闭形式计算数据点的似然,这给最大似然训练带来了困难。然而,我们可以定义似然的下界并最大化这个下界。不幸的是,为了使下界紧致,我们需要计算给定观测数据时潜变量的后验概率,而这也是不可处理的。解决方案是做变分近似。这是一个更简单的分布(通常是高斯分布),近似后验,其参数由第二个编码器网络计算。
为了从 VAE 创建高质量样本,似乎有必要用比高斯先验和后验更复杂的概率分布来建模潜空间。一种选择是使用层次先验(其中一个潜变量生成另一个)。下一章讨论扩散模型,它产生非常高质量的样本,并可以视为层次 VAE。