
第7章 梯度与初始化
第 6 章介绍了迭代优化算法。这些算法是用于求函数最小值的通用方法。在神经网络的场景下,它们寻找使损失最小化的参数,从而使模型能够从输入准确预测训练输出。基本方法是随机选择初始参数,然后进行一系列小的调整,使损失平均而言逐步降低。每次调整都基于损失对当前位置处参数的梯度。
本章讨论两个神经网络特有的问题。首先,我们考虑如何高效地计算梯度。这是一个严峻的挑战,因为撰写本书时最大的模型拥有约
7.1 问题定义
考虑一个网络
其中函数
我们还有单个损失项
训练神经网络最常用的优化算法是随机梯度下降(SGD),它按如下方式更新参数:
其中
对每层
在本章第二部分,我们考虑在训练开始前如何初始化网络参数。我们描述选择初始权重
7.2 计算导数
损失的导数告诉我们,当对参数做出微小改变时,损失如何变化。优化算法利用这一信息来调整参数以使损失减小。反向传播算法计算这些导数。其数学细节较为复杂,因此我们先做两个直观观察。
观察 1:
观察 2: 偏置或权重的微小改变会引起后续网络中的一连串变化。该改变修改其目标隐藏单元的值。这进而改变后续层中隐藏单元的值,然后再改变更后面一层的隐藏单元,如此传递,直到改变模型输出,最终改变损失。
因此,要知道改变一个参数如何影响损失,我们还需要知道后续每个隐藏层的变化如何传递给其后继者。在考虑同一层或更早层的其他参数时,也需要这些同样的量。因此我们可以一次性计算并重复利用它们。例如,考虑计算馈入隐藏层
- 要计算馈入隐藏层
的权重或偏置的微小改变如何影响损失,我们需要知道 (i) 层 的变化如何改变模型输出 ,以及 (ii) 输出的变化如何改变损失 (图 7.2a)。 - 要计算馈入隐藏层
的权重或偏置的微小改变如何影响损失,我们需要知道 (i) 层 的变化如何影响 ,(ii) 如何改变模型输出,以及 (iii) 输出如何改变损失(图 7.2b)。 - 要计算馈入隐藏层
的权重或偏置的微小改变如何影响损失,我们需要知道 (i) 层 的变化如何影响层 ,(ii) 层 的变化如何影响层 ,(iii) 层 如何改变模型输出,以及 (iv) 模型输出如何改变损失(图 7.2c)。

图 7.1 反向传播前向传播。目标是计算损失
关于每个权重(箭头)和偏置(未显示)的导数。换言之,我们想知道每个参数的微小改变将如何影响损失。每个权重将其源处的隐藏单元激活值相乘,并将结果贡献给目标处的隐藏单元。因此,对权重的任何微小改变的效果都会被源隐藏单元的激活值缩放。例如,蓝色权重作用于第 1 层的第二个隐藏单元;如果该单元的激活值翻倍,则对蓝色权重微小改变的效果也会翻倍。因此,要计算权重的导数,我们需要计算并存储隐藏层处的激活值。这被称为前向传播,因为它涉及按顺序运行网络方程。

图 7.2 反向传播的反向传播。a) 要计算馈入层
的权重(蓝色箭头)的改变如何影响损失,我们需要知道 中的隐藏单元如何改变模型输出 ,以及 如何改变损失(橙色箭头)。b) 要计算馈入 的权重(蓝色箭头)的微小改变如何影响损失,我们需要知道 (i) 中的隐藏单元如何改变 ,(ii) 如何改变 ,以及 (iii) 如何改变损失(橙色箭头)。c) 类似地,要计算馈入 的权重(蓝色箭头)的微小改变如何影响损失,我们需要知道 如何改变 ,以及这些改变如何通过网络传播到损失(橙色箭头)。反向传播先在网络末端计算导数,然后反向回溯以利用这些计算中固有的冗余性。
当我们反向遍历网络时,可以发现大多数所需的项已在前一步中计算过,无需重复计算。以这种方式反向遍历网络来计算导数,被称为反向传播(backward pass)。
反向传播背后的思想相对容易理解。然而,推导需要矩阵微积分,因为偏置项和权重项分别是向量和矩阵。为了帮助理解其底层机制,下一节先用一个更简单的标量参数玩具模型来推导反向传播。然后我们在 7.4 节将同样的方法应用于深度神经网络。
7.3 玩具示例
考虑一个模型
以及最小二乘损失函数
其中
我们的目标是计算导数:
当然,我们可以手动推导这些导数的表达式并直接计算它们。但是,其中一些表达式相当复杂。例如:
这类表达式既难以正确推导和编码,又未能利用其中固有的冗余性;注意上式中三个指数项是相同的。
反向传播算法是一种高效的方法,可同时计算所有这些导数。它包含 (i) 前向传播,在其中我们计算并存储一系列中间值和网络输出;以及 (ii) 反向传播,在其中我们从网络末端开始计算每个参数的导数,并在向起点回溯时重复利用先前的计算。
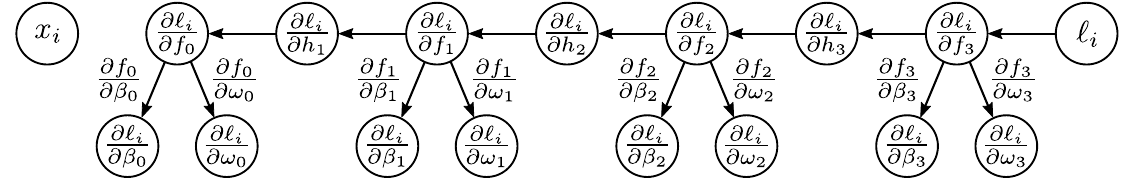
图 7.3 反向传播前向传播。我们依次计算并存储每个中间变量,直到最终计算出损失。
前向传播: 我们将损失的计算视为一系列计算步骤:
我们计算并存储中间变量
反向传播 #1: 现在我们计算
第一个导数很直接:
下一个导数可以用链式法则计算:
左边询问当
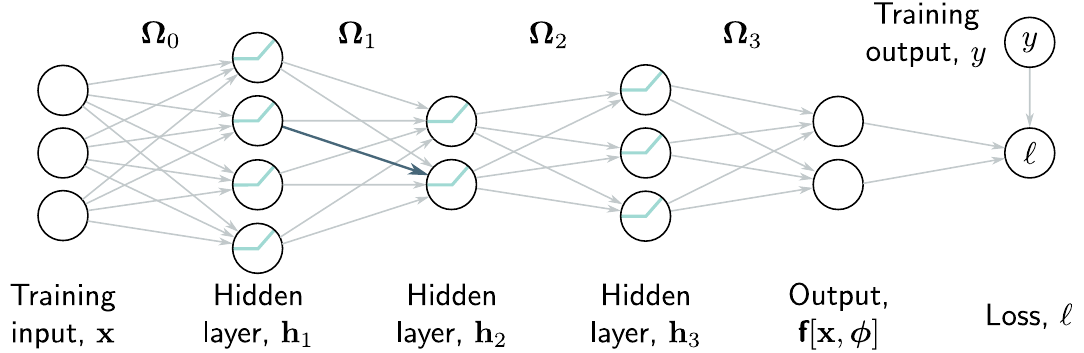
图 7.4 反向传播的反向传播 #1。我们从函数末端反向计算损失关于中间量的导数
和 。每个导数由前一个导数乘以 或 形式的项得到。
我们以这种方式继续,计算输出关于这些中间量的导数(图 7.4):
在每种情况下,括号内的量已在上一步中计算过,最后一项具有简单的表达式。这些方程体现了上一节的观察 2(图 7.2);如果我们按逆序计算,就可以重复利用之前计算过的导数。
反向传播 #2: 最后,我们考虑当参数
在每种情况下,右边的第二项已在方程 7.13 中计算过。当
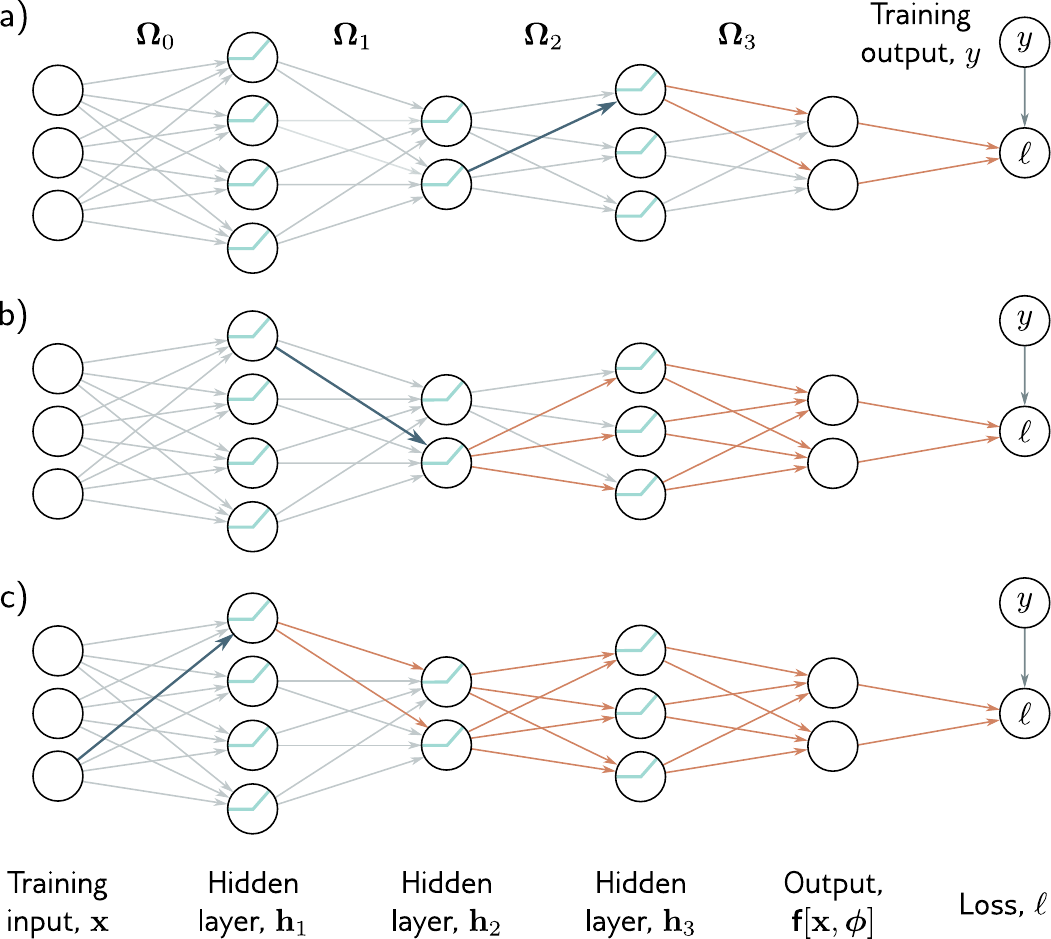
图 7.5 反向传播的反向传播 #2。最后,我们计算
和 。每个导数由 乘以 或 得到。
这与上一节的观察 1 一致;权重
反向传播比单独计算各导数(如方程 7.8)既简单又高效。
7.4 反向传播算法
现在我们对三层网络(图 7.1)重复这一过程。直觉和大部分代数运算是相同的。主要区别在于中间变量
前向传播: 我们将网络写为一系列顺序计算:
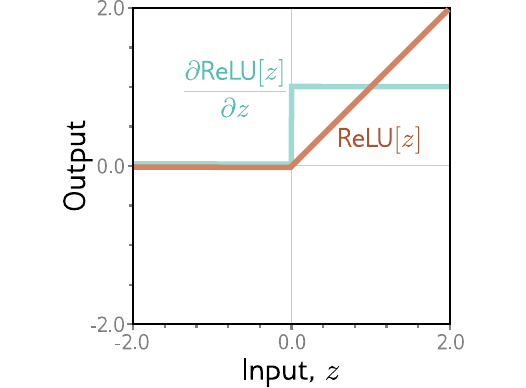
图 7.6 修正线性单元的导数。修正线性单元(橙色曲线)在输入小于零时返回零,否则返回输入本身。它的导数(青色曲线)在输入小于零时返回零(因为此处斜率为零),在输入大于零时返回一(因为此处斜率为一)。
其中
反向传播 #1: 现在让我们考虑当预激活值
右边三项的大小分别为
类似地,我们可以计算当
注意在每种情况下,括号内的项已在前一步中计算过。通过反向遍历网络,我们可以重复利用先前的计算。
此外,各项本身都很简单。反向计算方程 7.18 右边的各项,我们有:
损失
关于网络输出 的导数 取决于损失函数,但通常具有简单的形式。 网络输出关于隐藏层
的导数 为:
如果你不熟悉矩阵微积分,这个结果可能不太直观。
- 激活函数输出
关于其输入 的导数 取决于激活函数。它将是一个对角矩阵,因为每个激活值只取决于对应的预激活值。对于 ReLU 函数,对角项在 小于零的地方为零,其余地方为一(图 7.6)。我们不实际乘以这个矩阵,而是提取对角项作为向量 并进行逐元素乘法,这样更高效。
方程 7.19 和 7.20 右边的项具有类似的形式。当我们反向遍历网络时,交替执行 (i) 乘以权重矩阵
反向传播 #2: 现在我们知道如何计算
这已在方程 7.18 和 7.19 中计算过。
类似地,权重矩阵
从第二行到第三行的推导并不显然。然而,这个结果很有意义。最终结果是一个与
7.4.1 反向传播算法总结
我们现在简要总结最终的反向传播算法。考虑一个深度神经网络
前向传播: 我们计算并存储以下量:
反向传播: 我们从损失函数
其中
我们对批次中的每个训练样本计算这些导数,并将它们求和以得到 SGD 更新所需的梯度。
注意反向传播算法极为高效;前向传播和反向传播中计算量最大的步骤都是矩阵乘法(分别乘以
7.4.2 自动微分
虽然理解反向传播算法很重要,但在实践中你不太可能需要自己编写它。现代深度学习框架如 PyTorch 和 TensorFlow 能根据模型规格自动计算导数。这被称为自动微分(algorithmic differentiation)。
框架中的每个功能组件(线性变换、ReLU 激活、损失函数)都知道如何计算自身的导数。例如,PyTorch 的 ReLU 函数
这些框架利用了现代图形处理单元(GPU)的大规模并行性。前向传播和反向传播中的矩阵乘法等计算天然适合并行化。此外,如果模型和前向传播中的中间结果不超过可用内存,还可以对整个批次并行执行前向传播和反向传播。
由于训练算法现在并行处理整个批次,输入变成了多维张量(tensor)。在这个语境下,张量可以看作矩阵向任意维度的推广。因此,向量是一维张量,矩阵是二维张量,三维网格的数字是三维张量。到目前为止,训练数据都是一维的,所以反向传播的输入将是一个二维张量,其中第一个维度索引批次元素,第二个维度索引数据维度。在后续章节中,我们将遇到更复杂的结构化输入数据。例如,当输入是 RGB 图像时,原始数据样本是三维的(高度 × 宽度 × 通道)。此时,学习框架的输入将是一个四维张量,其中额外的维度索引批次元素。
7.4.3 扩展到任意计算图
我们描述的反向传播是在一个自然顺序结构的深度神经网络中进行的;我们依次计算中间量
幸运的是,只要计算图是无环的,反向传播的思想仍然适用。现代自动微分框架(如 PyTorch 和 TensorFlow)能够处理任意的无环计算图。
7.5 参数初始化
反向传播算法计算随机梯度下降和 Adam 所使用的导数来训练模型。现在我们讨论在训练开始前如何初始化参数。要理解这为何至关重要,考虑在前向传播中,每组预激活值
其中
如果方差
非常小(例如 ),则 的每个元素将是 各元素的加权和,而权重非常小;结果可能具有比输入更小的幅度。此外,ReLU 函数将小于零的值截断,因此 的值域将是 的一半。结果是,随着网络深度的推进,隐藏层预激活值的幅度会越来越小。 如果方差
非常大(例如 ),则 的每个元素将是 各元素的加权和,而权重非常大;结果可能具有比输入大得多的幅度。ReLU 函数将值域减半,但如果 足够大,预激活值的幅度仍会随着网络深度的推进而越来越大。
在这两种情况下,预激活值可能变得如此之小或如此之大,以至于无法用有限精度浮点运算来表示。
即使前向传播是可处理的,同样的逻辑也适用于反向传播。每次梯度更新(方程 7.25)都包含乘以
7.5.1 前向传播的初始化
我们现在给出上述论点的数学版本。考虑相邻预激活值
其中
假设输入层
中间值
其中
利用这个结果,我们可以看到预激活值
其中我们使用了方差恒等式
假设前一层的预激活值
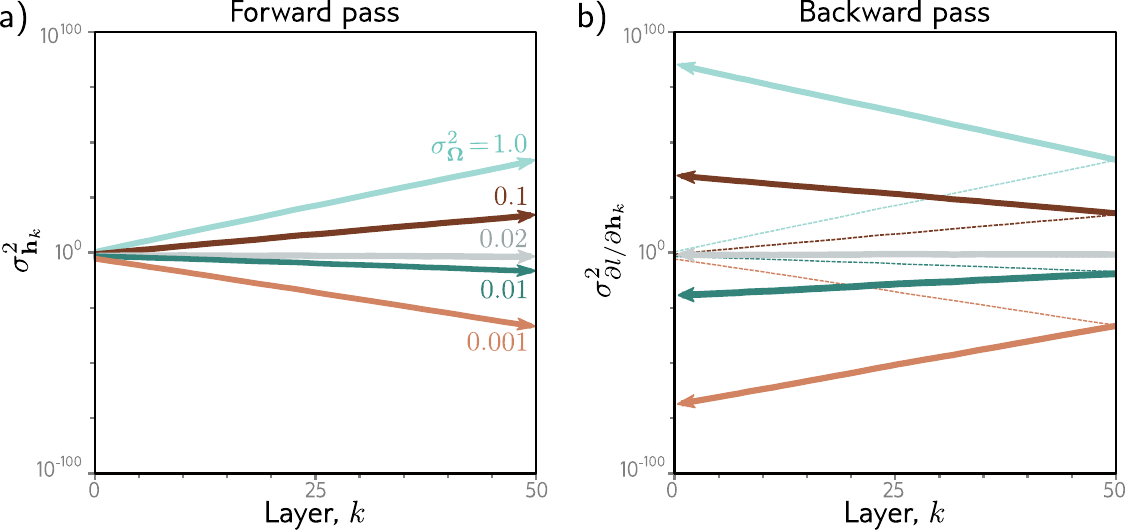
图 7.7 权重初始化。考虑一个有 50 个隐藏层、每层
个隐藏单元的深度网络。网络有 100 维输入 、单一固定目标 ,使用最小二乘损失函数。偏置向量 初始化为零,权重矩阵 用均值为零、五种不同方差 的正态分布初始化。a) 隐藏单元激活值的方差随网络层数变化。对于 He 初始化( ),方差是稳定的。但对于更大的值,方差快速增加;对于更小的值,方差快速减小(注意纵轴为对数刻度)。b) 反向传播中梯度的方差(实线)延续了这一趋势;如果初始化时使用大于 0.02 的值,梯度幅度在反向传播过程中快速增加。如果使用更小的值,则幅度减小。这分别被称为梯度爆炸和梯度消失问题。
这意味着,如果我们希望后续预激活值
其中
7.5.2 反向传播的初始化
类似的论证建立了梯度
其中
7.5.3 同时满足前向和反向传播的初始化
如果权重矩阵
图 7.7 展示了经验上,当参数被适当初始化时,前向传播中隐藏单元的方差和反向传播中梯度的方差都保持稳定。
7.6 训练代码示例
本书的主要侧重点是科学性的;这不是一本实现深度学习模型的指南。不过,在图 7.8 中,我们展示了实现本书到目前为止所探讨的思想的 PyTorch 代码。该代码定义了一个神经网络并初始化权重。它创建了随机的输入和输出数据集,并定义了最小二乘损失函数。模型使用带动量的 SGD 在数据上训练,批次大小为 10,共训练 100 个 epoch。学习率初始为 0.01,每 10 个 epoch 减半。
要点在于,虽然深度学习背后的思想相当复杂,但实现却相对简单。例如,反向传播的所有细节都隐藏在一行代码中:loss.backward()。
图 7.8 在随机数据上训练两层网络的示例代码。
7.7 总结
前一章介绍了随机梯度下降(SGD),一种旨在求函数最小值的迭代优化算法。在神经网络的场景下,该算法寻找使损失函数最小化的参数。SGD 依赖于损失函数关于参数的梯度,而这些参数必须在优化开始前被初始化。本章针对深度神经网络解决了这两个问题。
梯度必须为大量参数、批次中的每个成员以及 SGD 的每次迭代进行评估。因此,梯度计算的效率至关重要,为此引入了反向传播算法。仔细的参数初始化同样重要。前向传播中隐藏单元激活值的幅度可能随网络层数呈指数级增长或衰减。反向传播中梯度的幅度也是如此,这些现象分别被称为梯度消失和梯度爆炸问题。两者都会阻碍训练,但可以通过适当的初始化来避免。
至此,我们已经定义了模型和损失函数,也能训练模型了。下一章讨论如何度量模型性能。