
附录C 概率论基础
概率对深度学习至关重要。在监督学习中,深度网络隐含地依赖于损失函数的概率表述。在无监督学习中,生成模型旨在生成与训练数据来自相同概率分布的样本。强化学习在马尔可夫决策过程中进行,这些过程以概率分布来定义。本附录提供机器学习中所用概率的入门知识。
C.1 随机变量与概率分布
随机变量(random variable)
对于离散变量,该分布为每个可能的结果
C.1.1 联合概率
考虑有两个随机变量
这一思想可以扩展到两个以上的变量,因此
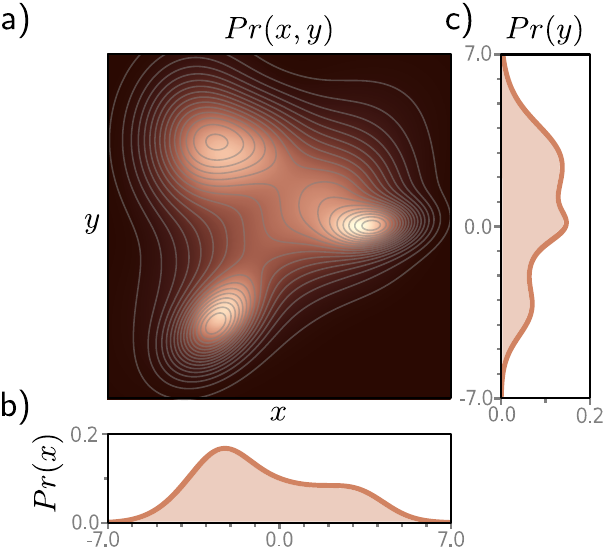
图 C.1 联合分布和边缘分布。a) 联合分布
描述了变量 和 取不同值组合的倾向。这里,概率密度用颜色图表示,较亮的位置概率更大。b) 变量 的边缘分布 可以通过对 积分来恢复。c) 变量 的边缘分布 可以通过对 积分来恢复。
C.1.2 边缘化
如果我们知道两个变量的联合分布
这一过程称为边缘化(marginalization),其含义是我们在计算一个变量的分布时不考虑另一个变量取何值。边缘化的思想可以扩展到更高维度,因此如果我们有联合分布
C.1.3 条件概率与似然
条件概率(conditional probability)
类似地,
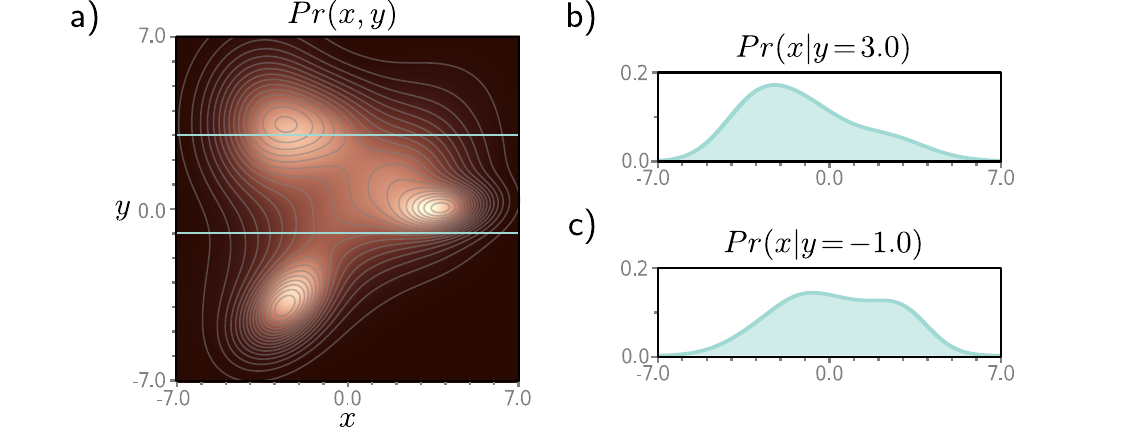
图 C.2 条件分布。a) 变量
和 的联合分布 。b) 在给定变量 取值 3.0 条件下变量 的条件概率 ,通过取联合概率 的水平"切片"(面板 a 中的上方青色线),然后除以该切片的总面积 ,使其形成积分为1的有效概率分布。c) 联合概率 类似地使用 处的切片得到。
当我们将条件概率
C.1.4 贝叶斯规则
从公式 C.3 和 C.4,我们得到联合概率
对其重新排列得到:
这个表达式将
贝叶斯规则中的每一项都有名称。项
C.1.5 独立性
如果随机变量
从公式 C.5 中联合概率的第一个表达式出发,我们看到当变量独立时,联合分布等于边缘分布的乘积:
(图 C.3)。
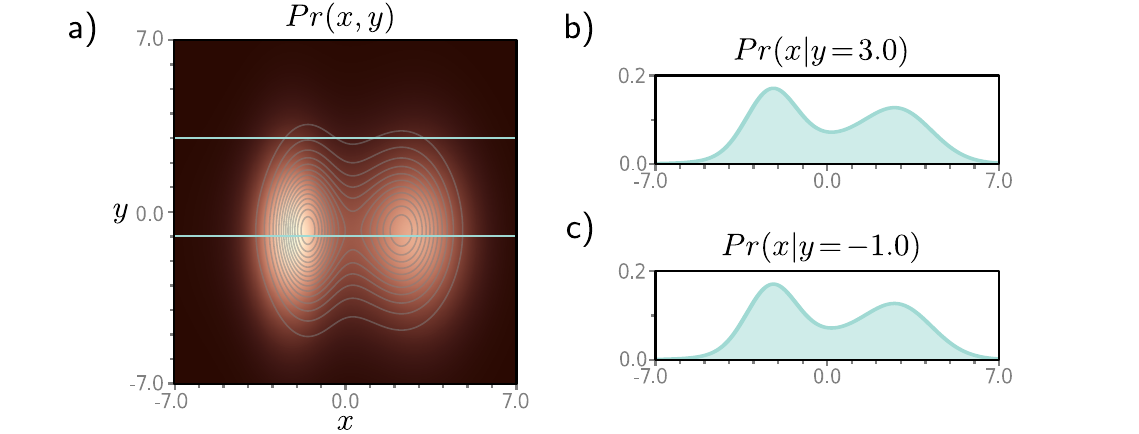
图 C.3 独立性。a) 当两个变量
和 独立时,联合分布分解为边缘分布的乘积,即 。独立性意味着知道一个变量的值不能告诉我们关于另一个变量的任何信息。b-c) 因此,所有条件分布 都相同,且等于边缘分布 。
C.2 期望
考虑函数
顾名思义,这是在考虑看到
期望总是相对于一个或多个变量的分布来取的。然而,当分布的选择显而易见时,我们通常不显式说明,写为
如果我们从
C.2.1 期望的运算规则
操纵期望有四条规则:
其中
规则1: 常数
规则2: 常数
规则3: 和
规则4: 当
其中我们在前两行之间使用了独立性的定义(公式 C.7)。
这四条规则可以推广到多变量情况:
其中
C.2.2 均值、方差和协方差
对于函数
顾名思义,两个变量
如果两个变量独立,则它们的协方差为零。然而,协方差为零并不意味着独立。例如,考虑一个分布
存储在列向量
C.2.3 方差恒等式
期望的运算规则(附录 C.2.1)可以用来证明以下恒等式,它允许我们以不同的形式写出方差:
证明:
其中我们在第一行和第二行之间使用了规则3,在第二行和第三行之间使用了规则1和2,并在第四行和第六行使用了定义
C.2.4 标准化
将随机变量的均值设为零、方差设为1的过程称为标准化(standardization)。这通过以下变换实现:
其中
证明: 新分布关于
新分布的方差为:
通过类似的论证,我们可以将均值为零方差为1的标准化变量
在多变量情况下,我们可以使用以下公式标准化均值为
结果的均值为
C.3 正态概率分布
本书中使用的概率分布包括伯努利分布(图5.6)、分类分布(图5.9)、泊松分布(图5.15)、冯·米塞斯分布(图5.13)和高斯混合模型(图5.14和17.1)。然而,机器学习中最常见的分布是正态分布(normal distribution)或高斯分布(Gaussian distribution)。
C.3.1 单变量正态分布
单变量正态分布(图5.3)定义在标量变量
不出所料,正态分布变量的均值
正态分布的形状可以从以下论证推断。项
C.3.2 多变量正态分布
多变量正态分布将正态分布推广为描述长度为
其解释与单变量情况类似。二次项
协方差矩阵可以取球形、对角和完整形式:
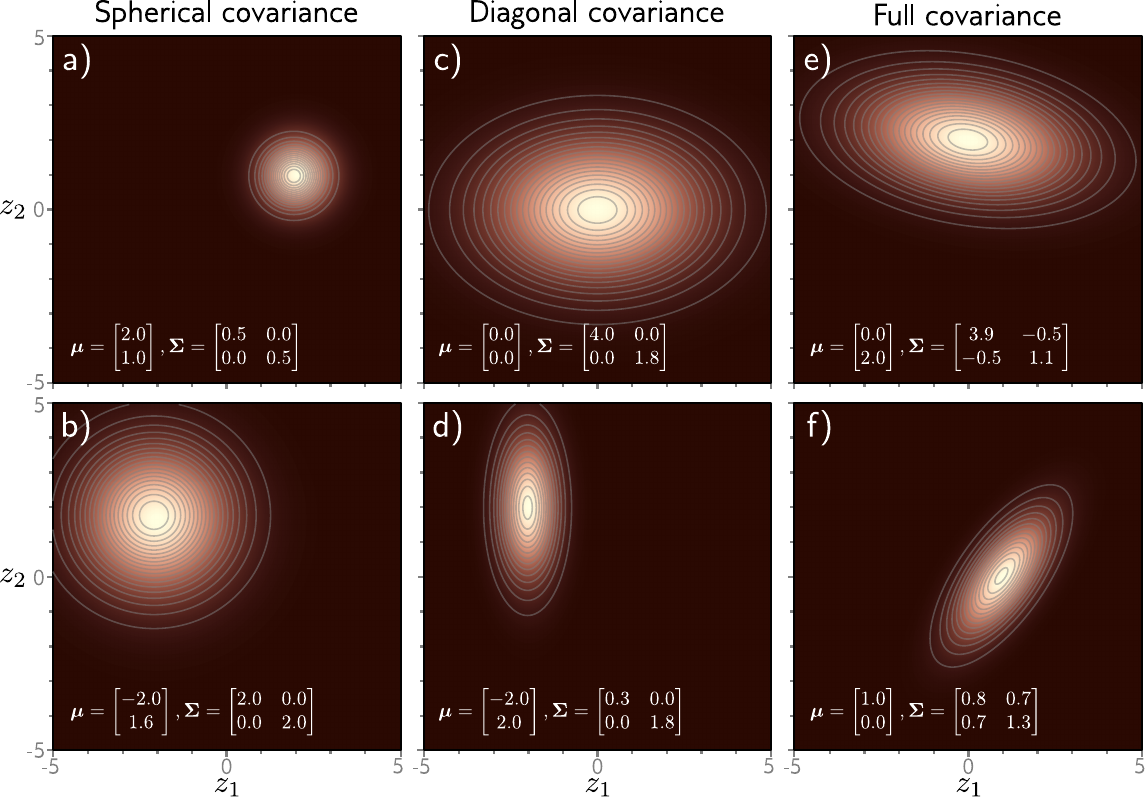
图 C.4 二元正态分布。a-b) 当协方差矩阵是单位矩阵的倍数时,等密度轮廓是圆,我们称之为球形协方差。c-d) 当协方差是任意对角矩阵时,等密度轮廓是与坐标轴对齐的椭圆,我们称之为对角协方差。e-f) 当协方差是任意对称正定矩阵时,等密度轮廓是一般椭圆,我们称之为完整协方差。
在二维情况下(图 C.4),球形协方差产生圆形等密度轮廓,对角协方差产生与坐标轴对齐的椭圆等密度轮廓。完整协方差产生一般的椭圆等密度轮廓。当协方差是球形或对角的时,各个变量是独立的。
C.3.3 两个正态分布的乘积
两个正态分布的乘积正比于第三个正态分布,关系如下:
这可以通过展开指数项并配方来轻松证明(参见问题18.5)。
C.3.4 变量替换
当多变量正态分布
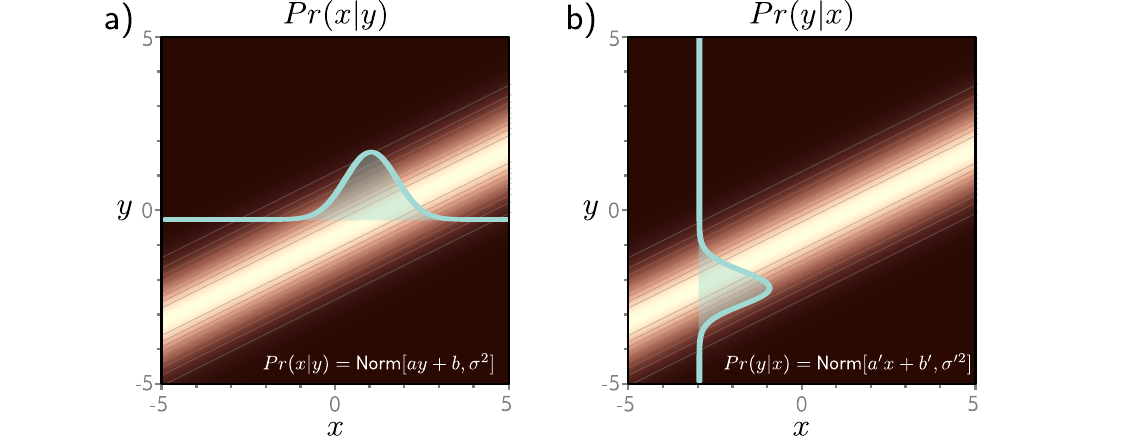
图 C.5 变量替换。a) 条件分布
是一个方差恒定、均值线性依赖于 的正态分布。青色分布展示了 时的一个例子。b) 这正比于条件概率 ,它是一个方差恒定、均值线性依赖于 的正态分布。青色分布展示了 时的一个例子。
乍看之下,这个关系相当晦涩,但图 C.5 展示了标量
C.4 采样
要从单变量分布
C.4.1 从正态分布采样
上述方法可用于从单变量标准正态分布生成样本
C.4.2 祖先采样
当联合分布可以分解为一系列条件概率时,我们可以使用祖先采样(ancestral sampling)来生成样本。基本思想是从根变量生成一个样本,然后基于这个实例从后续的条件分布中采样。这一过程称为祖先采样,通过一个例子最容易理解。考虑三个变量
要从这个联合分布中采样,我们首先从
C.5 概率分布之间的距离
监督学习可以表述为最小化模型所暗示的概率分布与样本所暗示的离散概率分布之间的距离(第5.7节)。无监督学习通常也可以表述为最小化真实样本的概率分布与模型数据分布之间的距离。在两种情况下,我们都需要两个概率分布之间的距离度量。本节考虑几种不同距离度量的性质(另请参见图15.8中关于 Wasserstein 或推土机距离的讨论)。
C.5.1 KL散度
两个概率分布
这个距离始终大于或等于零,这可以通过注意到
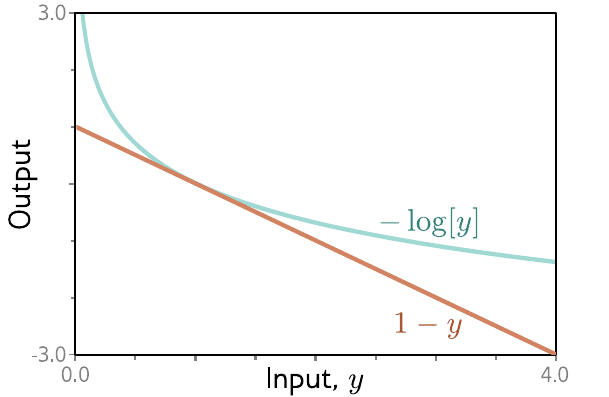
图 C.6 负对数的下界。函数
总是小于函数 。这个关系用于证明 Kullback-Leibler 散度始终大于或等于零。
当存在
C.5.2 Jensen-Shannon 散度
KL 散度不是对称的(即
它是
C.5.3 Fréchet 距离
两个分布
其中
C.5.4 正态分布之间的距离
我们经常需要计算两个均值分别为
KL 散度可以计算为:
其中