
第12章 Transformer
第 10 章介绍了卷积网络,它专门处理位于规则网格上的数据,特别适合处理具有大量输入变量的图像,使得全连接网络无法使用。卷积网络的每一层采用参数共享,使得局部图像块在图像的每个位置都以相似的方式处理。
本章介绍 Transformer。Transformer 最初针对自然语言处理(NLP)问题,其中网络输入是一系列表示单词或词片段的高维嵌入。语言数据集与图像数据集具有一些共同特征:输入变量数量可能非常大,且每个位置的统计特性相似——在文本中的每个可能位置重新学习 dog 一词的含义是不合理的。然而,语言数据集有一个额外的复杂性:文本序列的长度是变化的,且不像图像那样容易调整大小。
12.1 处理文本数据
为了理解 Transformer 的动机,考虑以下段落:
The restaurant refused to serve me a ham sandwich because it only cooks vegetarian food. In the end, they just gave me two slices of bread. Their ambiance was just as good as the food and service.
目标是设计一个网络将这段文本处理成适合下游任务的表示。例如,它可以用于将评论分类为正面或负面,或回答诸如"这家餐厅供应牛排吗?"之类的问题。
我们可以做出三个直接的观察。首先,编码后的输入可能非常大。在本例中,37 个单词中的每一个可能由长度为 1024 的嵌入向量表示,因此即使对于这个小段落,编码输入的长度也为
其次,NLP 问题的一个定义特征是每个输入(一个或多个句子)具有不同的长度;因此,如何应用全连接网络甚至都不明显。这些观察表明,网络应该在不同输入位置的单词之间共享参数,类似于卷积网络在不同图像位置之间共享参数。
第三,语言是有歧义的;仅从语法上无法确定代词 it 指的是餐厅而非火腿三明治。要理解文本,单词 it 应该以某种方式与单词 restaurant 相连接。用 Transformer 的术语来说,前一个词应该对后一个词加以注意力(attention)。这意味着单词之间必须存在连接,且这些连接的强度取决于单词本身。此外,这些连接需要跨越较大的文本范围。例如,最后一句中的单词 their 同样指的是餐厅。
12.2 点积自注意力
上一节论证了处理文本的模型将 (i) 使用参数共享来应对不同长度的长输入段落,以及 (ii) 包含取决于单词本身的单词表示之间的连接。Transformer 通过使用点积自注意力(dot-product self-attention)获得这两个特性。
标准的神经网络层
其中
自注意力块
其中
然后第
标量权重
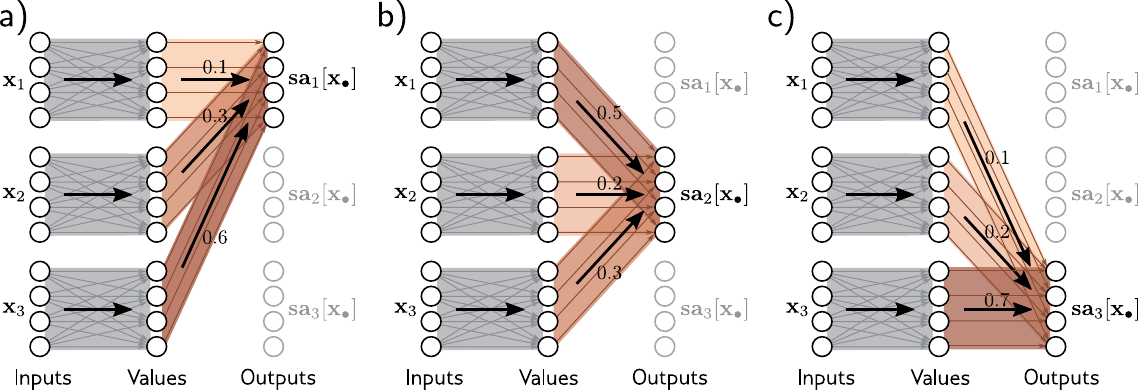
图 12.1 自注意力作为路由。自注意力机制接收
个输入 (此处 , ),分别处理每个输入以计算 个值向量。第 个输出 (简写为 )是 个值向量的加权和,权重为正且和为一。每个输出可以被视为对 个值的不同路由。
以下各节更详细地考察点积自注意力。首先,我们考虑值的计算及其后续加权(公式 12.3)。然后我们描述如何计算注意力权重
12.2.1 值的计算与加权
公式 12.2 表明,相同的权重
注意力权重
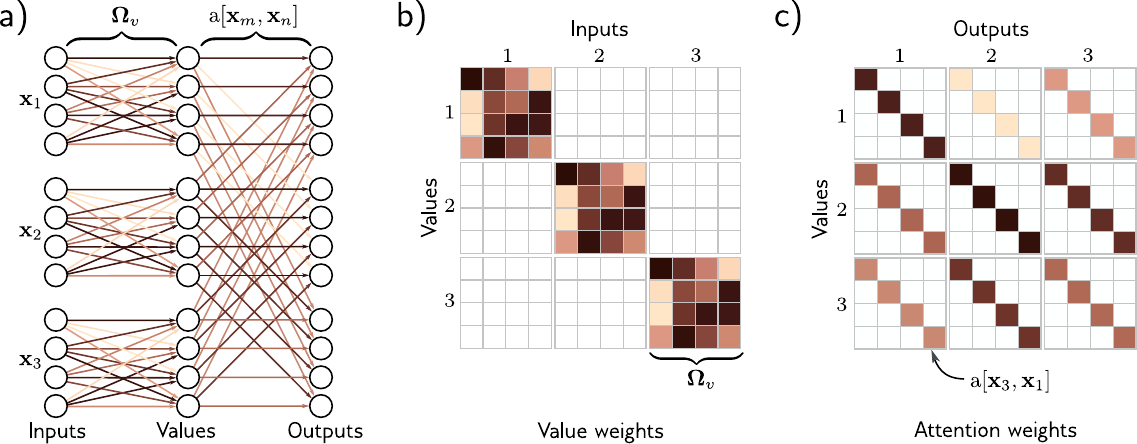
图 12.2
个输入 (每个维度 )的自注意力。a) 每个输入 由相同的权重 (相同颜色表示相同权重)和偏置 (未显示)独立处理,形成值 。每个输出是值的线性组合,注意力权重 定义第 个值对第 个输出的贡献。b) 输入和值之间线性变换 的块稀疏矩阵。c) 关联值和输出的注意力权重稀疏矩阵。
12.2.2 计算注意力权重
在上一节中,我们看到输出由两个链式线性变换产生:值向量
其中
因此对于每个
"查询"和"键"这两个名称来源于信息检索领域,具有以下解释:点积运算返回输入之间的相似度度量,因此权重
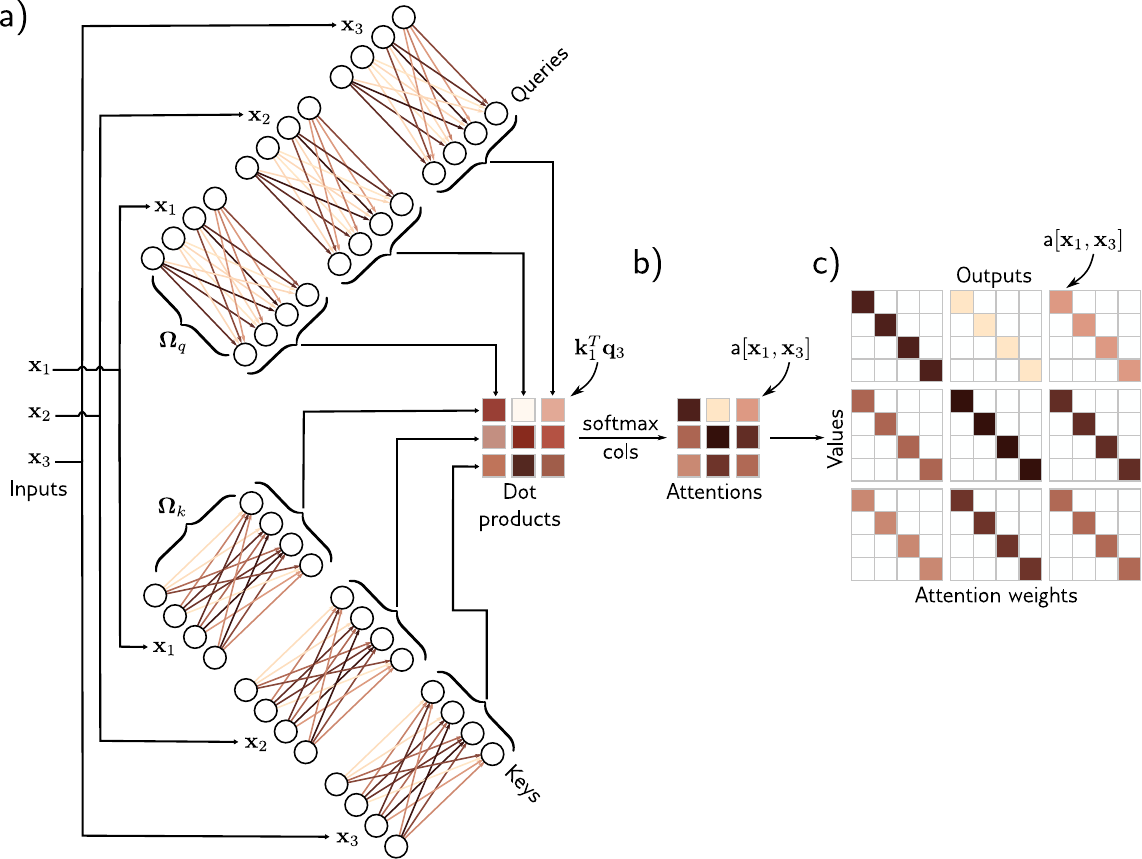
图 12.3 计算注意力权重。a) 查询向量
和键向量 对每个输入 计算。b) 计算每个查询和三个键之间的点积,并通过 softmax 函数形成非负且和为一的注意力。c) 这些注意力通过图 12.2c 的稀疏矩阵路由值向量(图 12.1)。
12.2.3 自注意力总结
第
注意这个机制满足初始需求。首先,存在一组共享的参数
12.2.4 矩阵形式
如果
其中
其中函数
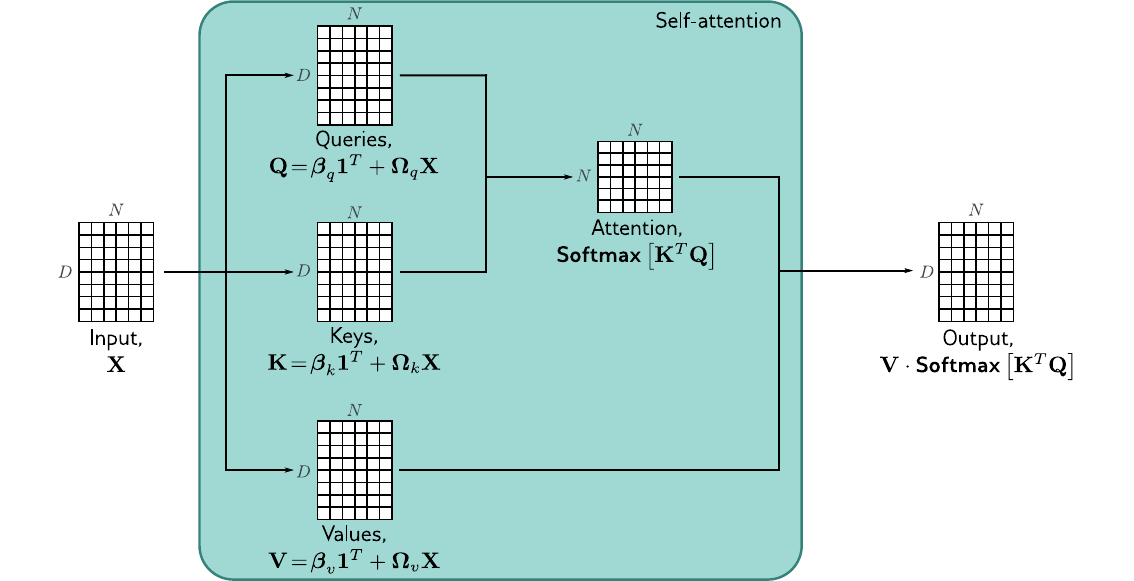
图 12.4 矩阵形式的自注意力。如果将
个输入向量 存储为 矩阵 的列,自注意力可以高效实现。输入 分别由查询矩阵 、键矩阵 和值矩阵 操作。点积通过矩阵乘法计算,softmax 运算独立应用于结果矩阵的每一列以计算注意力。最后,值被注意力后乘以创建与输入相同大小的输出。
12.3 点积自注意力的扩展
上一节描述了自注意力。这里我们介绍三个在实践中几乎总是使用的扩展。
12.3.1 位置编码
细心的读者会注意到,自注意力机制忽略了一个重要信息:计算不考虑输入
绝对位置编码: 将一个矩阵
相对位置编码: 自注意力机制的输入可能是整个句子、多个句子或仅是句子的片段,而且单词的绝对位置远不如两个单词之间的相对位置重要。当然,如果系统知道两者的绝对位置就可以恢复相对位置,但相对位置编码直接编码这个信息。注意力矩阵的每个元素对应于键位置
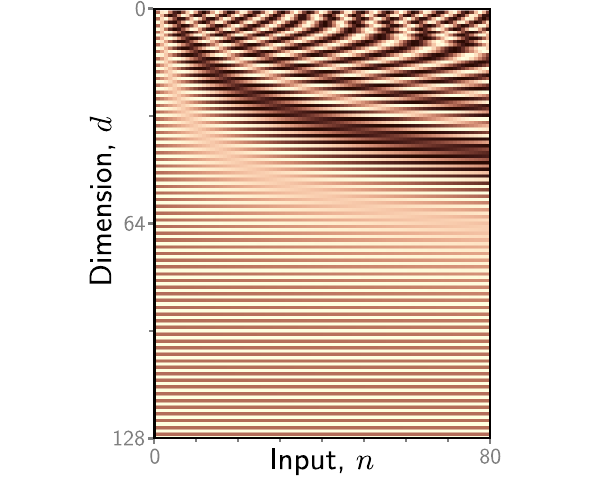
图 12.5 位置编码。自注意力架构对输入的排列是等变的。为确保不同位置的输入被区别对待,可以将位置编码矩阵
加到数据矩阵上。每一列不同,因此可以区分位置。这里位置编码使用了预定义的正弦模式程序化生成(可以根据需要扩展到更大的 值)。在其他情况下,位置编码是学习得到的。
12.3.2 缩放点积自注意力
注意力计算中的点积可能具有较大的幅度,将 softmax 函数的参数推入最大值完全主导的区域。softmax 函数输入的微小变化现在对输出几乎没有影响(即梯度非常小),使得模型难以训练。为防止这种情况,点积按查询和键维度
这被称为缩放点积自注意力(scaled dot-product self-attention)。
12.3.3 多头注意力
多个自注意力机制通常并行应用,这被称为多头自注意力(multi-head self-attention)。现在计算
第
其中每个头有不同的参数
多个头似乎是使自注意力良好工作的必要条件。有人推测它们使自注意力网络对不良初始化更加鲁棒。
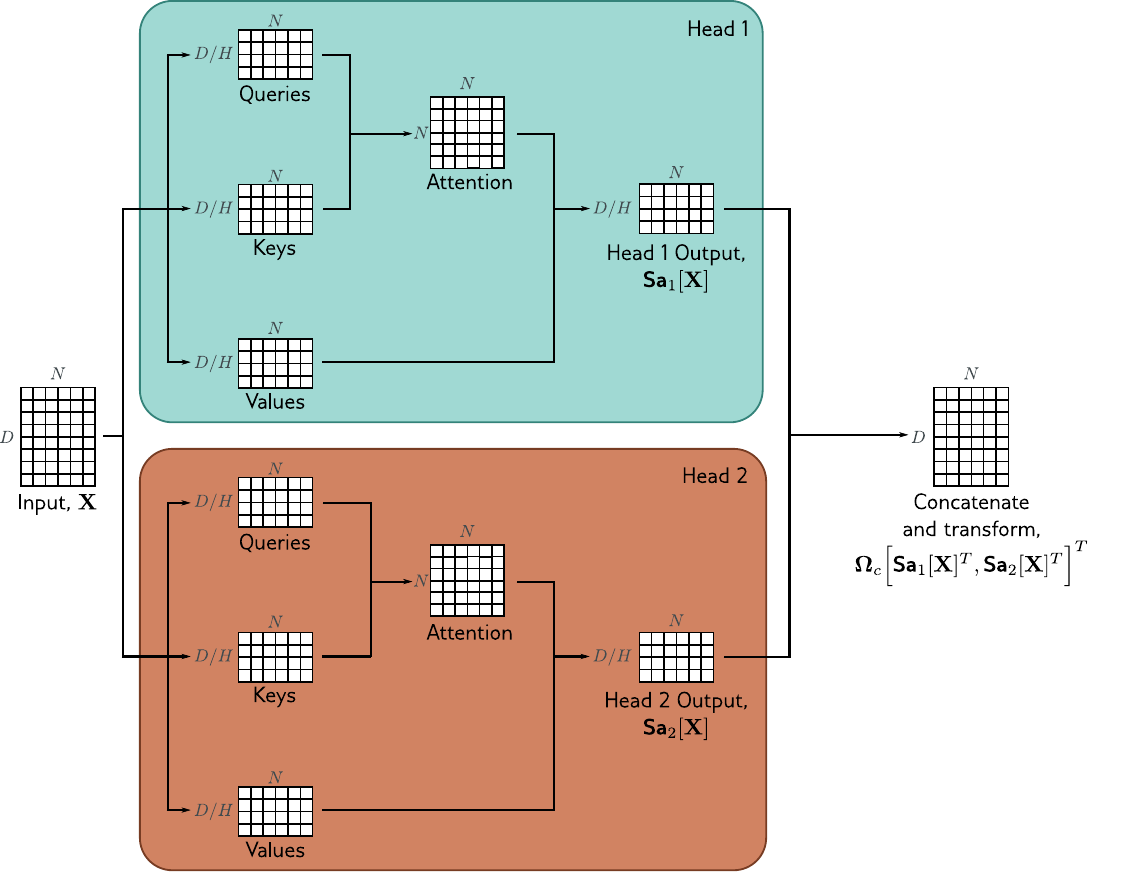
图 12.6 多头自注意力。自注意力在多个并行的"头"中同时进行。每个头有自己的查询、键和值。这里展示了两个头,分别在青色和橙色框中。输出被垂直拼接,并使用另一个线性变换
重新组合。
12.4 Transformer 层
自注意力只是更大的 Transformer 层的一部分。它由一个多头自注意力单元(允许词表示相互交互)和一个全连接网络
其中列向量
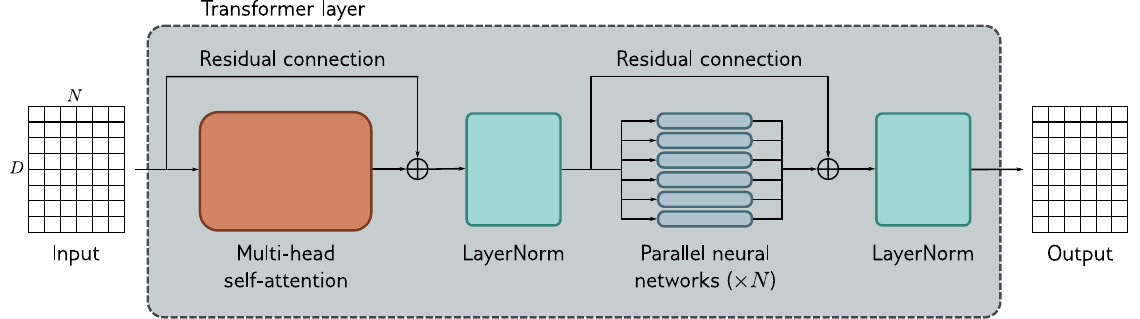
图 12.7 Transformer 层。输入由包含
个输入词元的 维词嵌入的 矩阵组成。输出也是相同大小的矩阵。Transformer 层由一系列操作组成。首先,多头注意力块允许词嵌入相互交互,形成残差块的处理,将输入加回到输出。其次,对每个嵌入分别应用 LayerNorm 操作。第三,第二个残差层使用相同的全连接神经网络分别应用于 个词表示(列)中的每一个。最后,再次应用 LayerNorm。
12.5 用于自然语言处理的 Transformer
上一节描述了 Transformer 层。本节描述如何将其用于自然语言处理(NLP)任务。典型的 NLP 流程从分词器(tokenizer)开始,将文本拆分为单词或词片段。然后将这些词元映射为学习得到的嵌入。这些嵌入通过一系列 Transformer 层处理。我们依次考虑这些阶段。
12.5.1 分词
文本处理流程从分词器开始。它将文本拆分为来自可能词元词汇表(vocabulary)的更小组成单元(词元)。在上面的讨论中,我们暗示这些词元代表单词,但存在几个困难:
- 不可避免地,某些单词(如名字)不会出现在词汇表中。
- 如何处理标点符号不清楚,但这很重要。如果一个句子以问号结尾,我们必须编码这个信息。
- 词汇表需要为同一个词的不同后缀形式(如 walk、walks、walked、walking)准备不同的词元,而且没有办法表明这些变体是相关的。
一种方法是使用字母和标点符号作为词汇表,但这意味着将文本拆分为非常小的部分,需要后续网络重新学习它们之间的关系。
在实践中,使用字母和完整单词之间的折中方案,最终词汇表包含常见单词和词片段,较大和较不常见的词可以由这些片段组合而成。词汇表使用子词分词器(sub-word tokenizer,如字节对编码 / byte pair encoding)计算(图 12.8),它基于频率贪心地合并常见出现的子串。
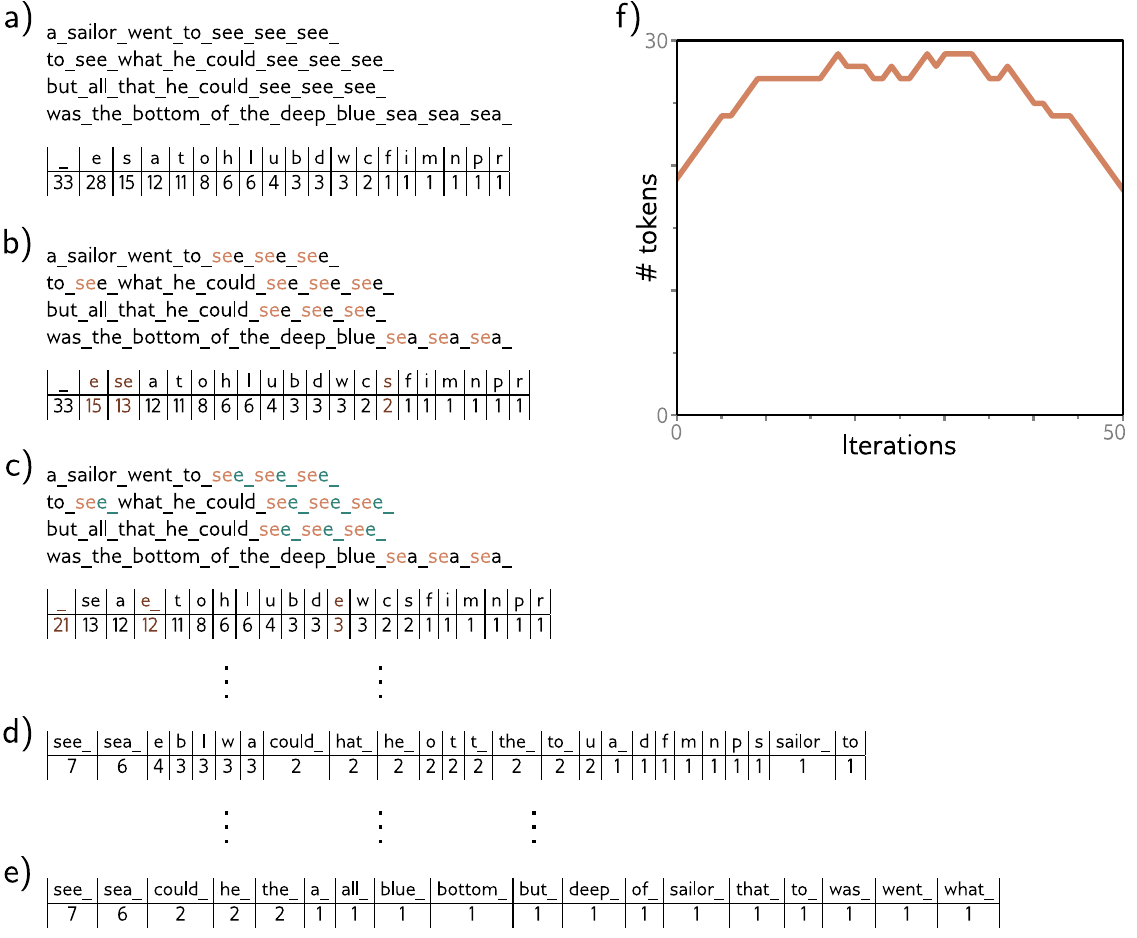
图 12.8 子词分词。a) 一段来自童谣的文本。词元最初只是字符和空白(用下划线表示),以及它们的频率。b) 在每次迭代中,子词分词器查找最常见的相邻词元对(此处为 s 和 e)并合并它们。c) 在第二次迭代中,算法合并 e 和空白字符。d) 23 次迭代后,词元由字母、词片段和常见单词的混合组成。e) 如果继续这个过程,词元最终代表完整的单词。f) 随时间推移,词元数量先增加(添加词片段到字母中)然后再减少(合并这些片段)。
12.5.2 嵌入
词汇表
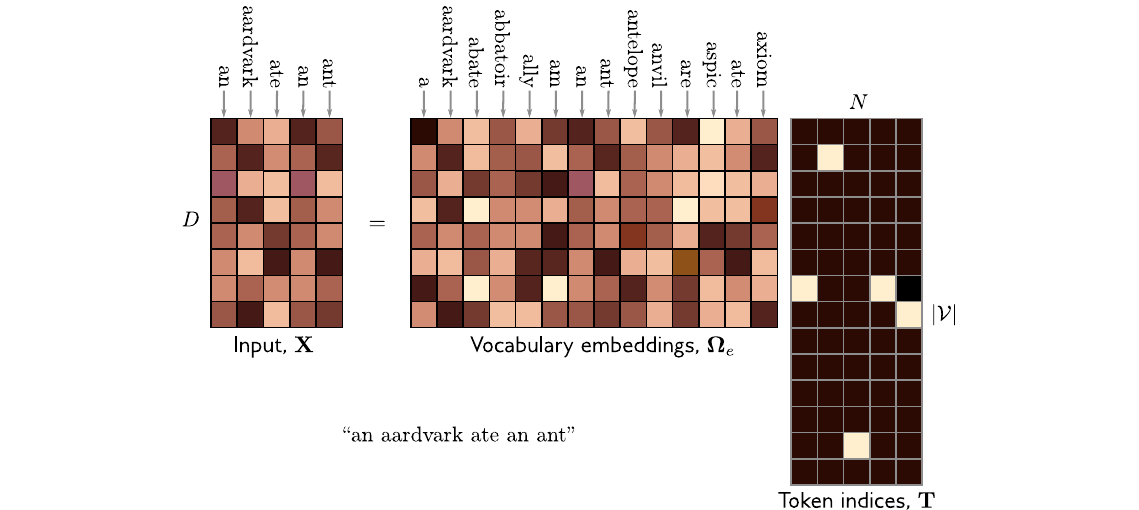
图 12.9 输入嵌入矩阵
包含 个长度为 的嵌入,通过将包含整个词汇表嵌入的矩阵 与包含对应单词或子词索引的独热向量矩阵相乘来创建。词汇表矩阵 被视为模型的参数,与其他参数一起学习。注意 中单词 an 的两个嵌入是相同的。
12.5.3 Transformer 模型
最后,代表文本的嵌入矩阵
12.6 编码器模型示例:BERT
BERT 是一个编码器模型,使用 30,000 个词元的词汇表。输入词元被转换为 1024 维的词嵌入,并通过 24 个 Transformer 层处理。每层包含一个具有 16 个头的自注意力机制。每个头的查询、键和值维度为 64(即矩阵
像 BERT 这样的编码器模型利用了迁移学习(transfer learning,第 9.3.6 节)。在预训练(pre-training)阶段,Transformer 架构的参数通过大规模文本语料库上的自监督(self-supervision)学习。目标是让模型学习关于语言的一般性信息。在微调(fine-tuning)阶段,使用较小的标注训练数据将网络适配到特定任务。
12.6.1 预训练
在预训练阶段,网络使用自监督学习进行训练,无需人工标签即可使用大量数据。对于 BERT,自监督任务是从大型互联网语料库的句子中预测缺失的单词(图 12.10)。训练时,最大输入长度为 512 个词元,批量大小为 256。系统训练 100 万步,大约相当于对 33 亿词语料库的 50 个轮次。
预测缺失的单词迫使 Transformer 网络理解一些语法。例如,它可能学到形容词 red 常出现在名词 house 或 car 之前,但不会出现在动词 shout 之前。它还允许模型学习关于世界的浅层常识。例如,训练后模型会在句子 The <mask> pulled into the station 中给缺失的单词 train 分配比 peanut 更高的概率。然而,这种模型能达到的"理解"程度是有限的。
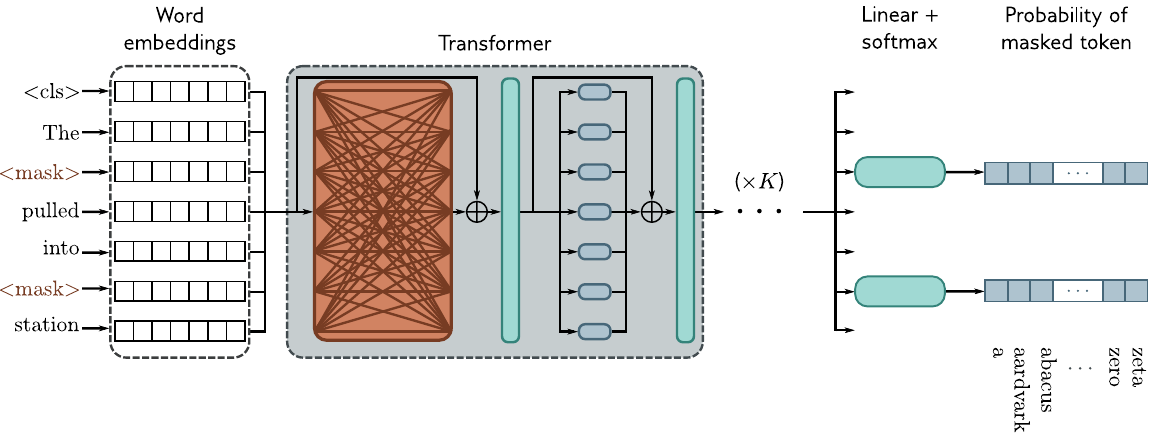
图 12.10 BERT 类编码器的预训练。输入词元(和一个表示序列开始的特殊 <cls> 词元)被转换为词嵌入。这些嵌入通过一系列 Transformer 层处理。少量输入词元被随机替换为通用的 <mask> 词元。在预训练中,目标是从相关的输出嵌入预测缺失的单词。为此,对应被遮蔽词元的输出通过 softmax 函数,并应用多类分类损失。这种任务的优点是利用了左右上下文来预测缺失单词,但缺点是数据使用效率不高。
12.6.2 微调
在微调阶段,模型参数被调整以使网络专门化用于特定任务。在 Transformer 网络上附加额外的层,将输出向量转换为所需的输出格式。示例包括:
文本分类: 在 BERT 中,预训练时在每个字符串开头放置一个称为分类或 <cls> 的特殊词元。对于文本分类任务(如情感分析,判断段落是正面还是负面情感),与 <cls> 词元关联的向量被映射为单个数字并通过 logistic sigmoid 函数(图 12.11a),产生标准的二元交叉熵损失(第 5.4 节)。
词分类: 命名实体识别(named entity recognition)的目标是将每个单词分类为实体类型(如人物、地点、组织或非实体)。为此,每个输入嵌入
文本跨度预测: 在 SQuAD 1.1 问答任务中,问题和包含答案的维基百科段落被拼接和分词。然后使用 BERT 预测包含答案的段落中的文本跨度。每个词元映射为两个数字,表示文本跨度在此位置开始和结束的可能性。
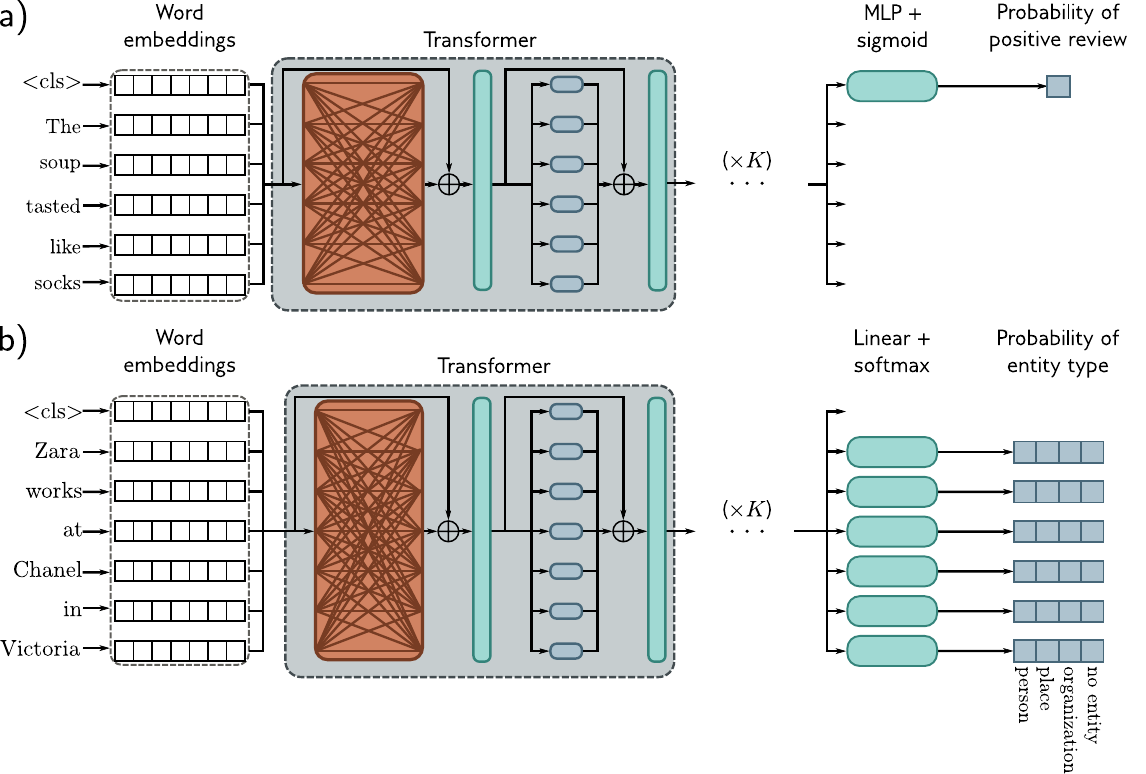
图 12.11 预训练后,使用人工标注数据微调编码器以解决特定任务。a) 文本分类任务示例。在这个情感分类任务中,<cls> 词元嵌入用于预测评论为正面的概率。b) 词分类任务示例。在这个命名实体识别问题中,每个词的嵌入用于预测该词对应的是人物、地点、组织还是非实体。
12.7 解码器模型示例:GPT3
本节介绍 GPT3,一个解码器模型的例子。基本架构与编码器模型极为相似,由操作学习得到的词嵌入的一系列 Transformer 层组成。然而,目标不同。编码器旨在构建文本的表示,以便微调解决更具体的 NLP 任务。相反,解码器只有一个目的:生成序列中的下一个词元。它可以通过将扩展后的序列反馈回模型来生成连贯的文本段落。
12.7.1 语言建模
GPT3 是一个自回归语言模型。考虑句子 It takes great courage to let yourself appear weak。为简单起见,假设词元就是完整的单词。完整句子的概率可以分解为:
自回归模型预测每个词元在给定所有先前词元条件下的条件分布
自回归公式展示了最大化词元联合概率与下一词元预测任务之间的联系。
12.7.2 掩码自注意力
为了训练解码器,我们寻求最大化自回归模型下输入文本的对数概率(即最大化对数条件概率之和)。理想情况下,我们希望传入整个句子,在同一次前向传播中计算所有对数概率和梯度。然而,如果我们传入完整句子,计算
幸运的是,词元只在 Transformer 网络的自注意力层中相互交互。因此,可以通过将自注意力计算(公式 12.5)中相应的点积在通过 softmax 函数之前设为负无穷来确保对答案和右侧上下文的注意力为零。这被称为掩码自注意力(masked self-attention)。其效果是使图 12.1 中所有向上指的箭头的权重为零。
整个解码器网络操作如下:输入文本被分词,词元被转换为嵌入。嵌入被传入使用掩码自注意力的 Transformer 网络。每个输出嵌入可以被理解为代表一个部分句子,对于每一个,目标是预测序列中的下一个词元。因此,在 Transformer 层之后,一个线性层将每个输出嵌入映射到词汇表大小,后接 softmax 函数将这些值转换为概率。训练时,我们使用标准多类交叉熵损失(图 12.12),在每个位置最大化真实序列中下一个词元的对数概率之和。
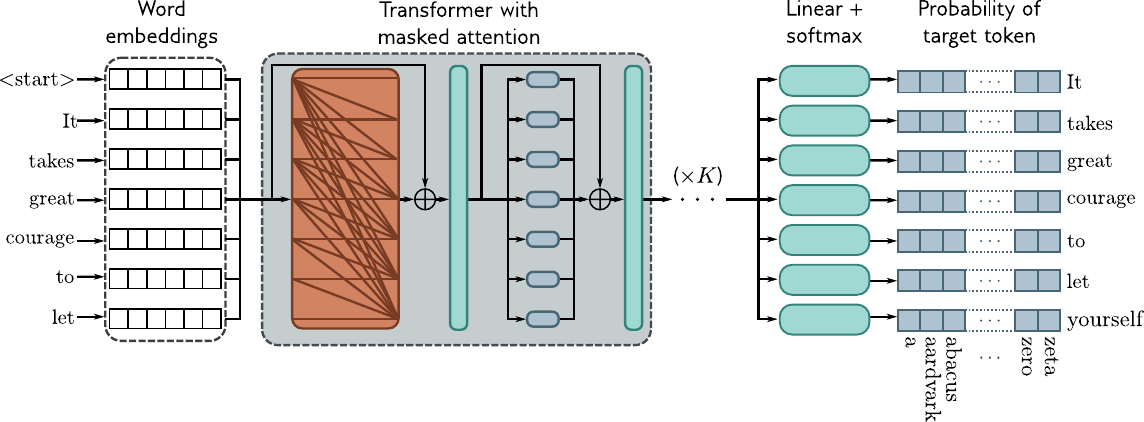
图 12.12 训练 GPT3 类解码器网络。词元被映射为词嵌入,序列开头有一个特殊的 <start> 词元。嵌入通过使用掩码自注意力的一系列 Transformer 层处理。句子中的每个位置只能关注自身嵌入及序列中更早的词元(橙色连接)。每个位置的目标是最大化下一个真实词元的概率。掩码自注意力确保系统无法通过查看后续输入来作弊。
12.7.3 从解码器生成文本
自回归语言模型是本书讨论的第一个生成模型的例子。由于它定义了文本序列上的概率模型,因此可以用来采样新的合理文本。要从模型生成文本,我们从输入文本序列开始(可能只是表示序列开始的特殊 <start> 词元),将其输入网络,网络输出后续可能词元的概率分布。我们可以选择最可能的词元,或从这个概率分布中采样。新的扩展序列可以反馈回解码器网络以产生下一个词元的概率分布。通过重复这个过程,我们可以生成大段文本。由于掩码自注意力,先前的嵌入不依赖于后续的嵌入,因此大部分早期计算可以在生成后续词元时回收利用,计算效率相当高。
在实践中,多种策略可以使输出文本更连贯。例如,束搜索(beam search)跟踪多个可能的句子完成,以找到整体最可能的词序列(这不一定通过在每一步贪心选择最可能的词来找到)。Top-k 采样(top-k sampling)仅从排名前 K 的最可能词元中随机抽取下一个词,以防止系统意外选择低概率词元的长尾而进入不必要的语言死胡同。
12.7.4 GPT3 与少样本学习
大语言模型(large language models)如 GPT3 将这些思想大规模应用。在 GPT3 中,序列长度为 2048 个词元,总批量大小为 320 万词元。有 96 个 Transformer 层(其中一些实现了稀疏版本的注意力),每层处理大小为 12288 的词嵌入。自注意力层有 96 个头,值、查询和键的维度为 128。它使用 3000 亿个词元进行训练,包含 1750 亿个参数。
这种规模的学习模型的一个令人惊讶的特性是,它们无需微调即可执行许多任务。如果我们提供几个正确的问答对作为示例,然后再提出另一个问题,它们通常能通过完成序列来正确回答最后的问题。因此,有人认为巨大的语言模型是少样本学习者(few-shot learners);它们可以仅基于少量示例学习执行新任务。然而,实际中的表现并不稳定,而且其在多大程度上是从学到的示例中外推而非仅仅逐字复制,目前尚不清楚。
12.8 编码器-解码器模型示例:机器翻译
语言之间的翻译是序列到序列(sequence-to-sequence)任务的一个例子。一种常见的方法同时使用编码器(计算源句的良好表示)和解码器(用目标语言生成句子)。这被恰当地称为编码器-解码器模型。
考虑从英语翻译到法语。编码器接收英语句子,通过一系列 Transformer 层处理,为每个词元创建输出表示。训练时,解码器接收法语的真实翻译,通过使用掩码自注意力的一系列 Transformer 层处理,在每个位置预测下一个词。然而,解码器层还关注编码器的输出。因此,每个法语输出词都以先前的输出词和源英语句子为条件(图 12.13)。
这通过修改解码器中的 Transformer 层来实现。原来这些层由掩码自注意力后接应用于每个嵌入的神经网络组成。现在在两个组件之间添加一个新的自注意力层,其中解码器嵌入关注编码器嵌入。这使用一种称为编码器-解码器注意力或交叉注意力(cross-attention)的自注意力变体,其中查询从解码器嵌入计算,键和值从编码器嵌入计算(图 12.14)。
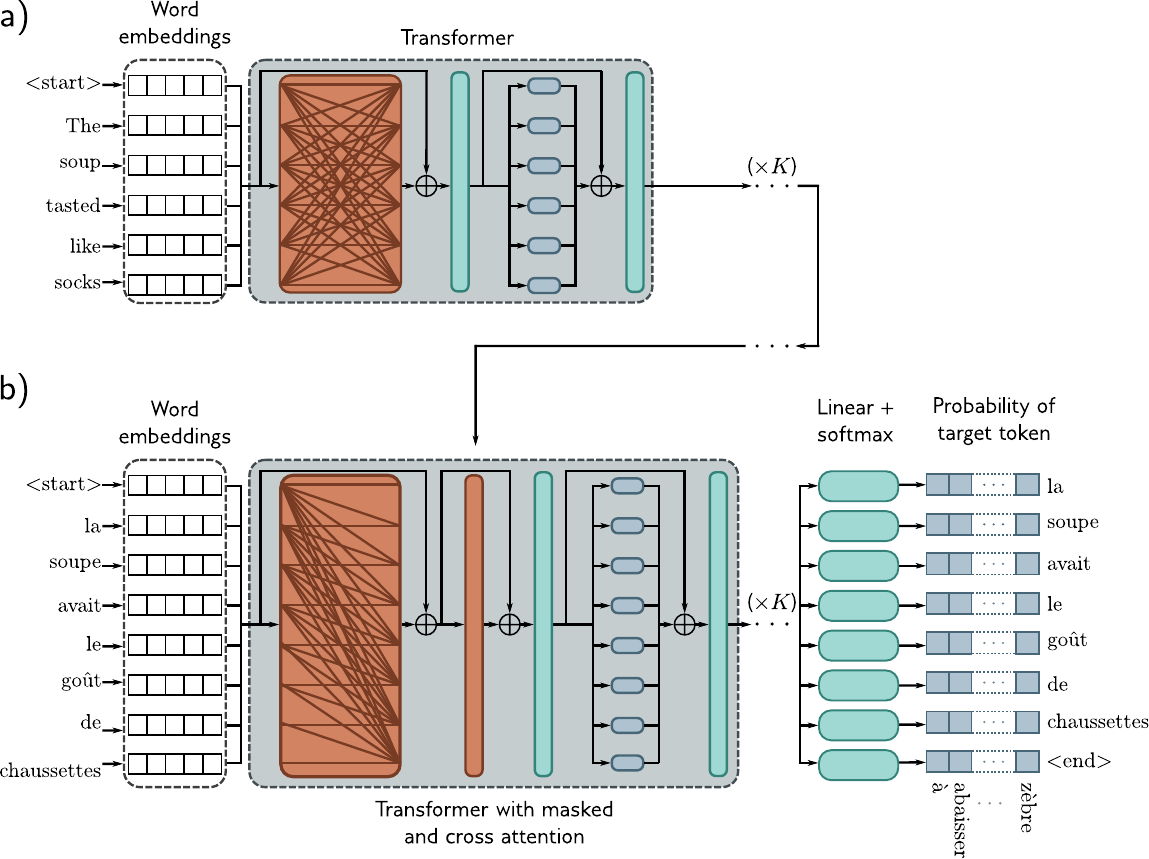
图 12.13 编码器-解码器架构。两个句子被传入系统,目标是将前者翻译为后者。a) 第一个句子通过标准编码器。b) 第二个句子通过使用掩码自注意力但同时通过交叉注意力(橙色矩形)关注编码器输出嵌入的解码器。损失函数与解码器模型相同:我们希望最大化输出序列中下一个词的概率。
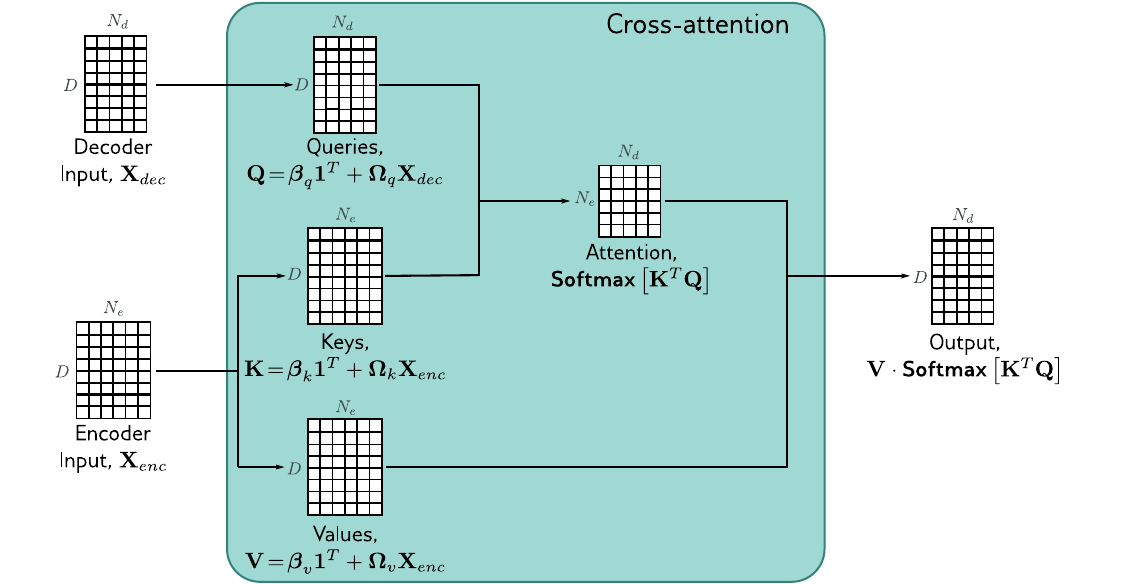
图 12.14 交叉注意力。计算流程与标准自注意力相同,但查询从解码器嵌入
计算,键和值从编码器嵌入 计算。对于翻译任务,编码器包含源语言统计信息,解码器包含目标语言统计信息。
12.9 处理长序列的 Transformer
由于 Transformer 编码器模型中每个词元都与其他每个词元交互,计算复杂度随序列长度呈二次增长。对于解码器模型,每个词元只与前面的词元交互,交互数量大约减半,但复杂度仍然是二次的。这些关系可以用交互矩阵来可视化(图 12.15a-b)。
这种二次增长最终限制了可使用的序列长度。许多方法已被开发来扩展 Transformer 以处理更长的序列。一种方法是剪枝自注意力交互,或等价地,稀疏化交互矩阵(图 12.15c-h)。例如,可以将其限制为卷积结构,使每个词元只与少数相邻词元交互。跨多层后,词元仍然在更大距离上交互,随着感受野的扩大。与图像卷积类似,核可以变化大小和膨胀率。
纯卷积方法需要许多层才能在大距离上整合信息。一种加速方法是允许某些词元(可能在每个句子的开头)关注所有其他词元(编码器模型)或所有先前词元(解码器模型)。类似的思路是引入少量全局词元,它们与所有其他词元及彼此之间相互连接。类似 <cls> 词元,它们不代表任何单词,而是提供远程连接。
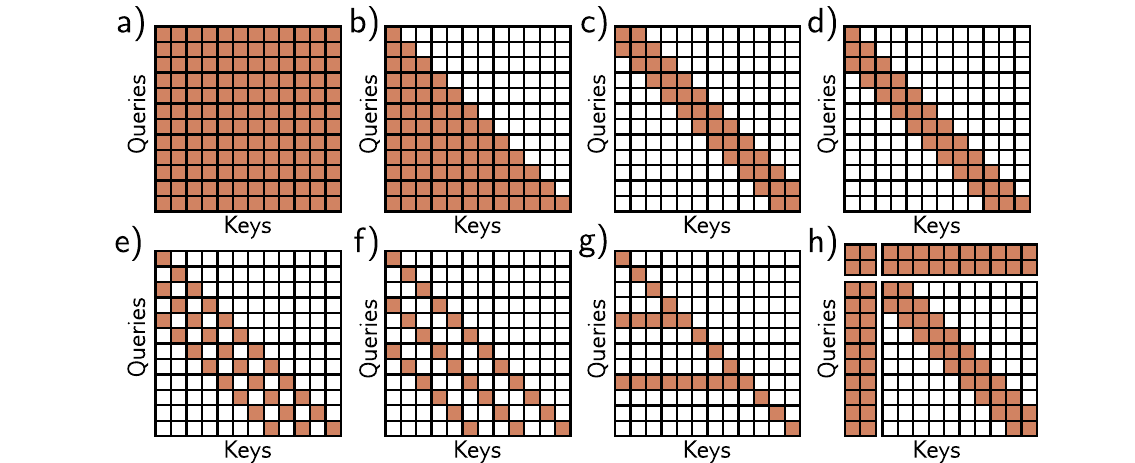
图 12.15 自注意力的交互矩阵。a) 在编码器中,每个词元与其他每个词元交互,计算量随词元数量二次增长。b) 在解码器中,每个词元只与前面的词元交互,但复杂度仍为二次。c) 可以通过使用卷积结构来降低复杂度(编码器情况)。d) 解码器的卷积结构。e-f) 膨胀率为二和三的卷积结构(解码器情况)。g) 另一种策略是允许选定的词元与所有其他词元(编码器情况)或所有先前词元(解码器情况,如图所示)交互。h) 或者,可以引入全局词元(左两列和上两行),它们与所有词元及彼此交互。
12.10 用于图像的 Transformer
Transformer 最初为文本数据开发。它们在这一领域的巨大成功促使了在图像上的实验。这并非显而易见的好主意,原因有二。首先,图像中的像素数量远多于句子中的单词数量,因此自注意力的二次复杂度构成了实际瓶颈。其次,卷积网络具有良好的归纳偏置,因为每一层对空间平移是等变的,并考虑了图像的 2D 结构。然而,在 Transformer 网络中这些都必须学习。
尽管存在这些表面上的劣势,用于图像的 Transformer 网络现在已经在图像分类和其他任务上超越了卷积网络的性能。这部分归因于它们可以构建的巨大规模以及可用于预训练网络的大量数据。本节介绍用于图像的 Transformer 模型。
12.10.1 ImageGPT
ImageGPT 是一个 Transformer 解码器;它构建图像像素的自回归模型,接收部分图像并预测后续像素值。Transformer 网络的二次复杂度意味着最大的模型(包含 68 亿参数)仍然只能处理
图像天然是 2D 对象,但 ImageGPT 只是为每个像素学习不同的位置编码。因此它必须学习每个像素与其前面的邻居以及上一行附近像素之间有密切关系。图 12.16 展示了生成结果的示例。
该解码器的内部表示也被用作图像分类的基础。每个像素的最终嵌入被平均,一个线性层将这些值映射到激活值,通过 softmax 层预测类别概率。系统在大型网络图像语料库上预训练,然后在 ImageNet 数据库上微调。尽管使用了大量外部训练数据,系统在 ImageNet 上仅达到 27.4% 的 top-1 错误率(图 10.15)。这不如当时的卷积架构(见图 10.21),但鉴于较小的输入图像大小仍然令人印象深刻;当目标物体很小或很细时,系统不出意外地会失败。
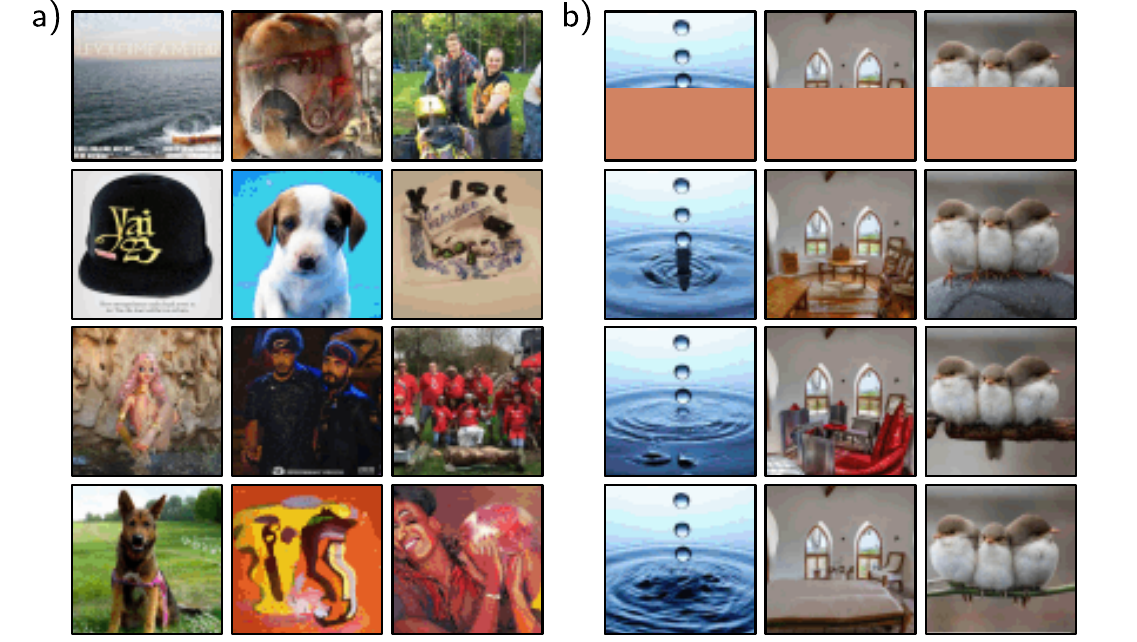
图 12.16 ImageGPT。a) 从自回归 ImageGPT 模型生成的图像。b) 图像补全。每种情况下,去掉图像的下半部分(顶行),ImageGPT 逐像素补全剩余部分(展示三种不同的补全结果)。
12.10.2 Vision Transformer (ViT)
Vision Transformer 通过将图像分成
这是一个带有 <cls> 词元的编码器模型(见图 12.10-12.11)。然而,与 BERT 不同的是,它使用有监督预训练,在来自 18,000 个类别的 3.03 亿张标注图像的大型数据库上训练。<cls> 词元通过最终网络层映射为激活值,通过 softmax 函数生成类别概率。预训练后,系统通过替换最终层以映射到所需的类别数量并进行微调,应用于最终分类任务。
在 ImageNet 基准测试上,该系统达到 11.45% 的 top-1 错误率。然而,如果没有有监督预训练,它的性能不如最好的卷积网络。卷积网络的强归纳偏置只有通过使用极大量的训练数据才能被超越。
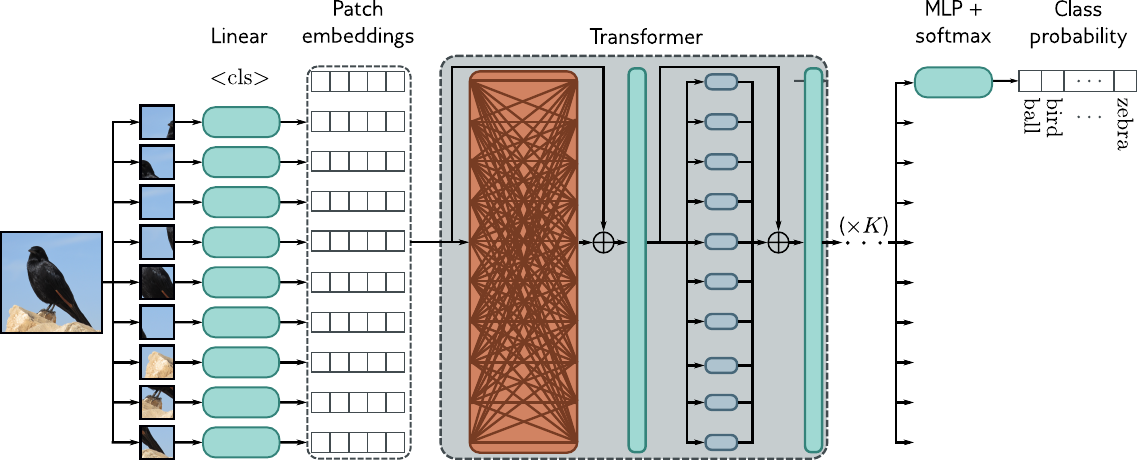
图 12.17 Vision Transformer。Vision Transformer (ViT) 将图像分成图块网格(原始实现中为
)。每个图块通过学习的线性变换投影为图块嵌入。这些图块嵌入被输入 Transformer 编码器网络,<cls> 词元用于预测类别概率。
12.10.3 多尺度视觉 Transformer
Vision Transformer 与卷积架构的不同之处在于它在单一尺度上操作,感受野覆盖整个图像。已经提出了多种在多个尺度上处理图像的 Transformer 模型。类似于卷积网络,这些通常从小的高分辨率图块和少量通道开始,逐渐扩大感受野、降低空间分辨率并增加通道数(嵌入维度)。
多尺度 Transformer 的一个代表性例子是移动窗口(shifted-window)或 SWin Transformer。这是一个编码器 Transformer,将图像分成图块,并将这些图块分组为窗口网格,在每个窗口内独立应用自注意力(图 12.18)。即图块只关注同一窗口内的其他图块。每隔一层,窗口发生移动,使相互交互的图块子集发生变化,信息可以在整个图像上传播。每隔几层,
在撰写本文时,该架构最复杂的版本在 ImageNet 数据库上达到 9.89% 的 top-1 错误率。一个相关思路是周期性整合来自整个图像的信息。双注意力视觉 Transformer(DaViT)交替使用两种类型的 Transformer。第一种中,图像图块相互关注,自注意力计算使用所有通道。第二种中,通道相互关注,自注意力计算使用所有图像图块。该架构在 ImageNet 上达到 9.60% 的 top-1 错误率,在撰写本文时接近最先进水平。
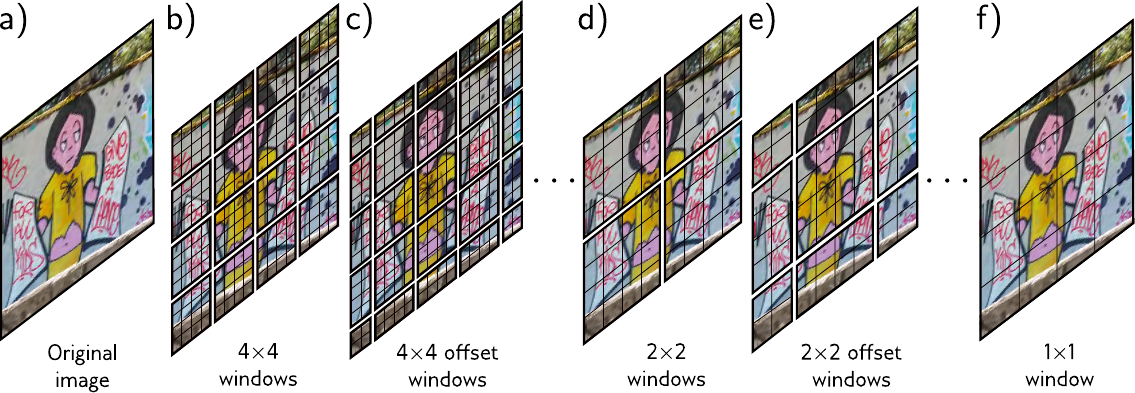
图 12.18 移动窗口(SWin)Transformer。a) 原始图像。b) SWin Transformer 将图像分成图块的窗口网格,在每个窗口内独立应用自注意力。c) 每隔一层移动窗口,使相互交互的图块子集变化,信息在整个图像上传播。d) 几层后,
的图块表示块被拼接以增大有效图块和窗口大小。e) 在新的较低分辨率上交替使用移动窗口层。f) 最终分辨率使得只有一个窗口,图块覆盖整个图像。
12.11 总结
本章介绍了自注意力和 Transformer 架构。编码器、解码器和编码器-解码器模型被依次描述。Transformer 操作于高维嵌入的集合上。它每层计算复杂度低,且大部分计算可以使用矩阵形式并行执行。由于每个输入嵌入都与其他每个嵌入交互,它可以描述文本中的长程依赖关系。但最终,计算量随序列长度呈二次增长;降低复杂度的一种方法是稀疏化交互矩阵。
使用非常大的无标注数据集训练 Transformer 是本书中无监督学习(在没有标签的情况下学习)的第一个例子。编码器通过预测缺失词元来学习表示。解码器构建输入上的自回归模型,是本书中生成模型的第一个例子。生成式解码器可以用来创建新的数据样本。
第 13 章考虑处理图数据的网络。这些网络与 Transformer 有相似之处,因为图的节点在每个网络层中相互关注。第 14-18 章回到无监督学习和生成模型。