
第11章 残差网络
上一章介绍了随着卷积网络深度从八层(AlexNet)扩展到十九层(VGG),图像分类性能如何得到提升。这促使人们尝试构建更深的网络。然而,当添加更多层时,性能反而下降了。
本章引入残差块(residual blocks)。在残差块中,每个网络层计算对当前表示的加性修改,而非直接对其进行变换。这使得更深的网络得以训练,但会导致初始化时激活值幅度呈指数增长。残差块采用批量归一化(batch normalization)来补偿这一问题,它在每一层重新中心化并重新缩放激活值。
结合批量归一化的残差块允许训练更深的网络,并在各种任务上提升性能。本章还将介绍几种结合残差块的架构,用于图像分类、医学图像分割和人体姿态估计。
11.1 顺序处理
到目前为止,我们见过的所有网络都是顺序处理数据的;每一层接收前一层的输出并将结果传递给下一层(图 11.1)。例如,一个三层网络定义为:
其中
在标准神经网络中,每一层由一个线性变换后接一个激活函数组成,参数
由于处理是顺序的,我们可以等价地将网络视为一系列嵌套函数:

图 11.1 顺序处理。标准神经网络将每一层的输出直接传递给下一层。
11.1.1 顺序处理的局限性
原则上,我们可以添加任意多的层,而且在上一章中我们看到,向卷积网络添加更多层确实能提升性能:拥有十九层的 VGG 网络(图 10.17)优于拥有八层的 AlexNet(图 10.16)。然而,随着层数进一步增加,图像分类性能再次下降(图 11.2)。这令人惊讶,因为通常模型容量增加时性能应该更好。实际上,这种下降在训练集和测试集上都存在,这意味着问题在于训练更深网络的困难,而非更深网络缺乏泛化能力。
这一现象尚未被完全理解。一种猜想是,在初始化后,当我们修改网络早期层的参数时,损失梯度会发生不可预测的变化。通过适当的权重初始化(见第 7.5 节),损失相对于这些参数的梯度是合理的(即不会出现梯度爆炸或梯度消失)。然而,导数假设参数的变化是无穷小的,而优化算法使用的是有限步长。任何合理的步长选择都可能使参数移动到一个梯度完全不同且无关的位置;损失曲面看起来像是由无数小山丘组成的巨大山脉,而非一个容易下降的光滑结构。因此,当损失函数梯度变化更快时,算法无法有效地取得进展。
这一猜想得到了对单输入单输出网络中梯度的经验观察的支持。对于浅层网络,当我们改变输入时,输出相对于输入的梯度变化缓慢(图 11.3a)。然而,对于深层网络,输入的微小变化会导致完全不同的梯度(图 11.3b)。这通过梯度的自相关函数来体现(图 11.3c)。浅层网络的相邻梯度是相关的,但对于深层网络,这种相关性迅速降至零。这被称为梯度破碎(shattered gradients)现象。
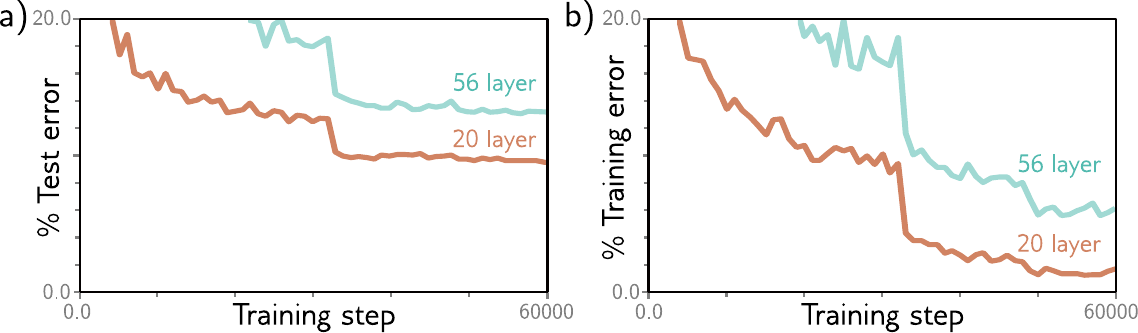
图 11.2 添加更多卷积层时性能下降。a) 20层卷积网络在 CIFAR-10 数据集的测试集上,图像分类性能优于 56 层神经网络。b) 在训练集上同样如此,这表明问题在于训练原始网络,而非泛化到新数据的失败。改编自 He et al. (2016a)。
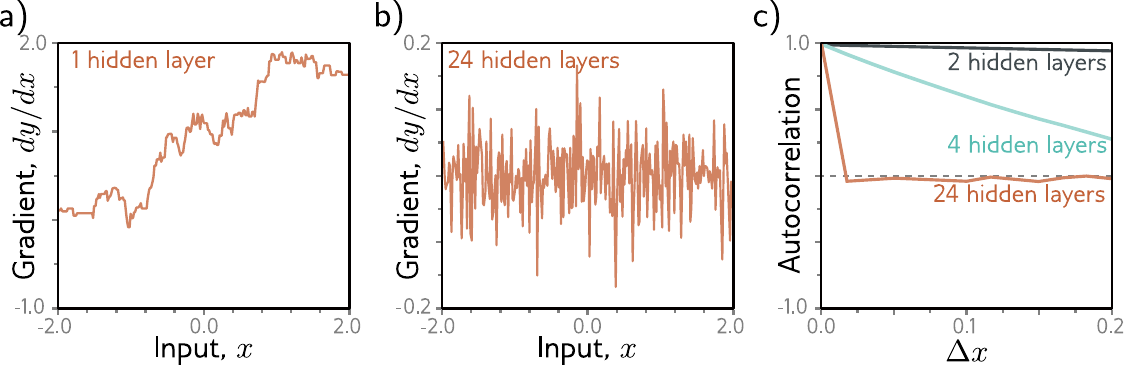
图 11.3 梯度破碎。a) 考虑一个浅层网络,具有 200 个隐藏单元,使用 Glorot 初始化(不带因子 2 的 He 初始化)初始化权重和偏置。标量网络输出
相对于标量输入 的梯度 随输入 的变化相对缓慢。b) 对于具有 24 层、每层 200 个隐藏单元的深层网络,梯度变化非常快且不可预测。c) 梯度的自相关函数表明,对于深层网络,相邻梯度变得不相关(自相关接近于零)。这种梯度破碎现象可能解释了为什么深层网络难以训练。梯度下降算法依赖于损失曲面相对光滑,因此每次更新步骤前后的梯度应该是相关的。改编自 Balduzzi et al. (2017)。
梯度破碎大概是因为早期网络层的变化会以越来越复杂的方式修改输出,随着网络变得越来越深,这种影响加剧。输出
当我们改变决定
11.2 残差连接与残差块
残差连接(residual connections)或跳跃连接(skip connections)是计算路径中的分支,将每个网络层
其中每行右侧的第一项就是残差连接。每个函数
同样,我们可以通过代入中间量
其中为简洁起见省略了参数
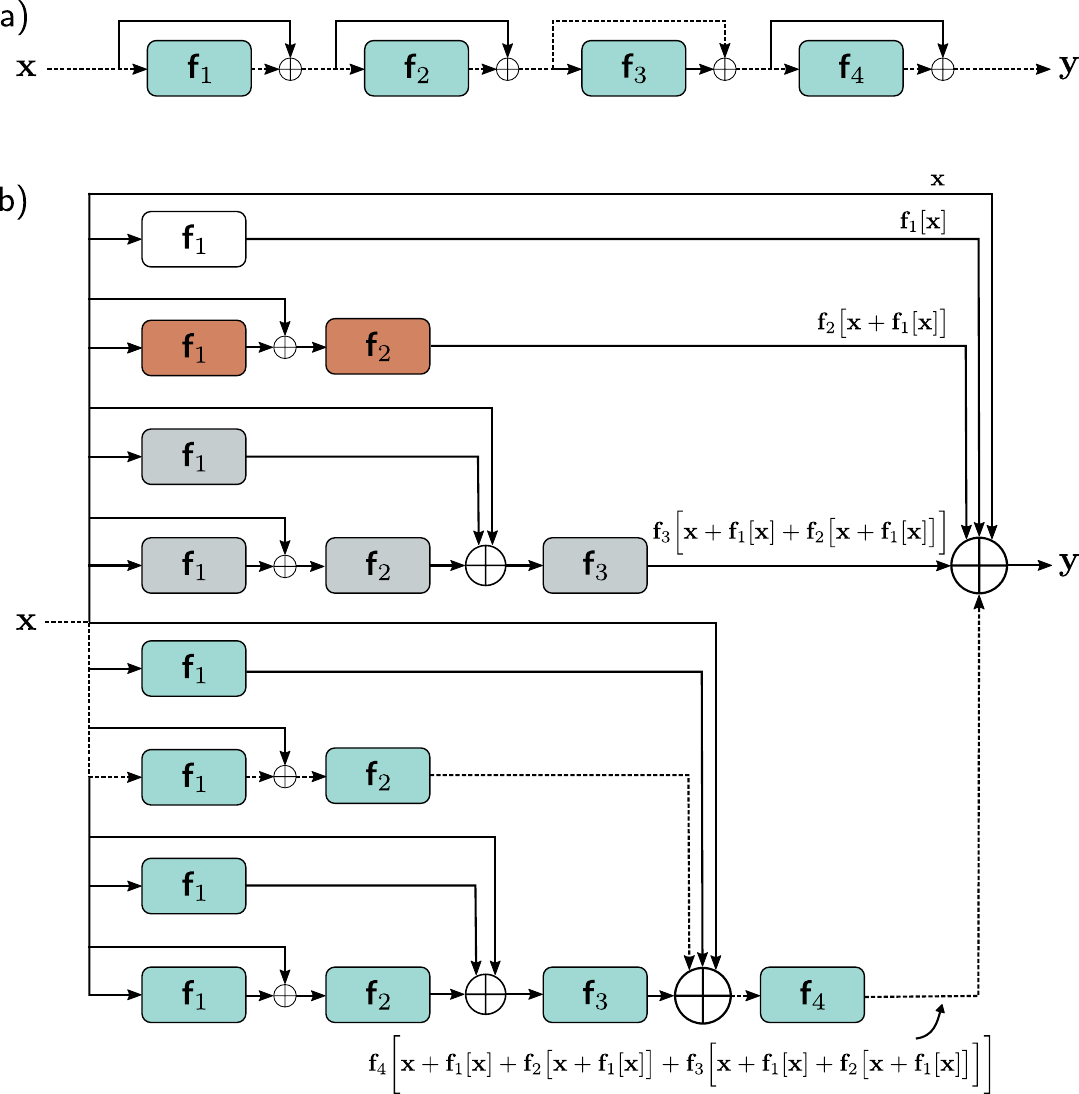
图 11.4 残差连接。a) 每个函数
的输出加回到其输入上,通过一条称为残差连接或跳跃连接的并行计算路径传递。因此,函数计算的是对表示的加性修改。b) 展开网络方程后,我们发现输出是输入加上四个较小网络的总和(分别用白色、橙色、灰色和青色表示,对应公式 11.5 中的各项);我们可以将其视为网络的集成。此外,青色网络的输出本身是另一个集成的变换 ,依此类推。或者,我们可以将网络视为通过计算图的 16 条不同路径的组合。其中一个例子是图 (a) 和 (b) 中的虚线路径。
这种解释是,残差连接将原始网络转化为这些较小网络的集成,这些网络的输出被求和以计算最终结果。
一种互补的思考方式是,这个残差网络在输入和输出之间创建了十六条具有不同变换数量的路径。例如,第一个函数
其中八条路径各对应一项。右侧的恒等项表明,第一层
11.2.1 残差块中的运算顺序
到目前为止,我们一直暗示加性函数
因此,通常改变运算顺序,使激活函数先应用,然后是线性变换(图 11.5b)。有时残差块内部可能有多层处理(图 11.5c),但这些通常以线性变换结束。最后值得注意的是,当我们以 ReLU 运算开始这些块时,如果初始网络输入为负,它们将不起作用,因为 ReLU 会将整个信号裁剪为零。因此,通常以线性变换而非残差块开始网络,如图 11.5b 所示。
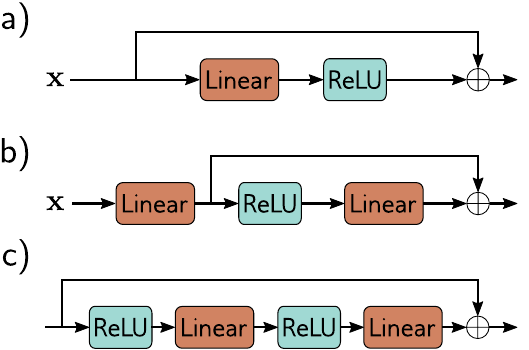
图 11.5 残差块中的运算顺序。a) 线性变换或卷积后接 ReLU 非线性的常见顺序意味着每个残差块只能添加非负量。b) 反转顺序后,正值和负值都可以被添加。然而,我们必须在网络开头添加一个线性变换,以防输入全为负。c) 实际中,残差块通常包含多个网络层。
11.2.2 具有残差连接的更深网络
添加残差连接大约可以将能被有效训练的网络深度加倍。然而,我们希望进一步增加深度。要理解为什么残差连接不能让我们任意增加深度,我们必须考虑前向传播过程中激活值的方差如何变化,以及反向传播过程中梯度幅度如何变化。
11.3 残差网络中的梯度爆炸
在第 7.5 节中,我们看到初始化网络参数至关重要。如果不仔细初始化,前向传播过程中中间值的幅度可能增大或减小到指数级别。类似地,反向传播过程中的梯度也可能爆炸或消失。
因此,我们初始化网络参数,使得激活值的期望方差(在前向传播中)和梯度的期望方差(在反向传播中)在各层之间保持不变。He 初始化(第 7.5 节)通过将偏置
现在考虑残差网络。我们不必担心中间值或梯度随网络深度消失,因为每一层都有直接贡献到网络输出的路径(公式 11.5 和图 11.4b)。然而,即使在残差块内使用 He 初始化,前向传播中的值仍然会随着网络层数指数增长。
要理解原因,考虑到我们将残差块的处理结果加回到输入上。每个分支都有一些(不相关的)变异性。因此,当我们重组它们时,总体方差增加。使用 ReLU 激活和 He 初始化,每个块中处理的期望方差不变。因此,当我们与输入重组时,方差加倍(图 11.6a),随残差块数量指数增长。这限制了在前向传播超出浮点精度之前可能的网络深度。类似的论证也适用于反向传播算法中的梯度。
因此,即使使用 He 初始化,残差网络仍然受到不稳定的前向传播和梯度爆炸的困扰。一种稳定前向和反向传播的方法是使用 He 初始化,然后将每个残差块的组合输出乘以
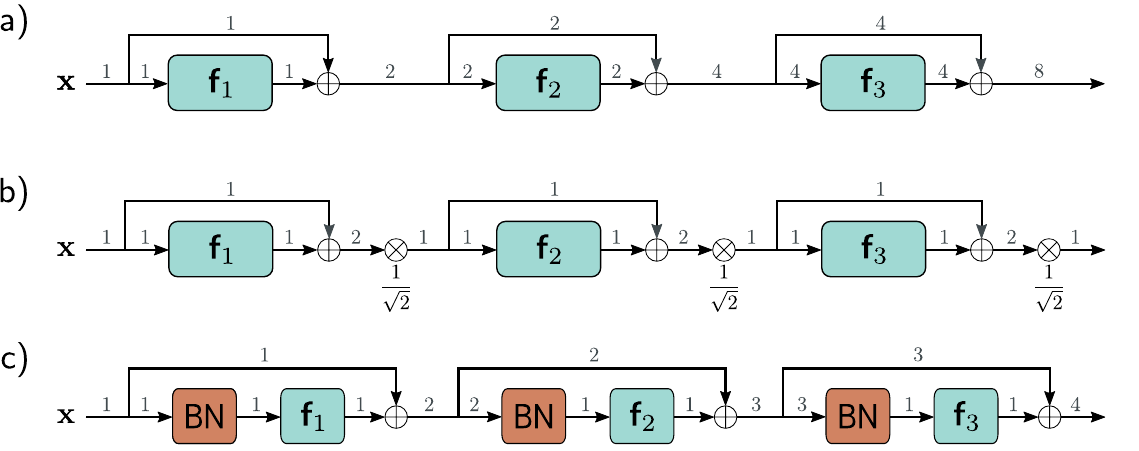
图 11.6 残差网络中的方差。a) He 初始化确保线性加 ReLU 层
之后期望方差不变。不幸的是,在残差网络中,每个块的输入被加回到输出,因此方差在每一层加倍(灰色数字表示方差),并呈指数增长。b) 一种方法是在每个残差块之间将信号乘以 。c) 第二种方法是将批量归一化(BN)作为残差块的第一步,并将相关偏移 初始化为零、缩放 初始化为一。这将每层的输入变换为单位方差,配合 He 初始化,输出方差也为一。现在方差随残差块数量线性增长。一个副作用是,在初始化时,后面的网络层主要由残差连接支配,因此接近于计算恒等映射。
11.4 批量归一化
批量归一化(batch normalization)或 BatchNorm 对每个激活值
其中所有量都是标量。然后我们使用这些统计量将批次激活值标准化为零均值和单位方差:
其中
最后,归一化后的变量乘以缩放因子
经过此操作后,激活值在所有批次成员上具有均值
批量归一化独立地应用于每个隐藏单元。在具有
11.4.1 批量归一化的代价和收益
批量归一化使网络对每个激活值所涉及的权重和偏置的缩放具有不变性;如果这些被加倍,激活值也加倍,估计的标准差
稳定的前向传播: 如果我们将偏移
在初始化时,这有一个副作用:后面的层对整体变化的贡献较小。网络在训练开始时实际上较浅,因为后面的层接近于计算恒等映射。随着训练进行,网络可以增大后面层的缩放
更高的学习率: 经验研究和理论都表明,批量归一化使损失曲面及其梯度变化更加平滑(即减少了梯度破碎)。这意味着我们可以使用更高的学习率,因为曲面更加可预测。我们在第 9.2 节中看到,更高的学习率可以提升测试性能。
正则化: 我们在第 9 章中看到,训练过程中的噪声可以改善泛化。BatchNorm 注入了噪声,因为归一化取决于批次统计量。每个训练样本的激活值被一个取决于批次中其他成员的量进行归一化,且在每次训练迭代中都不同。
11.5 常见残差架构
残差连接现在是深度学习流程的标准组成部分。本节回顾几种包含残差连接的知名架构。
11.5.1 ResNet
残差块最早在图像分类的卷积网络中使用。由此产生的网络被称为残差网络,简称 ResNet。在 ResNet 中,每个残差块包含一个批量归一化操作、一个 ReLU 激活函数和一个卷积层。然后重复相同的序列,再将结果加回到输入上(图 11.7a)。试验证明这种运算顺序在图像分类中效果良好。
对于非常深的网络,参数量可能变得过大。瓶颈残差块(bottleneck residual blocks)通过使用三个卷积更高效地利用参数。第一个使用
ResNet-200 模型(图 11.8)包含 200 层,用于 ImageNet 数据库(图 10.15)的图像分类。该架构类似于 AlexNet 和 VGG,但使用瓶颈残差块代替普通卷积层。与 AlexNet 和 VGG 类似,这些块周期性地穿插空间分辨率的降低和通道数的同步增加。分辨率通过步幅为二的卷积降低。通道数通过在表示后面追加零或应用额外的
ResNet-200 模型在正确类别排名前一和前五的错误率分别达到了 4.8% 和 20.1%。与 AlexNet(16.4%、38.1%)和 VGG(6.8%、23.7%)相比表现优异,是首批超越人类表现(前五猜测中正确率为 5.1%)的网络之一。然而,该模型于 2016 年提出,目前已远非最先进水平。在撰写本文时,该任务上表现最好的模型正确识别类别的错误率为 9.0%(见图 10.21)。当前所有顶尖的图像分类模型都基于 Transformer(见第 12 章)。
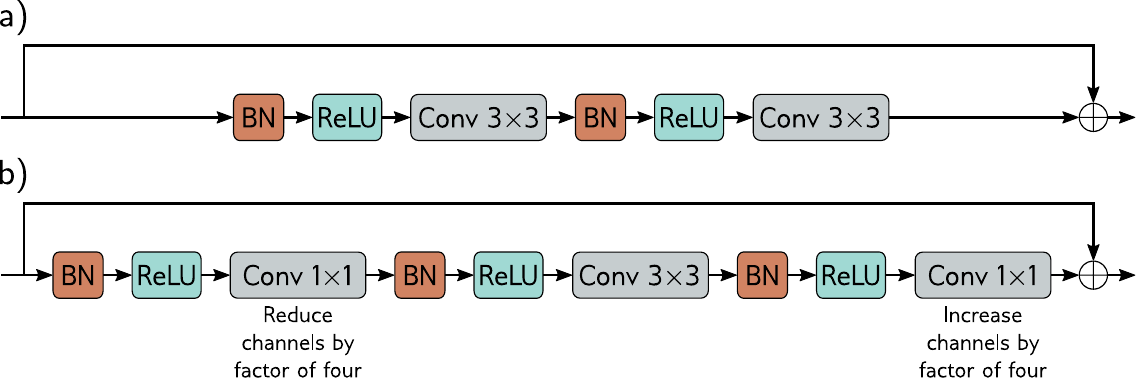
图 11.7 ResNet 块。a) ResNet 架构中的标准块包含一个批量归一化操作、一个激活函数和一个
卷积层。然后重复此序列。b) 瓶颈 ResNet 块仍然在 区域上整合信息,但使用更少的参数。它包含三个卷积。第一个 卷积减少通道数。第二个 卷积应用于较小的表示。最后一个 卷积再次增加通道数,使其可以加回到输入上。
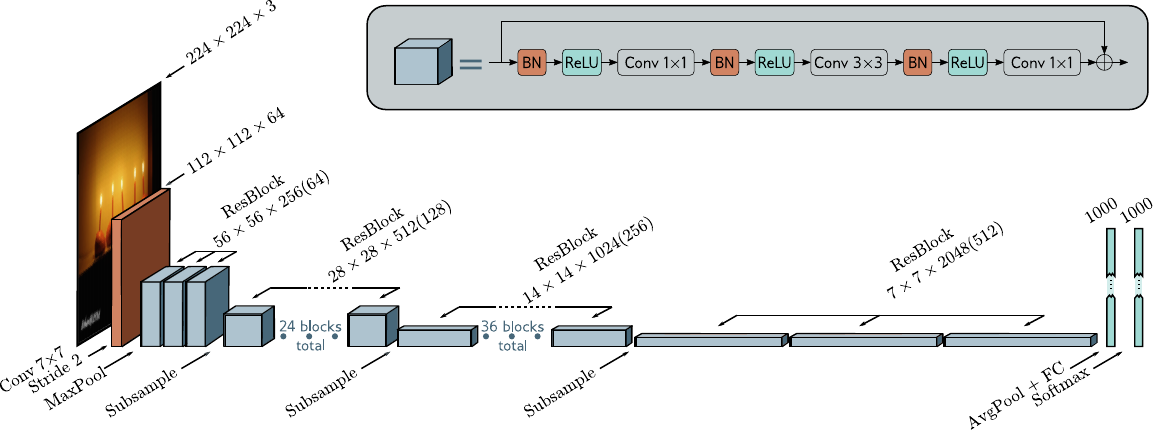
图 11.8 ResNet-200 模型。首先应用步幅为二的标准
卷积层,后接 MaxPool 操作。然后是一系列瓶颈残差块(括号中的数字是第一个 卷积后的通道数),周期性下采样并同步增加通道数。网络最后以跨所有空间位置的平均池化和一个映射到 softmax 前激活值的全连接层结束。
11.5.2 DenseNet
残差块接收前一层的输出,通过一些网络层修改它,然后加回到原始输入。另一种替代方案是拼接修改后的信号和原始信号。这增加了表示的大小(对于卷积网络来说是通道数),但可选的后续线性变换(对于卷积网络来说是
DenseNet 架构使用拼接,使得传入某一层的输入包含来自所有前面层的拼接输出(图 11.9)。这些被处理后创建一个新的表示,该表示本身与之前的表示拼接并传递给下一层。这种拼接意味着存在从较早层到输出的直接贡献,因此损失曲面表现合理。
在实际中,这只能维持几层,因为通道数(以及处理它们所需的参数数量)变得越来越大。这个问题可以通过在
该网络在图像分类上与 ResNet 模型表现相当(见图 10.21);实际上,在可比的参数量下,它可以表现更好。这大概是因为它可以更灵活地重用来自较早层的处理结果。
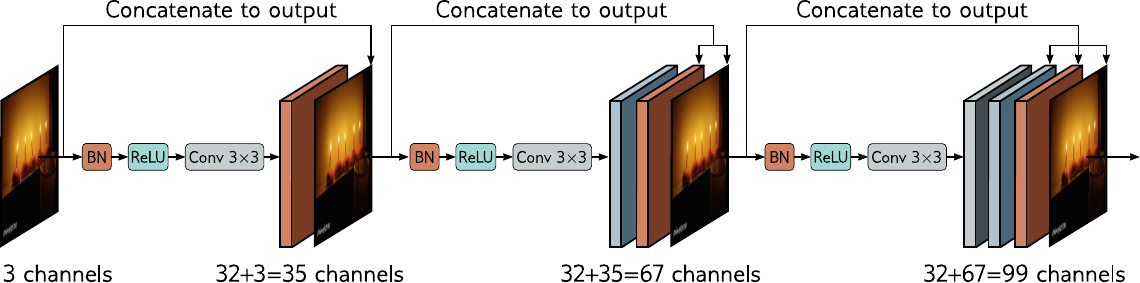
图 11.9 DenseNet。该架构使用残差连接将较早层的输出拼接到后面的层。此处,三通道输入图像被处理为 32 通道表示。输入图像被拼接到其上,得到共 35 个通道。这个组合表示被处理为另一个 32 通道表示,两个较早的表示都被拼接到其上,得到共 67 个通道,依此类推。
11.5.3 U-Net 与沙漏网络
第 10.5.3 节描述了一种具有编码器-解码器或沙漏结构的语义分割网络。编码器反复下采样图像,直到感受野覆盖整个图像并整合全局信息。然后解码器将其上采样回原始图像大小。最终输出是每个像素上可能目标类别的概率分布。这种架构的一个缺点是,网络中间的低分辨率表示必须"记住"高分辨率细节才能使最终结果准确。如果残差连接将编码器的表示传递给解码器中的对应层,这就不再必要了。
U-Net(图 11.10)是一种编码器-解码器架构,其中较早的表示被拼接到后面的层。原始实现使用"有效"卷积,因此每次应用
U-Net 最初设计用于医学图像分割(图 11.11),但在计算机图形和视觉领域也有广泛应用。沙漏网络(hourglass networks)与之类似,但在跳跃连接中应用额外的卷积层,并将处理结果加回而非拼接到解码器。一系列这样的模型形成堆叠沙漏网络(stacked hourglass network),交替在局部和全局层面考虑图像。这样的网络用于姿态估计(图 11.12)。系统被训练为预测每个关节的"热力图",估计位置为每个热力图的最大值。
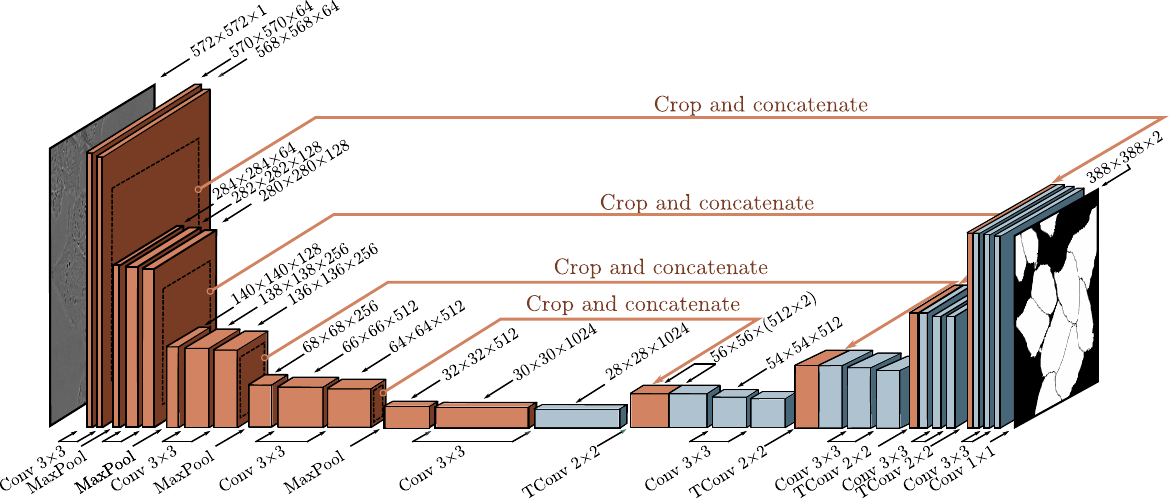
图 11.10 用于分割 HeLa 细胞的 U-Net。U-Net 具有编码器-解码器结构,其中表示先被下采样(橙色块)然后再上采样(蓝色块)。编码器使用常规卷积,解码器使用转置卷积。残差连接将编码器中每个尺度的最后表示附加到解码器中相同尺度的第一个表示上(橙色箭头)。原始 U-Net 使用"有效"卷积,因此即使没有下采样,每层的大小也会略有减小。因此,编码器的表示需要在附加到解码器之前被裁剪(虚线方块)。改编自 Ronneberger et al. (2015)。
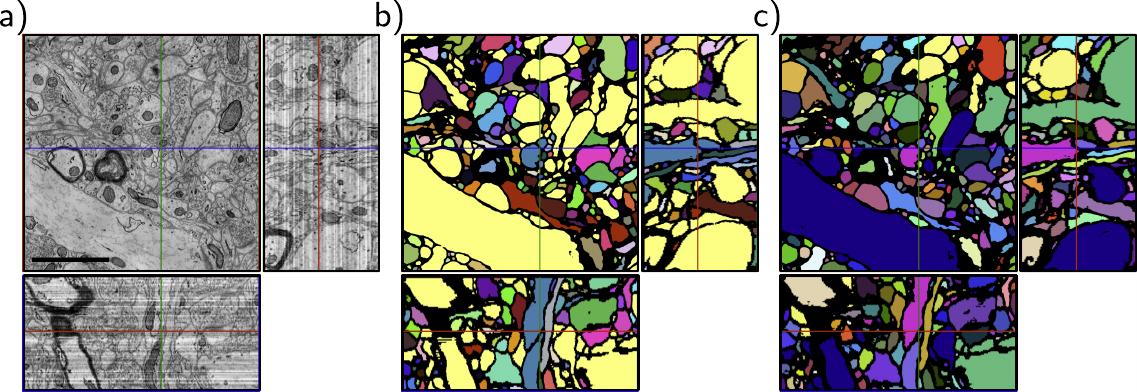
图 11.11 使用 U-Net 进行 3D 分割。a) 通过扫描电子显微镜拍摄的小鼠皮层 3D 体积的三个切片。b) 使用单个 U-Net 对体素进行内外分类。连通区域用不同颜色标识。c) 为获得更好的结果,训练五个 U-Net 的集成,只有当所有五个网络都同意时,才将体素分类为属于该细胞。改编自 Falk et al. (2019)。
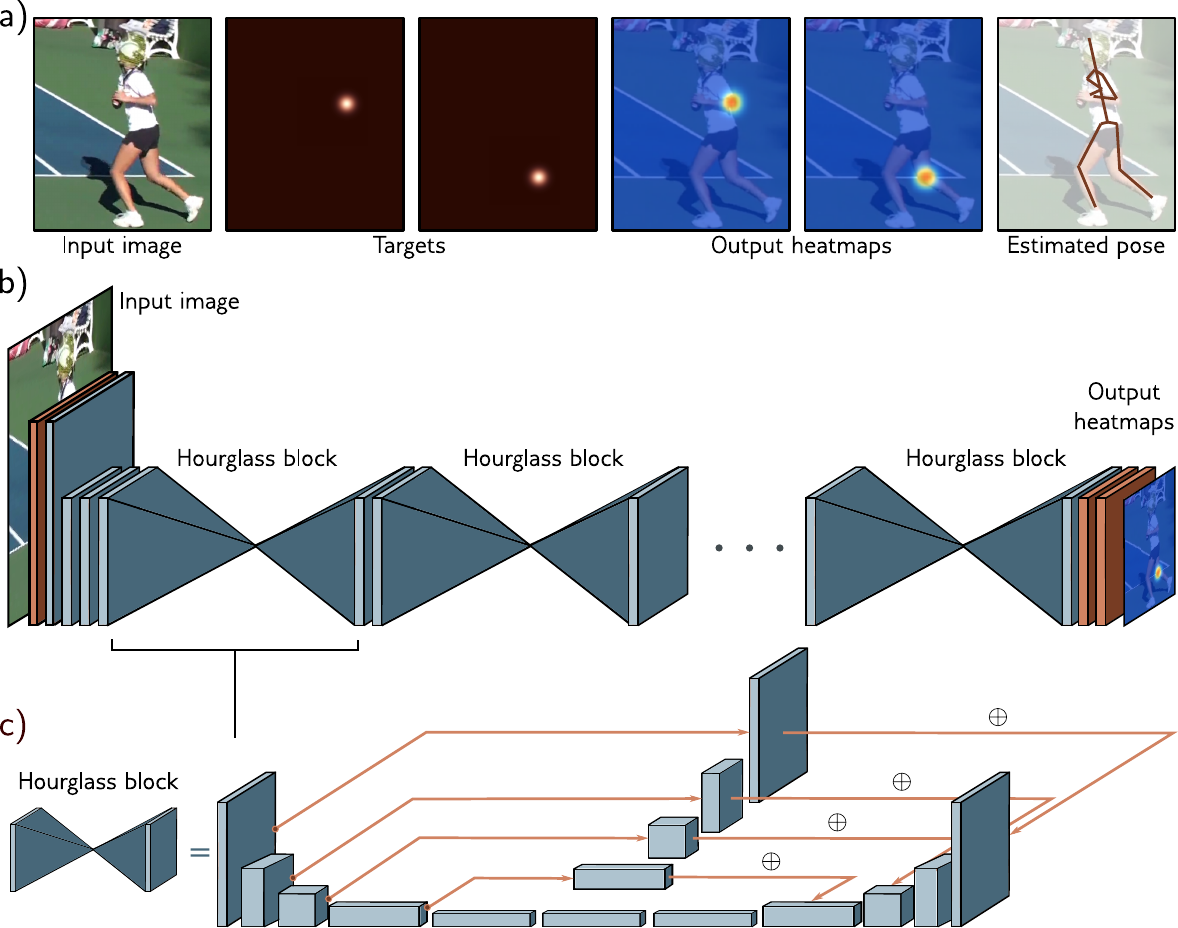
图 11.12 用于姿态估计的堆叠沙漏网络。a) 网络输入是包含人物的图像,输出是一组热力图,每个关节一个。这被形式化为回归问题,目标是热力图图像,在真实关节位置处有小的高亮区域。估计热力图的峰值用于确定每个最终关节位置。b) 架构由初始卷积层和残差层组成,后接一系列沙漏块。c) 每个沙漏块由类似 U-Net 的编码器-解码器网络组成,但卷积使用零填充,跳跃连接中进行一些额外处理,且这些连接将处理后的表示加到而非拼接到解码器。每个蓝色方块本身是一个瓶颈残差块(图 11.7b)。改编自 Newell et al. (2016)。
11.6 残差连接为何表现如此好?
残差网络允许训练更深的网络;ResNet 架构可以扩展到 1000 层并仍然有效训练。图像分类性能的提升最初被归因于额外的网络深度,但有两个证据与此观点相矛盾。
首先,更浅但更宽的残差网络有时在可比参数量下优于更深但更窄的网络。换句话说,更好的性能有时可以通过使用更少的层但每层更多通道的网络来实现。其次,有证据表明梯度在训练过程中不能有效地通过展开网络中的很长路径传播(图 11.4b)。实际上,一个非常深的网络可能更像是较浅网络的组合。
目前的观点是,残差连接本身增加了一些价值,同时也允许训练更深的网络。这一观点得到以下事实的支持:残差网络在最小值附近的损失曲面往往比移除跳跃连接的同一网络更加平滑和可预测(图 11.13)。这可能使得更容易学习到一个泛化良好的解。
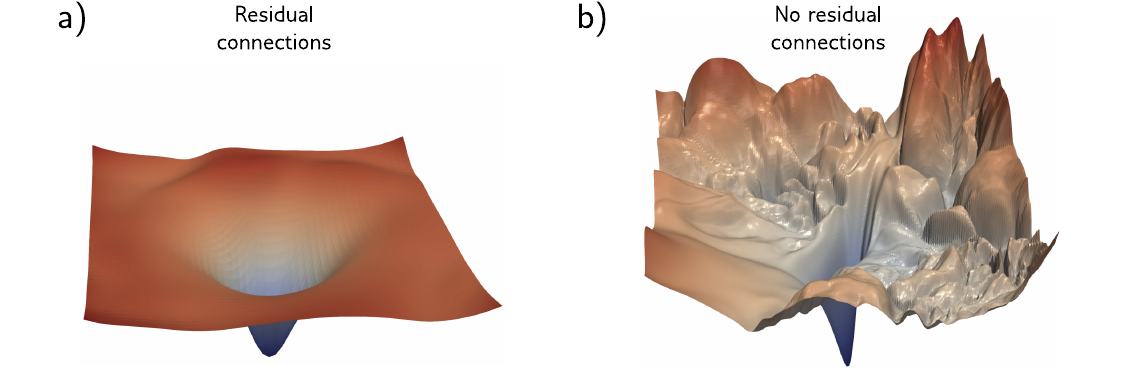
图 11.13 可视化神经网络损失曲面。每个图显示了参数空间中围绕 SGD 在 CIFAR-10 图像分类任务上找到的最小值的两个随机方向上的损失曲面。这些方向经过归一化以便于并排比较。a) 具有 56 层的残差网络。b) 同一网络但没有跳跃连接的结果。带跳跃连接的曲面更平滑,这有助于学习,并使最终网络性能对参数的小误差更加鲁棒,因此它很可能泛化得更好。改编自 Li et al. (2018b)。
11.7 总结
无限增加网络深度会导致图像分类的训练和测试性能都下降。这可能是因为网络中早期参数的损失梯度相对于更新步长变化过快且不可预测。残差连接将处理后的表示加回到其自身输入上。现在每一层既直接又间接地贡献到输出,因此通过多层传播梯度不再是必需的,损失曲面更加平滑。
残差网络不受梯度消失的影响,但会在前向传播过程中引入激活值方差的指数增长以及相应的梯度爆炸问题。这通常通过添加批量归一化来处理,它补偿批次的经验均值和方差,然后使用学习的参数进行平移和缩放。如果这些参数被审慎地初始化,就可以训练非常深的网络。有证据表明,残差连接和批量归一化都使损失曲面更加平滑,这允许使用更大的学习率。此外,批次统计量中的变异性增加了一种正则化来源。
残差块已被集成到卷积网络中。它们允许训练更深的网络,并伴随着图像分类性能的相应提升。残差网络的变体包括 DenseNet 架构(将所有前面层的输出拼接起来传入当前层)和 U-Net(将残差连接集成到编码器-解码器模型中)。