
第8章 性能度量
前面的章节描述了神经网络模型、损失函数和训练算法。本章考虑如何度量训练后模型的性能。在容量充足(即隐藏单元数量足够多)的情况下,神经网络模型通常能在训练数据上达到完美的表现。然而,这并不一定意味着它能够很好地泛化到新的测试数据。
我们将看到,测试误差有三个不同的来源,它们的相对贡献取决于 (i) 任务中固有的不确定性,(ii) 训练数据的数量,以及 (iii) 模型的选择。后者引出了超参数搜索的问题。我们讨论如何选择模型超参数(例如隐藏层数和每层隐藏单元数)以及学习算法超参数(例如学习率和批次大小)。
8.1 训练一个简单模型
我们使用 MNIST-1D 数据集来探索模型性能(图 8.1)。该数据集包含十个类别
我们使用一个具有
然而,这并不意味着分类器是完美的;模型可能只是记住了训练集而无法预测新样本。为了估计真正的性能,我们需要一个单独的测试集(test set),其中包含输入/输出对
测试损失(图 8.2b)在前 1500 个训练步中降低,但随后再次增加。此时测试错误率基本保持不变;模型犯同样的错误,但置信度越来越高。这降低了正确答案的概率,从而增加了负对数似然。这种置信度增加是 softmax 函数的一个副效应;softmax 之前的激活值被推向越来越极端的值,以使训练数据的概率趋近于 1(见图 5.10)。
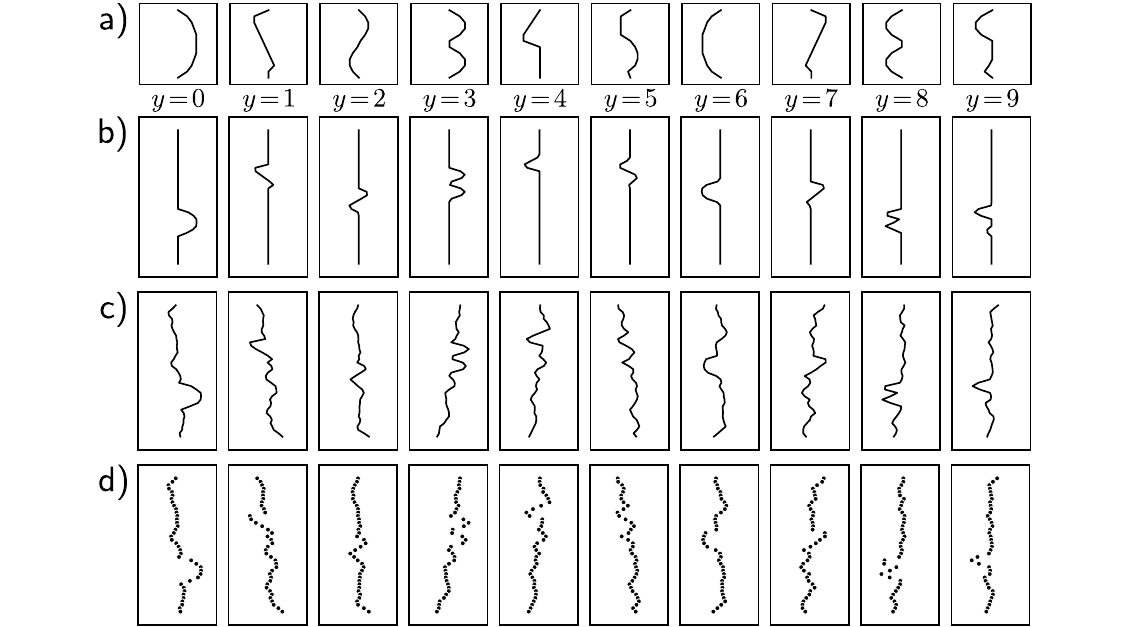
图 8.1 MNIST-1D。a) 10 个类别
的模板,基于数字 0–9。b) 训练样本 通过随机变换模板和 c) 添加噪声来创建。d) 变换后模板的水平偏移在 40 个垂直位置处采样。改编自 Greydanus (2020)。
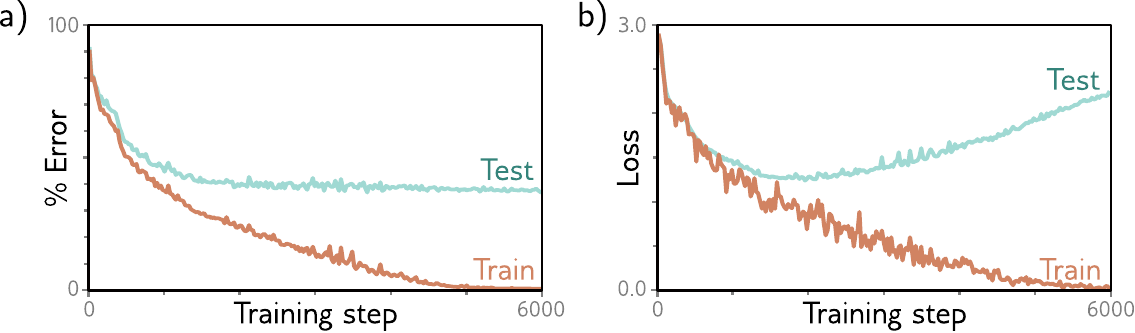
图 8.2 MNIST-1D 结果。a) 分类错误率(百分比)随训练步数的变化。训练集错误率降至零,但测试错误率不会降到约 40% 以下。该模型不能很好地泛化到新测试数据。b) 损失随训练步数的变化。训练损失稳步下降趋近于零。测试损失先降低后增加,因为模型对其(错误的)预测越来越有信心。
8.2 误差来源
我们现在考虑模型泛化失败时出现的误差来源。为使其更容易可视化,我们回到一维最小二乘回归问题,其中我们确切知道真实数据是如何生成的。图 8.3 展示了一个准正弦函数;训练数据和测试数据都是在
我们将一个简化的浅层神经网络拟合到这些数据上(图 8.4)。连接输入层到隐藏层的权重和偏置被预先选定,使得函数的"关节"均匀分布在区间上。如果有
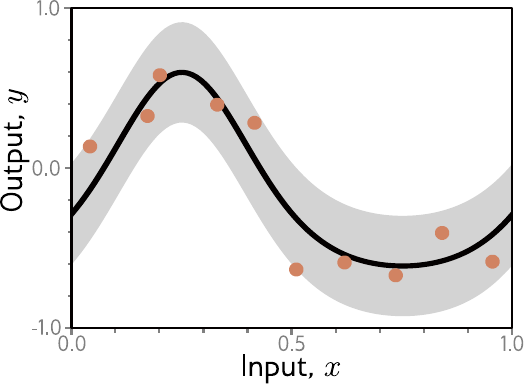
图 8.3 回归函数。实线黑色曲线表示真实函数。为生成
个训练样本 ,将输入空间 分为 个等大小的区间,在每个区间内从均匀分布中抽取一个样本 。对应的值 通过在 处计算函数值并添加高斯噪声来生成(灰色区域表示 ±2 个标准差)。测试数据以同样方式生成。
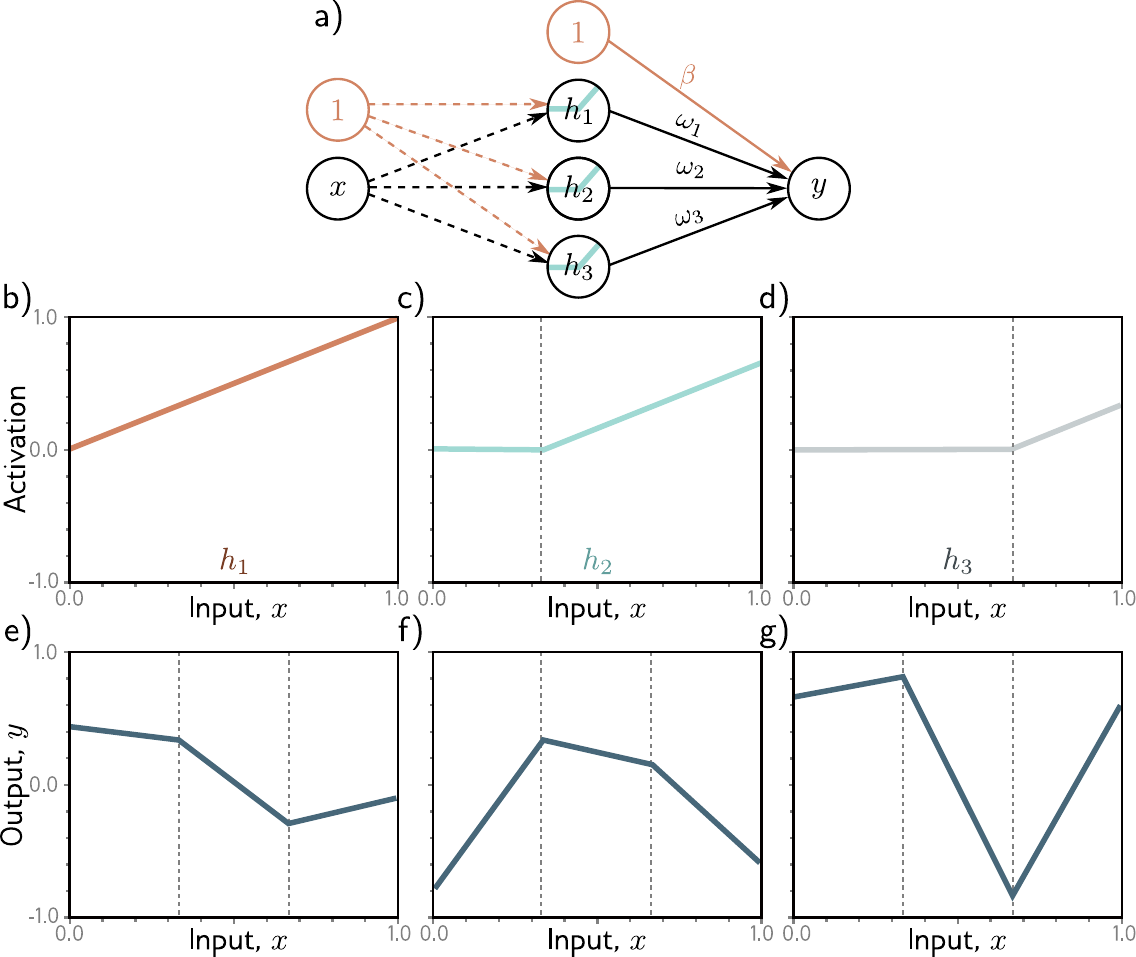
图 8.4 简化的三隐藏单元神经网络。a) 输入层到隐藏层之间的权重和偏置是固定的(虚线箭头)。b–d) 选择方式使得隐藏单元激活值的斜率为一,关节均匀分布在区间上,位于
、 和 。修改剩余参数 可以创建 上关节在 1/3 和 2/3 处的任何分段线性函数。e–g) 不同参数值 对应的三个示例函数。
8.2.1 噪声、偏差和方差
有三种可能的误差来源,分别称为噪声(noise)、偏差(bias)和方差(variance)(图 8.5):
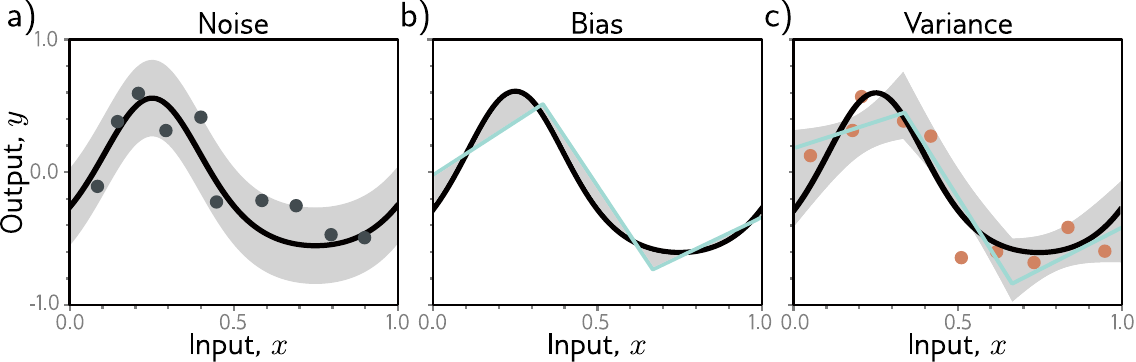
图 8.5 测试误差来源。a) 噪声。数据生成过程含有噪声,因此即使模型完美复现了真实底层函数(黑色线),测试数据中的噪声(灰色点)意味着仍会存在一些误差(灰色区域表示两个标准差)。b) 偏差。即使参数选择最优,三区域模型(青色线)也无法完全拟合真实函数(黑色线)。这种偏差是另一个误差来源(灰色区域表示有符号误差)。c) 方差。在实践中,我们使用有限且含噪声的训练数据(橙色点)。拟合模型时,我们得到的不是面板 (b) 中的最佳函数,而是一个略有不同的函数(青色线),它反映了训练数据的特异性。这提供了额外的误差来源。图 8.6 显示了该区域的计算方法。
噪声 数据生成过程包含噪声的添加,因此对于每个输入
噪声可能产生的原因包括:数据生成过程中存在真正的随机成分、部分数据被标注错误,或者存在未被观测的进一步解释变量。在极少数情况下,噪声可能不存在;例如,网络可能在近似一个确定性但计算量极大的函数。然而,噪声通常是测试性能的基本限制因素。
偏差 第二个潜在误差来源是模型不够灵活,无法完美拟合真实函数。例如,即使参数选择最优,三区域的神经网络模型也无法精确描述准正弦函数(图 8.5b)。这被称为偏差。
方差 我们拥有的训练样本有限,且无法区分底层函数中的系统性变化与数据中的噪声。当我们拟合模型时,得到的不是对真实底层函数最近的逼近。实际上,对于不同的训练数据集,结果每次都会略有不同。拟合函数中的这一额外变异性来源被称为方差(图 8.5c)。在实践中,由于随机学习算法不一定每次都收敛到相同的解,可能还会有额外的方差。
8.2.2 测试误差的数学表述
我们现在将噪声、偏差和方差的概念数学化。考虑一个一维回归问题,其中数据生成过程具有方差为
且固定噪声
现在考虑模型预测
其中我们在第二行同时加上和减去了底层函数的均值
底层函数是随机的,因此损失取决于我们观察到的特定
其中我们使用了期望的运算规则。在第二行,我们将期望算子分配到各项,并从与
可以看出,期望损失已被分解为两项:第一项是模型与真实函数均值之间的偏差的平方,第二项是噪声。
第一项可以进一步分解为偏差和方差。模型
回到方程 8.3 的第一项,我们加上并减去
然后对训练数据集
其中我们使用了与方程 8.3 类似的化简步骤。最后,将此结果代入方程 8.3:
该方程表明,在考虑训练数据
8.3 减小误差
在上一节中,我们看到测试误差来源于三个方面:噪声、偏差和方差。噪声分量是不可克服的;我们无法绕过它,它代表了模型期望性能的基本极限。然而,可以减小其他两项。
8.3.1 减小方差
回顾一下,方差来源于有限且含噪声的训练数据。对不同的训练集拟合模型会产生略微不同的参数。因此,我们可以通过增加训练数据的数量来减小方差。这既能平均掉固有噪声,又能确保输入空间被充分采样。
图 8.6 展示了使用 6、10 和 100 个样本进行训练的效果。对于每种数据集大小,我们展示了三个训练数据集上的最优拟合模型。仅用六个样本时,拟合函数每次都相当不同:方差很大。随着样本数增加,拟合模型变得非常相似,方差减小。一般来说,增加训练数据几乎总能改善测试性能。
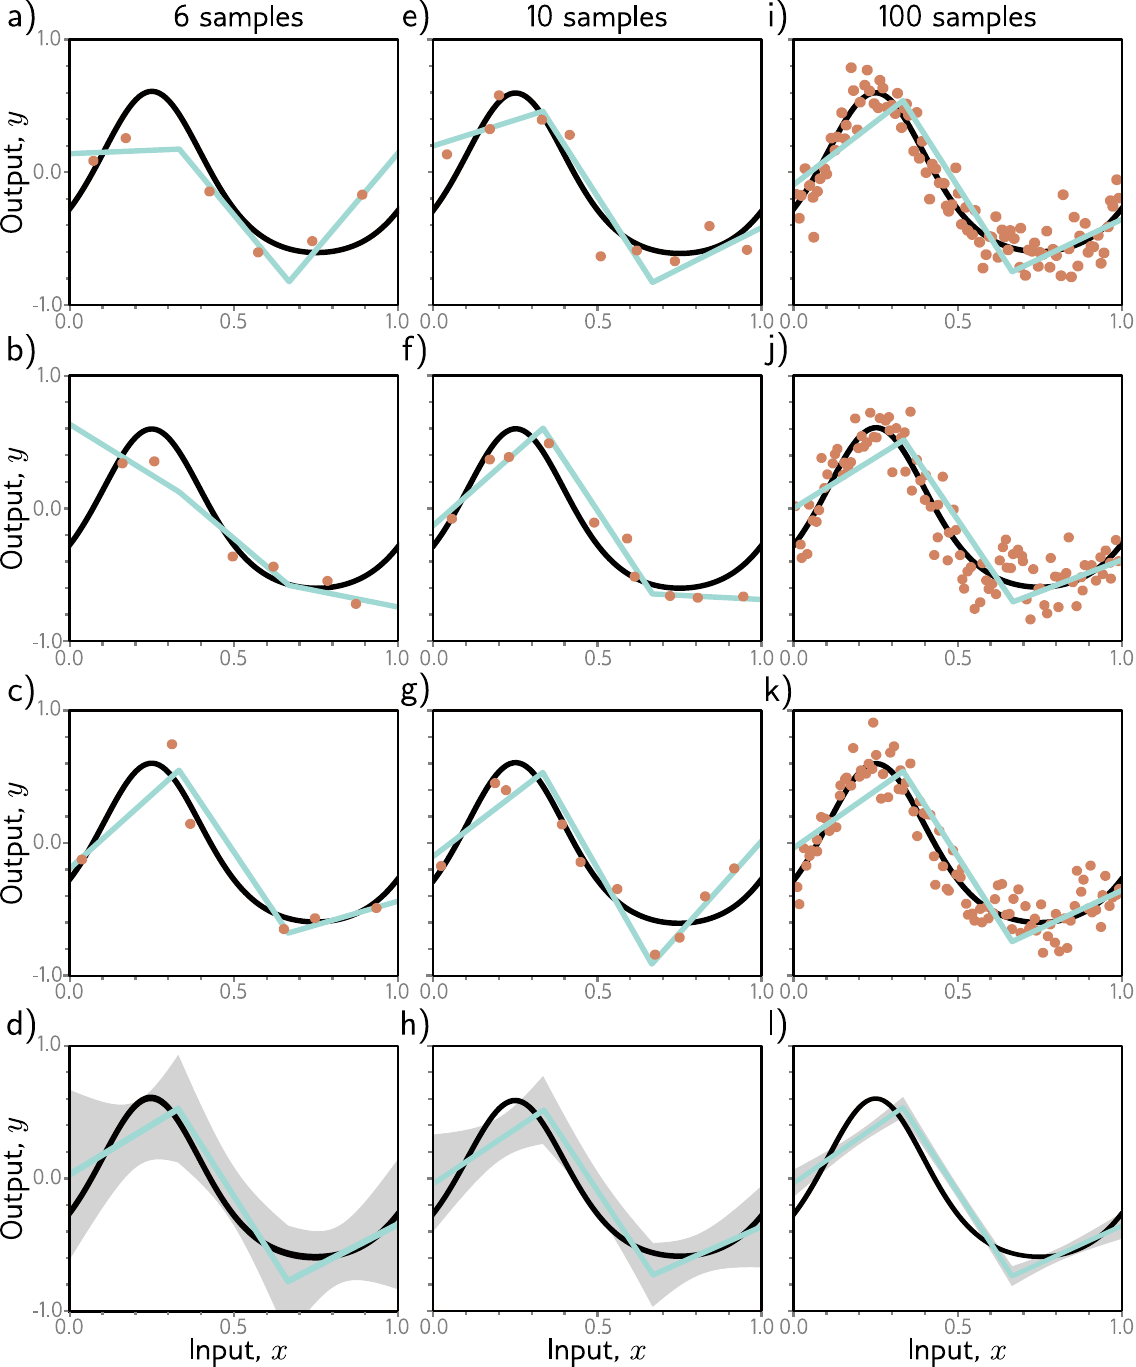
图 8.6 通过增加训练数据来减小方差。a–c) 三区域模型分别拟合到三个随机采样的 6 个点的数据集上。每次拟合的模型都相当不同。d) 我们多次重复该实验,绘制平均模型预测(青色线)和模型预测的方差(灰色区域表示两个标准差)。e–h) 同样的实验,但使用大小为 10 的数据集。预测的方差减小了。i–l) 使用大小为 100 的数据集重复实验。此时拟合的模型始终非常相似,方差很小。
8.3.2 减小偏差
偏差项源于模型无法描述真实底层函数。这表明我们可以通过使模型更灵活来减小该误差。这通常通过增加模型容量(capacity)来实现。对于神经网络,这意味着增加更多隐藏单元和/或更多隐藏层。
在简化模型中,增加容量对应于增加更多隐藏单元,使得区间
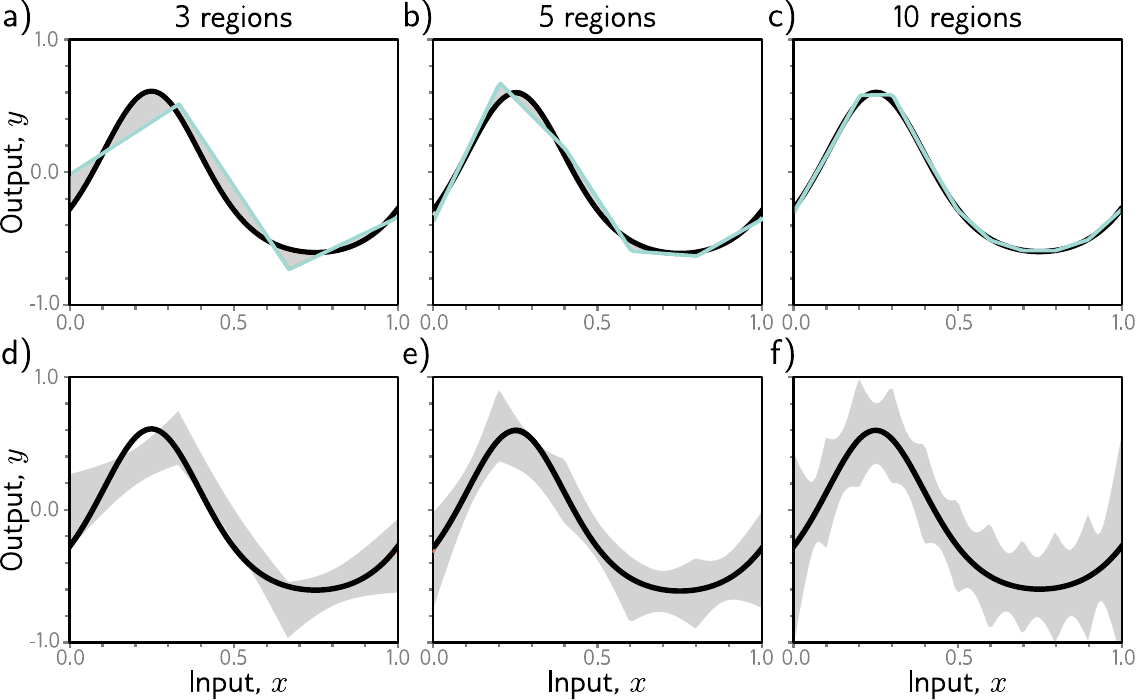
图 8.7 偏差和方差随模型容量的变化。a–c) 随着隐藏单元数的增加,玩具模型中线性区域的数量增加,模型变得能够紧密拟合真实函数;偏差(灰色区域)减小。d–f) 不幸的是,增加模型容量有一个副作用,即方差项(灰色区域)增大。这被称为偏差-方差权衡。
8.3.3 偏差-方差权衡
然而,图 8.7d–f 展示了增加模型容量的一个意外副作用。对于固定大小的训练数据集,方差项通常随模型容量的增加而增大。因此,增加模型容量不一定能减小测试误差。这被称为偏差-方差权衡(bias-variance trade-off)。
图 8.8 探讨了这一现象。在面板 a–c 中,我们将简化的三区域模型分别拟合到三个不同的 15 个点的数据集上。虽然数据集不同,但最终模型大致相同;数据集中的噪声在每个线性区域内被大致平均化了。在面板 d–f 中,我们将十区域模型拟合到相同的三个数据集上。该模型更灵活,但这反而是不利的;模型确实能更好地拟合数据,训练误差也更低,但大量的额外描述能力被用于建模噪声。这种现象被称为过拟合(overfitting)。
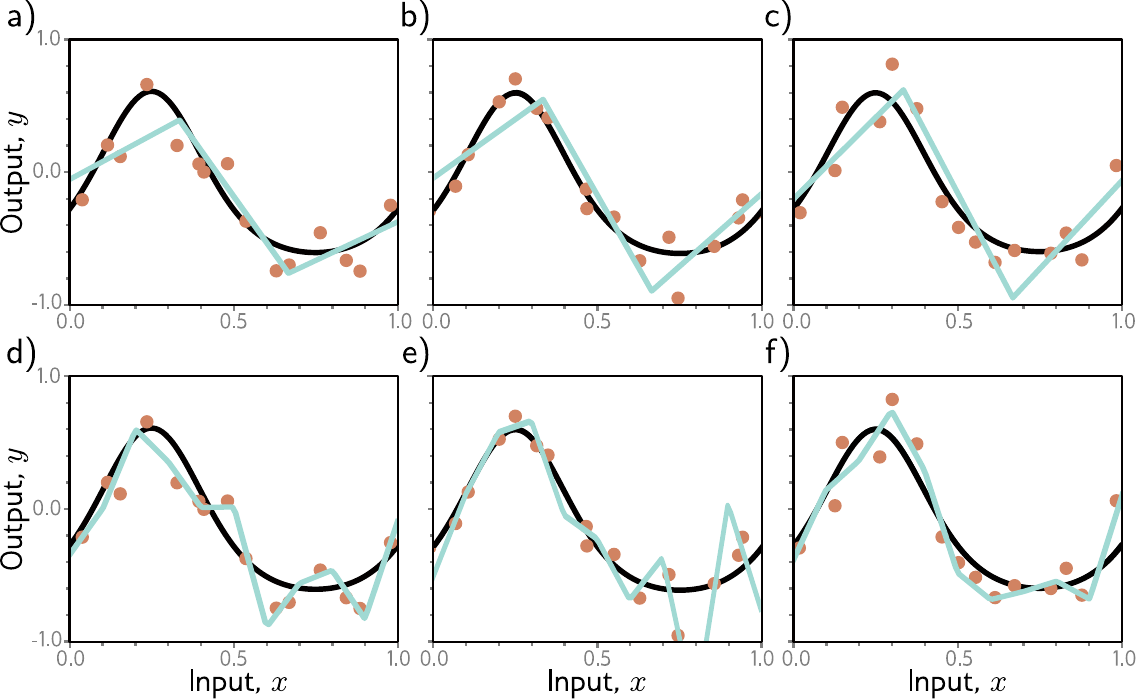
图 8.8 过拟合。a–c) 三区域模型分别拟合三个不同的 15 点数据集。三种情况下结果相似(即方差低)。d–f) 十区域模型拟合相同数据集。额外的灵活性并不一定产生更好的预测。虽然这三个模型各自更好地描述了训练数据,但它们不一定更接近真实底层函数(黑色曲线)。相反,它们过拟合了数据并描述了噪声,拟合曲线之间的方差(差异)更大。
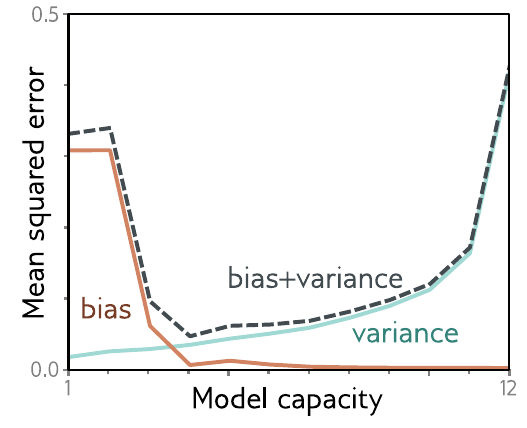
图 8.9 偏差-方差权衡。方程 8.7 中的偏差项和方差项作为简化模型容量(隐藏单元数/数据范围内线性区域数)的函数绘制,使用图 8.8 的训练数据。随着容量增加,偏差(实线橙色线)减小,但方差(实线青色线)增大。两者之和(灰色虚线)在容量为四时最小。
我们已经看到,随着模型容量的增加,偏差减小但方差增大。这表明存在一个最优容量,此时偏差不太大而方差仍相对较小。图 8.9 使用图 8.8 的数据,数值地展示了这些项随玩具模型容量的变化。对于回归模型,总期望误差是偏差和方差之和,且该和在模型容量为四时(即四个隐藏单元和四个覆盖数据范围的线性区域)最小化。
8.4 双重下降
在上一节中,我们考察了随着模型容量增加时的偏差-方差权衡。现在让我们回到 MNIST-1D 数据集,看看这在实践中是否成立。我们使用 10,000 个训练样本,另外 5,000 个样本作为测试集,并随着模型容量(参数数量)的增加,考察训练和测试性能。我们使用 Adam 优化器,步长为 0.005,全批次 10,000 个样本,训练 4000 步。
图 8.10a 展示了一个双隐藏层神经网络随隐藏单元数增加时的训练和测试误差。训练误差随容量增长而降低,很快接近零。垂直虚线表示模型参数数量与训练样本数相等的容量。测试误差在增加模型容量时下降,但并没有像偏差-方差权衡曲线所预测的那样增加;它持续下降。
在图 8.10b 中,我们重复这个实验,但这次将 15% 的训练标签随机化。训练误差同样降至零,尽管此时需要几乎与训练点数一样多的参数才能记住数据。测试误差确实表现出典型的偏差-方差权衡——它先随容量增加而下降,然后在模型精确拟合训练数据的点附近再次增加。然而,它随后做了一些出人意料的事:开始再次下降。事实上,如果我们增加足够多的容量,测试损失会降低到曲线第一段所达到的最低水平以下。
这种现象被称为双重下降(double descent)。对于某些数据集如 MNIST,它在原始数据上就存在(图 8.10c)。对于其他数据集如 MNIST-1D 和 CIFAR-100(图 8.10d),当我们向标签添加噪声时,它才出现或变得更加明显。曲线的第一段被称为经典或欠参数化(under-parameterized)区间,第二段被称为现代或过参数化(over-parameterized)区间。误差增加的中间部分被称为临界区间(critical regime)。
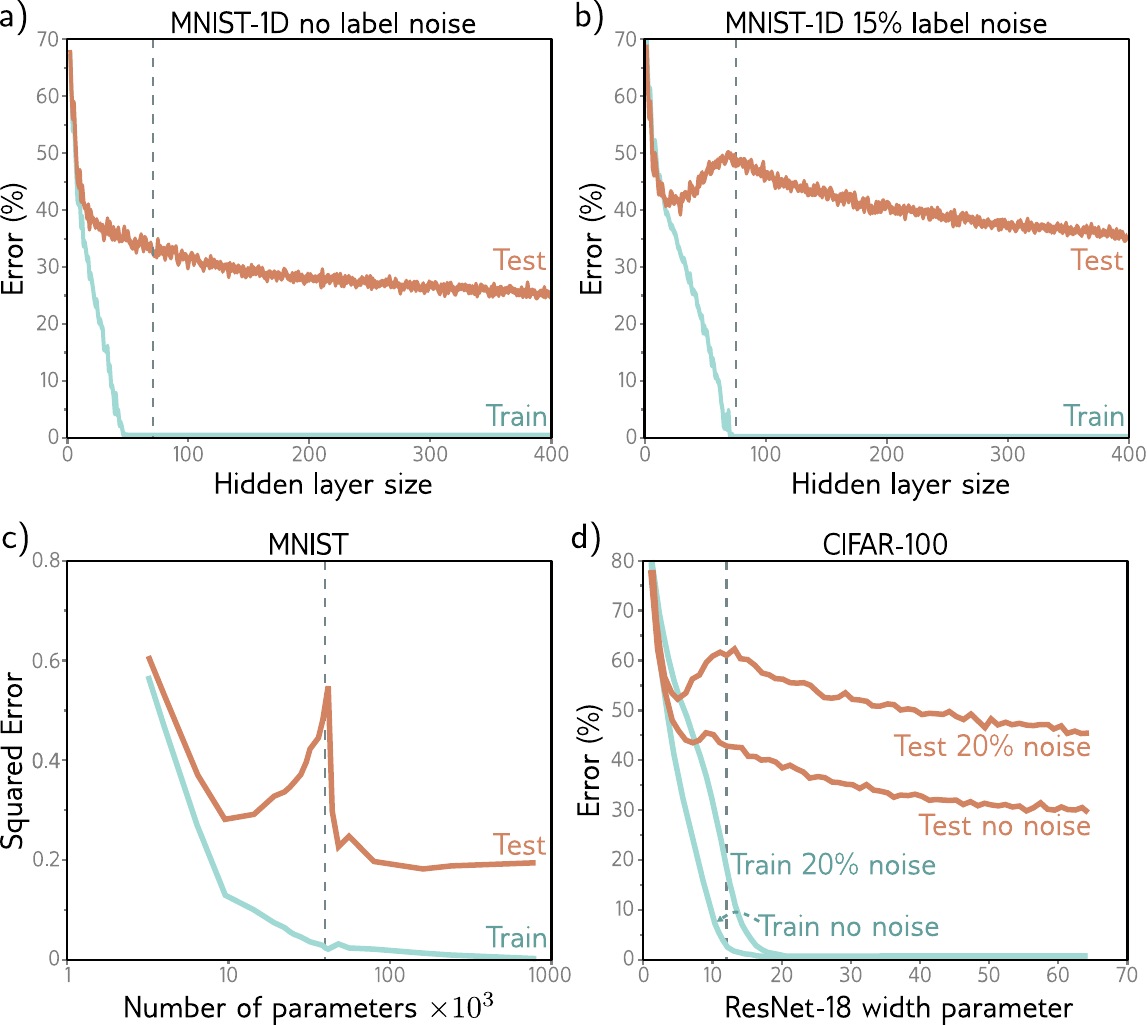
图 8.10 双重下降。a) MNIST-1D 上双隐藏层网络的训练和测试误差,随隐藏单元数(因此每层参数数)增加而变化。当参数数量接近训练样本数时(垂直虚线),训练误差降至零。测试误差不显示预期的偏差-方差权衡,在模型记住数据集后仍继续下降。b) 使用更嘈杂的训练数据重复同一实验。训练误差同样降至零,尽管现在几乎需要与训练点数一样多的参数来记住数据集。测试误差表现出预测的偏差/方差权衡;它先随容量增加而下降,然后在训练数据被精确记住的点附近再次增加。然而,它随后再次下降,最终达到更好的性能水平。这被称为双重下降。根据损失函数、模型和数据中的噪声量不同,双重下降模式在不同数据集上的表现程度各异。c) MNIST 上使用浅层神经网络(无标签噪声)的结果,来自 Belkin et al. (2019)。d) CIFAR-100 上使用 ResNet18 网络(见第 11 章)的结果,来自 Nakkiran et al. (2021)。请参见原始论文了解详情。
8.4.1 解释
双重下降的发现是最近的,出人意料的,也在某种程度上令人困惑。它来自两种现象的相互作用。首先,当模型恰好有足够的容量来记住数据时,测试性能暂时变差。其次,即使容量超过了训练数据被完全正确分类的点,测试性能仍继续随容量改善。第一种现象完全符合偏差-方差权衡的预测。第二种现象更令人费解;在过参数化区间中,训练数据点甚至不足以唯一约束模型参数,为什么性能反而会更好,原因并不清楚。
要理解为什么性能随参数增加继续改善,请注意一旦模型有足够的容量将训练损失驱至接近零,模型就能几乎完美地拟合训练数据。这意味着进一步的容量无法帮助模型更好地拟合训练数据;任何变化都必然发生在训练数据点之间。模型倾向于优先选择一种解而非另一种的趋势,被称为其归纳偏好(inductive bias)。
模型在数据点之间的行为至关重要,因为在高维空间中,训练数据极其稀疏。MNIST-1D 数据集有 40 个维度,我们使用了 10,000 个训练样本。如果我们将每个输入维度粗略地量化为 10 个区间,总共会有
这意味着,高维空间中的问题可能更像图 8.11a 的情况:我们在有数据的小区域之间存在显著的间隙。双重下降的一种可能解释是,随着容量的增加,模型在最近的数据点之间的插值越来越平滑。在缺乏信息的情况下,假设平滑性是合理的,这样的模型可能会较好地泛化到新数据。
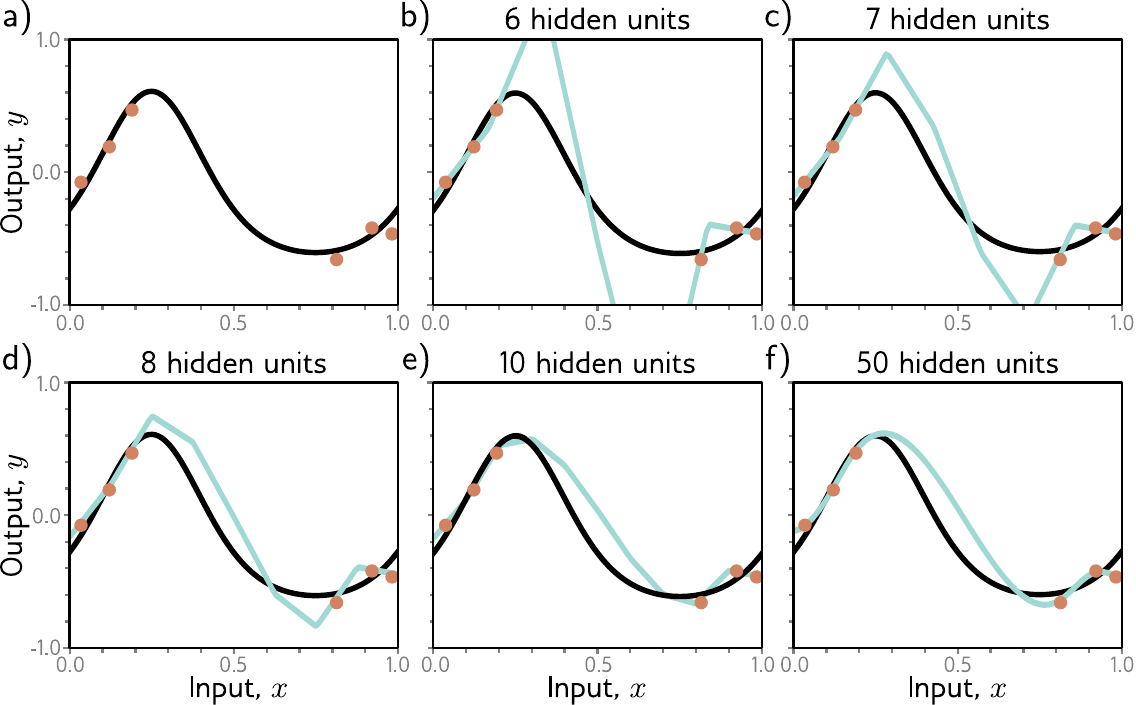
图 8.11 增加容量(隐藏单元)允许在稀疏数据点之间进行更平滑的插值。a) 考虑训练数据(橙色圆圈)稀疏的情况;中心有一大片区域没有数据样本来约束模型模拟真实函数(黑色曲线)。b) 如果我们用恰好足够的容量来拟合训练数据(青色曲线),它必须扭曲自身才能通过训练数据点,输出预测将不平滑。c–f) 然而,随着隐藏单元的增加,模型有能力在数据点之间更平滑地插值(每种情况下绘制的是最平滑的可能曲线)。但与图中不同的是,模型并不必然如此。
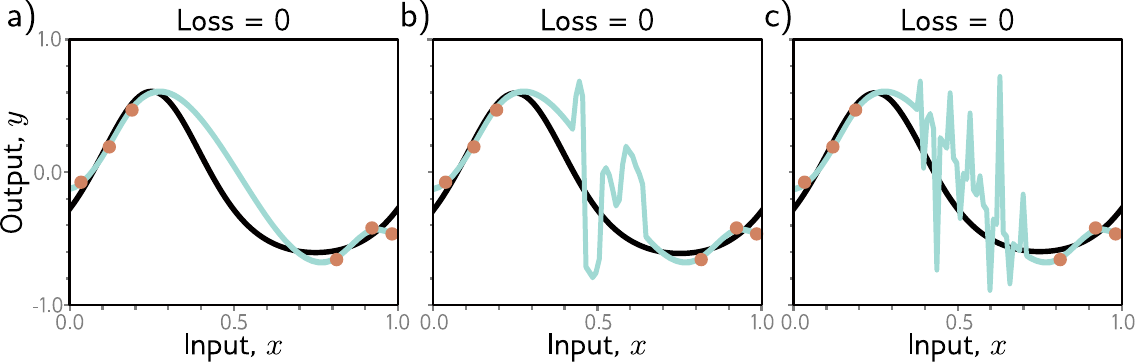
图 8.12 正则化。a–c) 三条拟合曲线都精确通过数据点,因此每条的训练损失都为零。然而,我们可能期望面板 (a) 中的平滑曲线比面板 (b) 和 (c) 中不规则的曲线更好地泛化到新数据。使模型偏向于具有相似训练损失的解的子集的任何因素都被称为正则化器。人们认为神经网络的初始化和/或拟合过程具有隐式正则化效果。因此,在过参数化区间中,更合理的解(如面板 (a) 中的)会被鼓励。
这个论证是合理的。随着容量的增加,模型确实有能力创建更平滑的函数。图 8.11b–f 展示了随着隐藏单元数增加,仍然通过数据点的最平滑可能函数。当参数数量非常接近训练样本数量时(图 8.11b),模型被迫扭曲自身来精确拟合训练数据,导致预测不稳定。这解释了为什么双重下降曲线中的峰值如此明显。随着隐藏单元的增加,模型有能力构造更平滑的函数,这些函数更可能很好地泛化到新数据。
然而,这并不能解释为什么过参数化模型应该产生平滑函数。图 8.12 展示了简化模型在 50 个隐藏单元情况下可以创建的三种函数。在每种情况下,模型都精确拟合数据,因此损失为零。如果双重下降的现代区间可以用增加平滑性来解释,那么究竟是什么在鼓励这种平滑性?
对此问题的答案尚不确定,但有两种可能的解释。首先,网络初始化可能鼓励平滑性,模型在训练过程中永远不会偏离平滑函数的子域。其次,训练算法可能以某种方式"偏好"收敛到平滑函数。使解偏向于一组等价解子集的任何因素都被称为正则化器(regularizer),因此一种可能是训练算法作为隐式正则化器发挥作用(见第 9.2 节)。
8.5 选择超参数
在上一节中,我们讨论了测试性能如何随模型容量变化。不幸的是,在经典区间中,我们无法获知偏差(这需要知道真实底层函数)或方差(这需要多个独立采样的数据集来估计)。在现代区间中,也无法知道测试误差何时停止改善。这引出了如何在实践中选择模型容量的问题。
对于深度网络,模型容量取决于隐藏层数和每层隐藏单元数,以及我们尚未介绍的其他架构方面。此外,学习算法的选择及其关联参数(学习率等)也会影响测试性能。这些因素统称为超参数(hyperparameters)。寻找最佳超参数的过程被称为超参数搜索(hyperparameter search)或(当聚焦于网络结构时)神经架构搜索(neural architecture search)。
超参数通常通过经验选择;我们在同一训练集上训练许多使用不同超参数的模型,度量它们的性能,并保留最佳模型。然而,我们不在测试集上度量性能;这样做的话,我们只能承认这些超参数恰好在测试集上表现良好,但不一定能泛化到更多数据。因此,我们引入第三个数据集,称为验证集(validation set)。对于每种超参数选择,我们用训练集训练对应的模型,并在验证集上评估性能。最后,我们选择在验证集上表现最好的模型,并在测试集上度量其性能。原则上,这应该给出对真实性能的合理估计。
超参数空间通常比参数空间小,但仍然太大,无法穷举所有组合。不幸的是,许多超参数是离散的(例如隐藏层数),有些超参数可能依赖于其他超参数(例如只有在有十层或更多层时,才需要指定第十隐藏层的单元数)。因此,我们不能像学习模型参数那样依赖梯度下降方法。超参数优化算法会智能地采样超参数空间,基于先前的结果进行调整。这一过程计算代价很高,因为每种超参数组合都需要训练一个完整的模型并度量验证集性能。
8.6 总结
为度量性能,我们使用单独的测试集。性能在测试集上保持的程度被称为泛化。测试误差可以由三个因素解释:噪声、偏差和方差。对于使用最小二乘损失的回归问题,它们以加性方式组合。增加训练数据可以减小方差。当模型容量小于训练样本数量时,增加容量可以减小偏差但增加方差。这被称为偏差-方差权衡,存在一个权衡最优的容量。
然而,这与性能倾向于随容量改善的趋势相平衡,即使参数超过训练样本数量。这两种现象共同创造了双重下降曲线。人们认为模型在过参数化"现代"区间中能更平滑地在训练数据点之间插值,尽管目前尚不清楚驱动这一现象的确切原因。要选择容量和其他模型及训练算法超参数,我们拟合多个模型并使用单独的验证集评估其性能。