
第13章 图神经网络
第 10 章描述了卷积网络,它们专门处理规则排列的数据(如图像)。第 12 章描述了 Transformer,它们专门处理可变长度的序列(如文本)。本章描述图神经网络(graph neural networks)。顾名思义,这些是处理图(即由边连接的节点集合)的神经架构。
处理图面临三个新的挑战。首先,图的拓扑结构是可变的,设计既足够表达又能应对这种变化的网络是困难的。其次,图可能非常庞大;表示社交网络用户之间连接的图可能有十亿个节点。第三,可能只有一个单一的整体图可用,因此用大量数据样本训练并在新数据上测试的常规方案并不总是适用。
本章首先展示图的真实世界示例,然后描述如何编码这些图以及如何为图制定监督学习问题。讨论处理图的算法要求,这些要求自然地引出图卷积网络(graph convolutional networks),一种特定类型的图神经网络。
13.1 什么是图?
图是一种非常通用的结构,由一组节点(nodes)或顶点(vertices)组成,其中节点对之间通过边(edges)或链接(links)相连。图通常是稀疏的;所有可能的边中只有一小部分存在。
现实世界中的一些对象天然具有图的形式。例如,道路网络可以视为图,其中节点是物理位置,边表示它们之间的道路(图 13.1a)。化学分子是小型图,其中节点表示原子,边表示化学键(图 13.1b)。电路是图,其中节点表示元器件和接点,边表示电气连接(图 13.1c)。
此外,许多数据集也可以表示为图,即使这不是它们表面上的形式。例如:
- 社交网络是图,其中节点是人,边表示人与人之间的友谊关系。
- 科学文献可以视为图,其中节点是论文,边表示引用关系。
- 维基百科可以视为图,其中节点是文章,边表示文章之间的超链接。
- 计算机程序可以表示为图,其中节点是语法标记(程序流中不同位置的变量),边表示涉及这些变量的计算。
- 几何点云可以表示为图,其中每个点是一个节点,边连接附近的其他点。
- 细胞中的蛋白质相互作用可以表示为图,其中节点是蛋白质,如果两个蛋白质存在相互作用则它们之间有一条边。
此外,集合(无序列表)可以被视为图,其中每个成员是一个节点且与其他所有成员相连。图像可以被视为具有规则拓扑的图,其中每个像素是一个节点,与相邻像素之间有边相连。
13.1.1 图的类型
图可以按多种方式分类。图 13.2a 中的社交网络包含无向边(undirected edges);每对有连接的个体之间都是双向的朋友关系,因此关系没有方向性。相比之下,图 13.2b 中的引用网络包含有向边(directed edges)。每篇论文引用其他论文,这种关系本质上是单向的。
图 13.2c 描绘了一个知识图谱(knowledge graph),它通过定义对象之间的关系来编码一组事实。从技术上讲,这是一个有向异构多重图(directed heterogeneous multigraph)。它是异构的,因为节点可以表示不同类型的实体(人、地点、公司)。它是多重图,因为任意两个节点之间可以有多种不同类型的边。
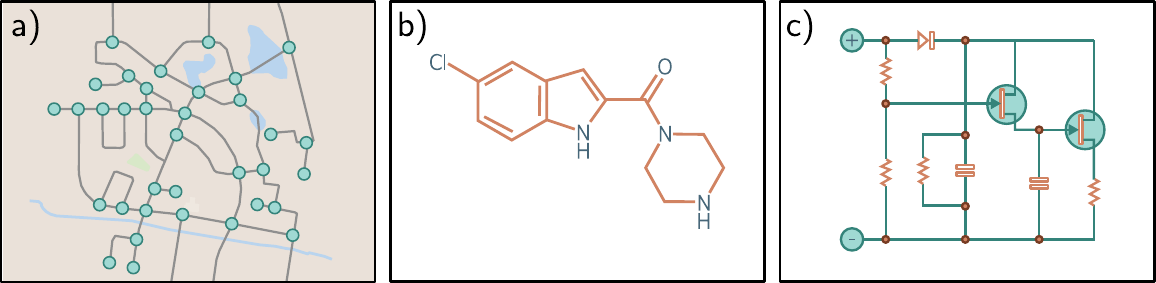
图 13.1 真实世界的图。一些对象,如 a) 道路网络、b) 分子和 c) 电路,天然具有图的结构。
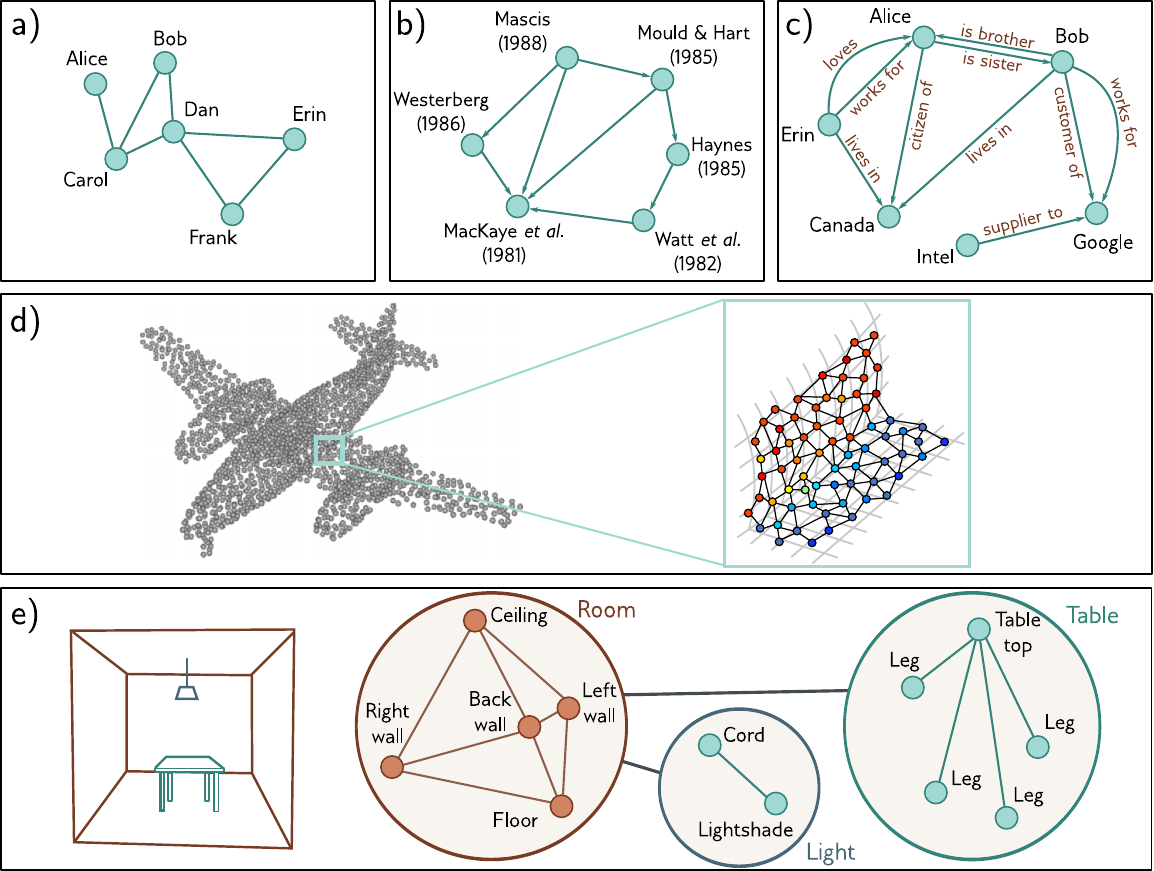
图 13.2 图的类型。a) 社交网络是无向图;人与人之间的连接是对称的。b) 引用网络是有向图;一篇论文引用另一篇,关系是不对称的。c) 知识图谱是有向异构多重图。节点是异构的,因为它们表示不同的对象类型(人、地点、公司),不同节点之间可以有多种不同的关系。d) 点集可以通过在相邻点之间形成边来转化为图。每个节点在三维空间中有一个关联位置,这被称为几何图。e) 左侧的场景可以用层次图来表示。房间、桌子和灯的拓扑结构都用图来表示。这些图构成更大图中的节点,表示对象之间的邻接关系。
图 13.2d 中表示飞机的点集可以通过将每个点与其
所有类型的图都可以使用深度学习来处理。但是,本章聚焦于像图 13.2a 中社交网络那样的无向图。
13.2 图的表示
除了图结构本身之外,信息通常还与每个节点关联。例如,在社交网络中,每个人可以用一个表示其兴趣的固定长度向量来刻画。有时边也附带信息。例如,在道路网络中,每条边可以用其长度、车道数、事故频率和限速来表征。节点处的信息存储在节点嵌入(node embedding)中,边处的信息存储在边嵌入(edge embedding)中。
更形式化地说,图由
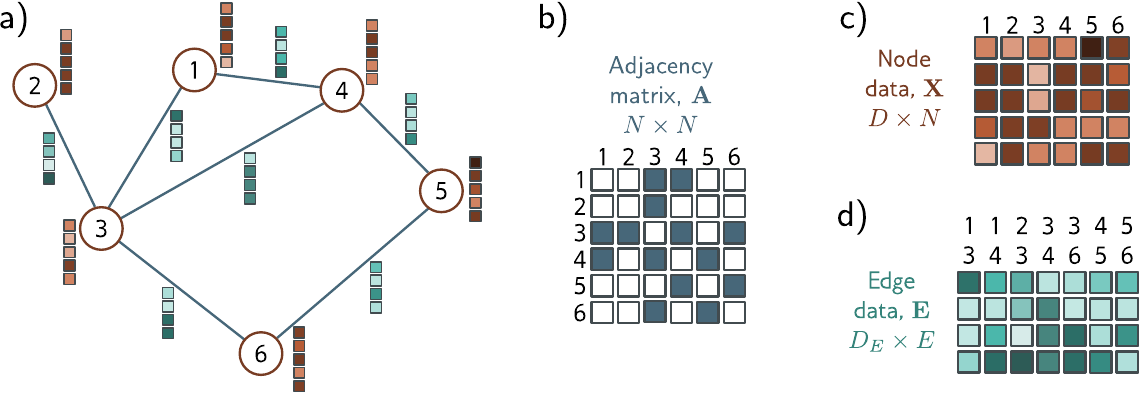
图 13.3 图的表示。a) 具有六个节点和七条边的示例图。每个节点有一个长度为五的关联嵌入(棕色向量)。每条边有一个长度为四的关联嵌入(蓝色向量)。该图可以用三个矩阵表示。b) 邻接矩阵是一个二值矩阵,如果节点
连接到节点 则元素 设为一。c) 节点数据矩阵 包含串联的节点嵌入。d) 边数据矩阵 包含边嵌入。
图结构由邻接矩阵(adjacency matrix)
第
13.2.1 邻接矩阵的性质
邻接矩阵可以用线性代数来寻找节点的邻居。考虑将第
一般地,如果我们将邻接矩阵提升到
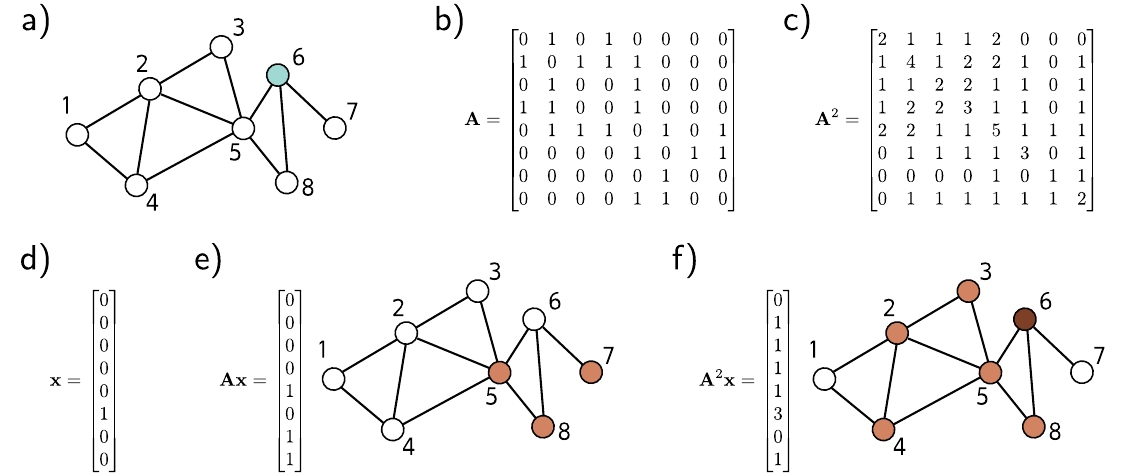
图 13.4 邻接矩阵的性质。a) 示例图。b) 邻接矩阵
的位置 包含从节点 到节点 的长度为一的游走数。c) 平方邻接矩阵 的位置 包含从节点 到节点 的长度为二的游走数。d) 表示节点六的独热向量,在面板 (a) 中高亮显示。e) 当我们用 左乘这个向量时,结果包含从节点六到每个节点的长度为一的游走数;一步可以到达节点五、七和八。f) 当我们用 左乘这个向量时,得到的向量包含从节点六到每个节点的长度为二的游走数;两步可以到达节点二、三、四、五和八,并且可以通过三种不同的方式(经由节点五、七和八)回到原始节点。
13.2.2 节点索引的置换
图中节点的索引是任意的;对节点索引进行置换会导致节点数据矩阵
交换节点索引的操作可以用置换矩阵(permutation matrix)
其中右乘
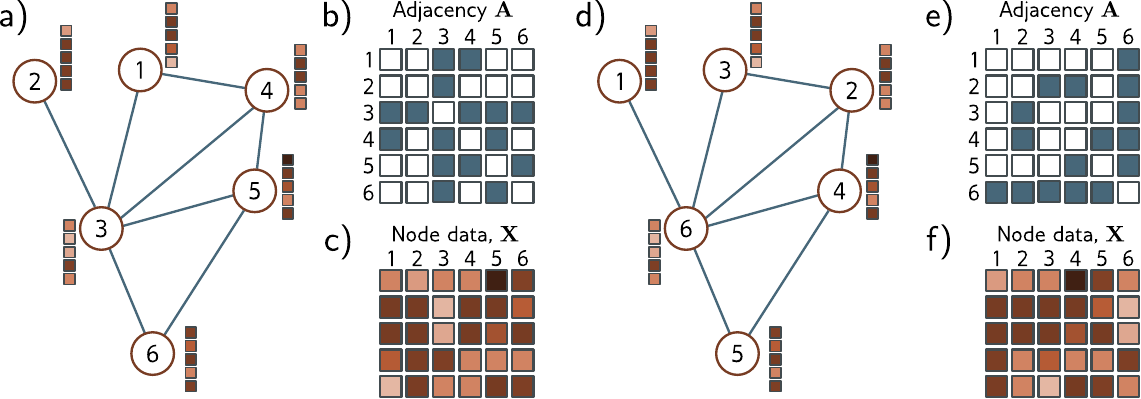
图 13.5 节点索引的置换。a) 示例图、b) 关联的邻接矩阵和 c) 节点嵌入。d) 同一个图但索引的(任意)顺序已改变。e) 邻接矩阵和 f) 节点矩阵现在不同了。因此,任何操作图的网络层都应该对节点的排序不敏感。
13.3 图神经网络、任务和损失函数
图神经网络是一种模型,它以节点嵌入
在网络的起始处,输入节点嵌入
13.3.1 任务和损失函数
我们推迟到第 13.4 节讨论图神经网络模型,首先描述这些网络处理的问题类型及其相关损失函数。监督图问题通常分为三类(图 13.6)。
图级任务: 网络从整个图中分配一个标签或估计一个或多个值,同时利用图结构和节点嵌入。例如,我们可能想预测分子变为液体的温度(回归任务),或判断分子是否对人体有毒(分类任务)。
对于图级任务,输出节点嵌入被组合(例如通过求平均),然后通过线性变换或神经网络将得到的向量映射为固定大小的向量。对于回归任务,使用最小二乘损失计算结果与真实值之间的不匹配。对于二分类任务,输出通过 sigmoid 函数传递,不匹配使用二元交叉熵损失计算。图属于类别一的概率可以表示为:
其中标量
节点级任务: 网络为图的每个节点分配一个标签(分类)或一个或多个值(回归),同时利用图结构和节点嵌入。例如,给定一个从类似图 13.2d 的三维点云构建的图,目标可能是根据节点属于机翼还是机身来分类。损失函数的定义方式与图级任务相同,只是现在在每个节点
边预测任务: 网络预测两个节点之间是否应该存在边。例如,在社交网络场景中,网络可能预测两个人是否认识并喜欢对方,并建议他们建立连接。这是一个二分类任务,需要将两个节点嵌入映射为一个表示边存在概率的单一数值。一种方法是取节点嵌入的点积并通过 sigmoid 函数生成概率:
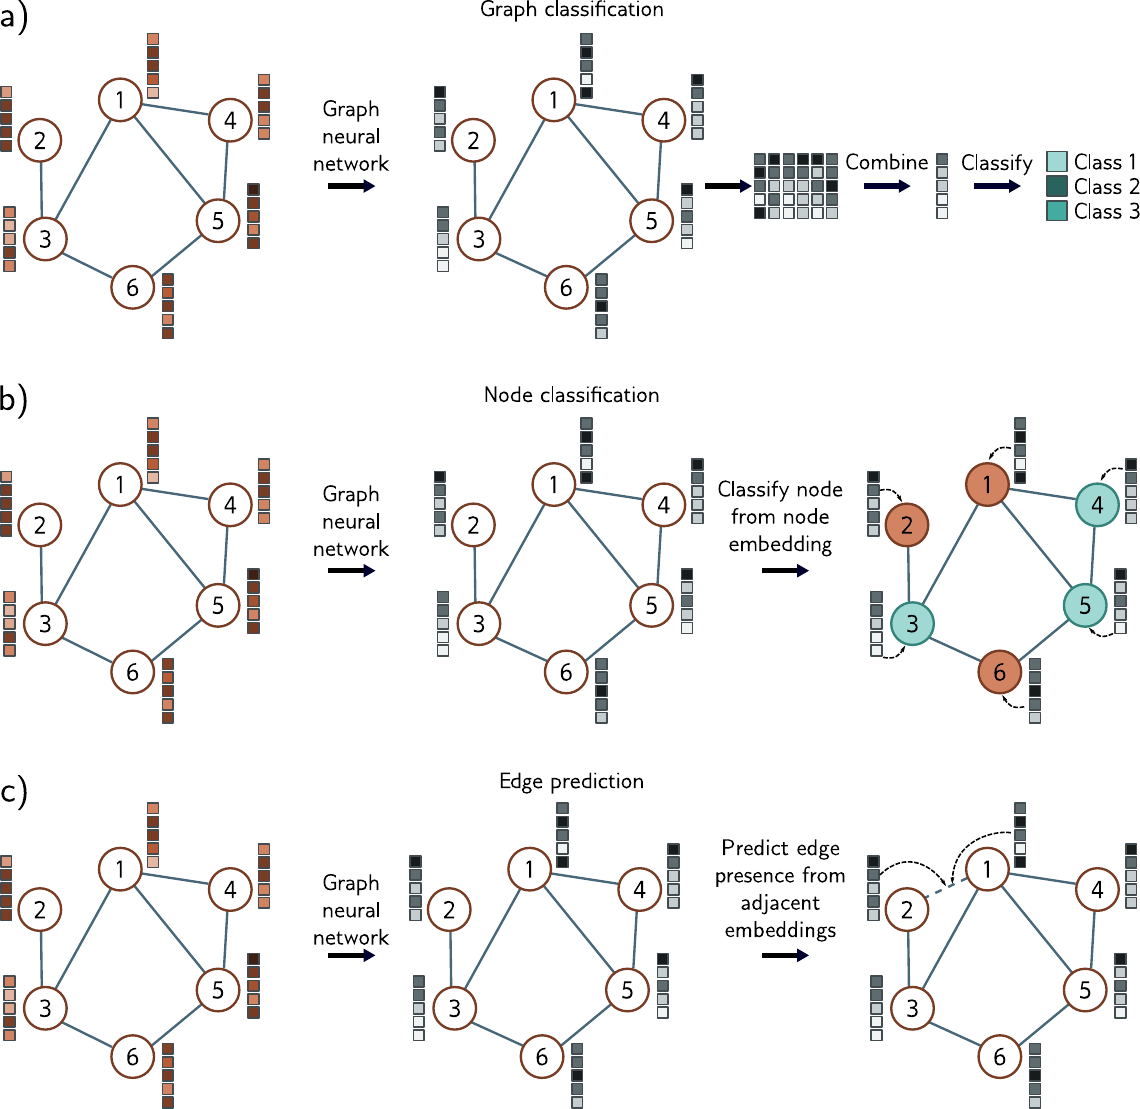
图 13.6 图的常见任务。每种情况下,输入是由邻接矩阵和节点嵌入表示的图。图神经网络通过一系列层处理节点嵌入。最后一层的节点嵌入包含关于节点及其在图中上下文的信息。a) 图分类。节点嵌入被组合(例如通过求平均),然后映射到固定大小的向量,通过 softmax 函数产生类别概率。b) 节点分类。每个节点嵌入被单独用作分类的基础(青色和橙色表示分配的节点类别)。c) 边预测。边相邻的节点嵌入被组合(例如取点积)计算一个单一数值,通过 sigmoid 函数产生缺失边应该存在的概率。
13.4 图卷积网络
图神经网络有许多类型,但这里我们聚焦于基于空间的卷积图神经网络(spatial-based convolutional graph neural networks),简称 GCN。这些模型是卷积性的,因为它们通过从邻近节点聚合信息来更新每个节点。因此,它们引入了关系归纳偏置(relational inductive bias)(即优先考虑来自邻居的信息的偏置)。它们是基于空间的,因为使用原始图结构。这与在傅里叶域中应用卷积的基于谱的方法(spectral-based methods)形成对比。
GCN 的每一层是一个函数
其中
13.4.1 等变性与不变性
我们之前指出,图中节点的索引是任意的,任何节点索引的置换都不会改变图。因此,任何模型都必须遵守这一性质。由此可知,每一层必须对节点索引的置换是等变的(equivariant)(见第 10.1 节)。换句话说,如果我们置换节点索引,每个阶段的节点嵌入也会以同样的方式被置换。用数学术语来说,如果
对于节点分类和边预测任务,输出也应该对节点索引的置换是等变的。然而,对于图级任务,最终层从整个图聚合信息,因此输出对节点顺序是不变的(invariant)。实际上,公式 13.2 中的输出层实现了这一点,因为:
对任何置换矩阵
这与图像的情况类似,分割应该对几何变换等变,而图像分类应该是不变的(图 10.1)。对于图像,卷积层和池化层部分实现了对平移的等变和不变,但没有已知的方法能精确保证对更一般变换的这些性质。然而,对于图,可以定义确保对置换等变或不变的网络。
13.4.2 参数共享
第 10 章论证了将全连接网络应用于图像是不合理的,因为这要求网络学习在每个图像位置独立识别物体。相反,我们使用卷积层以相同方式处理图像中的每个位置。这减少了参数数量并引入了归纳偏置,迫使模型以相同方式对待图像的每个部分。
同样的论证也适用于图中的节点。我们可以学习一个为每个节点关联不同参数的模型。但是,这样网络必须独立学习图中每个位置的连接含义,且训练需要许多具有相同拓扑的图。相反,我们构建一个在每个节点使用相同参数的模型,减少参数数量并在整个图中共享网络在每个节点学到的内容。
回忆卷积(公式 10.3)通过从邻居取加权信息之和来更新变量。一种理解方式是每个邻居向感兴趣的变量发送消息,然后聚合这些消息形成更新。在图像中,邻居是当前位置周围固定大小方形区域中的像素,因此每个位置的空间关系相同。然而,在图中,每个节点可能有不同数量的邻居,且没有一致的关系;没有理由对"上方"节点的信息与"下方"节点的信息区别对待。
13.4.3 GCN 层示例
这些考虑引出了一个简单的 GCN 层(图 13.7)。在第
其中
我们可以更简洁地写出这个公式。注意到矩阵右乘向量返回其列的加权和。邻接矩阵
其中
这一层满足设计要求:它对节点索引的置换是等变的,可以处理任意数量的邻居,利用图结构提供关系归纳偏置,并在整个图中共享参数。
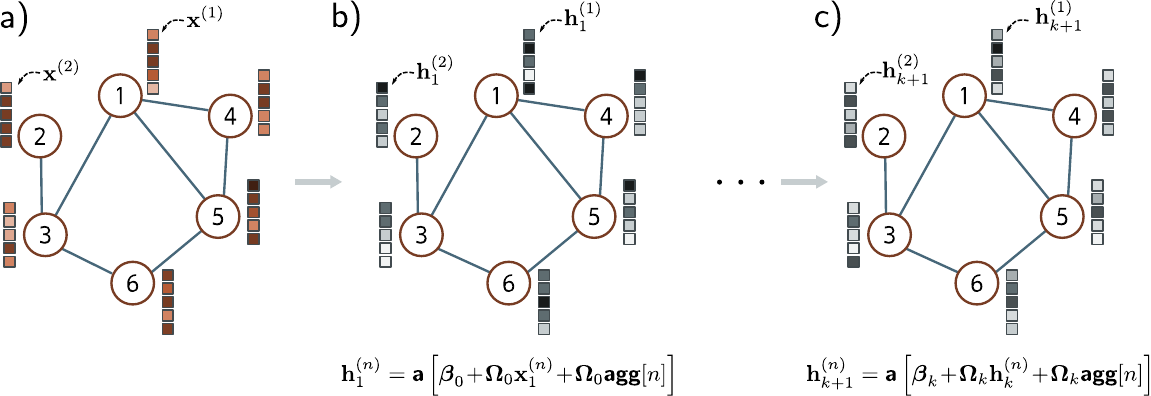
图 13.7 简单的图卷积网络层。a) 输入图由图结构(体现在邻接矩阵
中,未显示)和节点嵌入(存储在 的列中)组成。b) 第一隐藏层中的每个节点通过以下方式更新:(i) 聚合相邻节点形成单一向量,(ii) 对聚合向量应用线性变换 ,(iii) 对原始节点应用相同的线性变换 ,(iv) 将这些与偏置 相加,最后 (v) 应用非线性激活函数 (如 ReLU)。c) 这个过程在后续层中重复(但每层有不同的参数),直到在网络末端产生最终嵌入。
13.5 示例:图分类
我们现在综合这些思想来描述一个将分子分类为有毒或无害的网络。网络输入是邻接矩阵和节点嵌入矩阵
网络方程为:
其中网络输出
13.5.1 批量训练
给定
然而,每个图可能有不同数量的节点。因此矩阵
幸运的是,一个简单的技巧允许我们并行处理整个批量。批量中的图被视为单个大图的不相连组成部分。网络可以作为网络方程的单个实例运行。均值池化仅在各个单独的图上进行,以生成可以输入损失函数的每个图的单一表示。
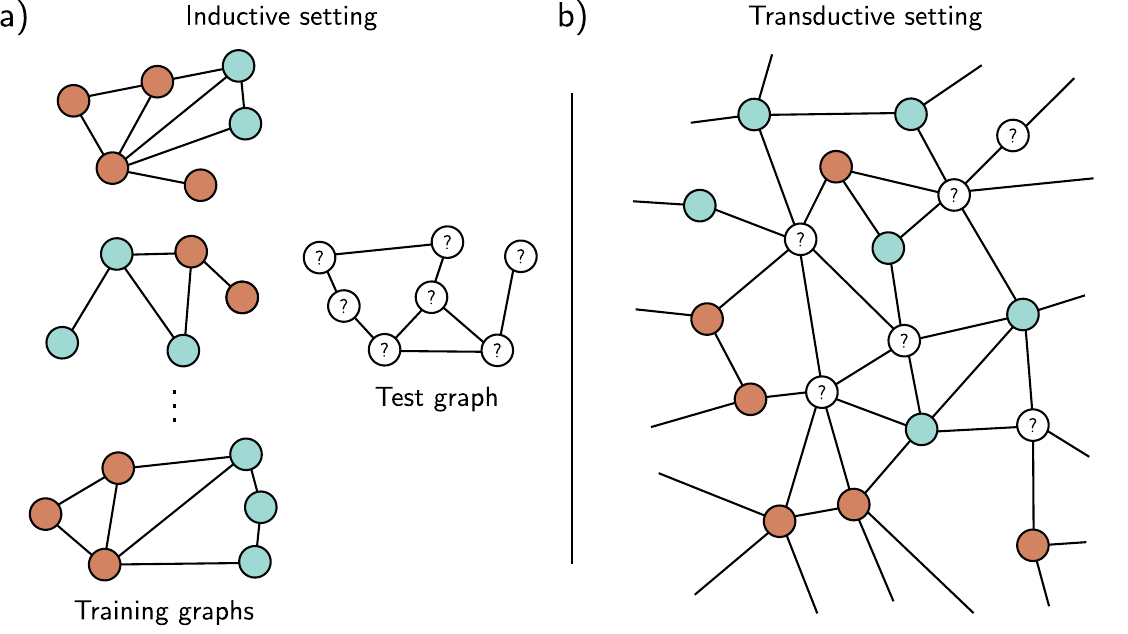
图 13.8 归纳问题 vs. 直推问题。a) 归纳设置中的节点分类任务。我们给定一组
个训练图,其中节点标签已知(橙色和青色表示)。训练后,给定一个测试图,我们必须为每个节点分配标签。b) 直推设置中的节点分类。有一个大图,其中一些节点有标签(橙色和青色),其他未知。我们训练模型正确预测已知标签,然后检查未知节点处的预测。
13.6 归纳模型 vs. 直推模型
到目前为止,本书中的所有模型都是归纳的(inductive):我们利用标注数据的训练集来学习输入与输出之间的关系,然后将其应用于新的测试数据。一种理解方式是我们在学习将输入映射到输出的规则,然后在其他地方应用它。
相比之下,直推(transductive)模型同时考虑标注和未标注数据。它不产生规则,而仅为未知输出生成标签。这有时被称为半监督学习(semi-supervised learning)。它的优势是可以利用未标注数据中的模式来辅助决策。然而,它的劣势是当增加新的未标注数据时,模型需要重新训练。
图常常遇到这两种问题类型(图 13.8)。有时我们有许多标注图,学习图与标签之间的映射。例如,我们可能有许多分子,每个分子标注是否对人体有毒。我们学习将图映射到有毒/无毒标签的规则,然后将此规则应用于新分子。然而,有时只有一个单一的巨大图。在科学论文引用图中,我们可能有指示领域(物理、生物等)的标签用于某些节点,并希望标注剩余节点。这里训练数据和测试数据是不可分割地连接在一起的。
图级任务只出现在有训练图和测试图的归纳设置中。然而,节点级任务和边预测任务可以出现在两种设置中。在直推情况下,损失函数最小化已知真实标签处的模型输出与真实值之间的不匹配。新预测通过运行前向传播并检索真实值未知处的结果来计算。
13.7 示例:节点分类
作为第二个示例,考虑直推设置中的二分类节点分类任务。我们从一个拥有数百万节点的商业规模图开始。一些节点有真实二分类标签,目标是标注剩余的未标注节点。网络主体与前面的示例相同(公式 13.11),但最终层不同,它产生大小为
其中函数
训练这个网络提出了两个问题。首先,训练如此规模的图神经网络在后勤上是困难的。考虑到我们必须在前向传播中的每个网络层存储节点嵌入。这将涉及存储和处理整个图大小数倍的结构,可能不现实。其次,我们只有一个图,所以不清楚如何执行随机梯度下降。当只有一个对象时如何构成批量?
13.7.1 选择批量
构成批量的一种方式是在每个训练步骤中选择标注节点的随机子集。每个节点依赖于前一层中的邻居。这些邻居又依赖于它们前一层的邻居,因此(类似于卷积网络)每个节点有一个感受野(receptive field)(图 13.9)。感受野区域被称为
不幸的是,如果层数很多且图连接密集,每个输入节点可能都在每个输出的感受野中,这可能根本不会减小图的大小。这被称为图扩展问题(graph expansion problem)。解决这个问题的两种方法是邻域采样(neighborhood sampling)和图划分(graph partitioning)。
邻域采样: 对馈入批量节点的完整图进行采样,从而减少每个网络层的连接数(图 13.10)。例如,我们可以从批量节点开始,在前一层中随机采样固定数量的邻居。然后,在更前一层中随机采样固定数量的它们的邻居,以此类推。图的大小仍然随每一层增长,但以更可控的方式。这对每个批量重新进行,因此即使同一批量被抽到两次,参与的邻居也不同。这让人联想到 dropout(第 9.3.3 节),并增加了一些正则化效果。
图划分: 第二种方法是在处理之前将原始图聚类为不相连的节点子集(即彼此不相连的更小图)(图 13.11)。有标准算法可以选择这些子集以最大化内部链接数。这些更小的图可以各自被视为批量。或者,可以将随机子集组合形成批量(恢复它们之间的边)。
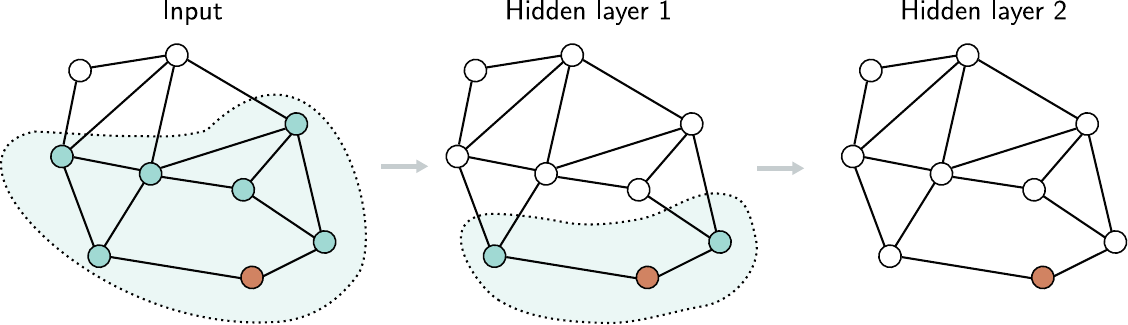
图 13.9 图神经网络中的感受野。考虑隐藏层二中的橙色节点(右侧)。它从隐藏层一中 1 跳邻域内的节点接收输入(中间的阴影区域)。隐藏层一中的这些节点又从它们的邻居接收输入,因此隐藏层二中的橙色节点从 2 跳邻域中的所有输入节点接收输入(左侧的阴影区域)。图中贡献给给定节点的区域等价于卷积神经网络中感受野的概念。
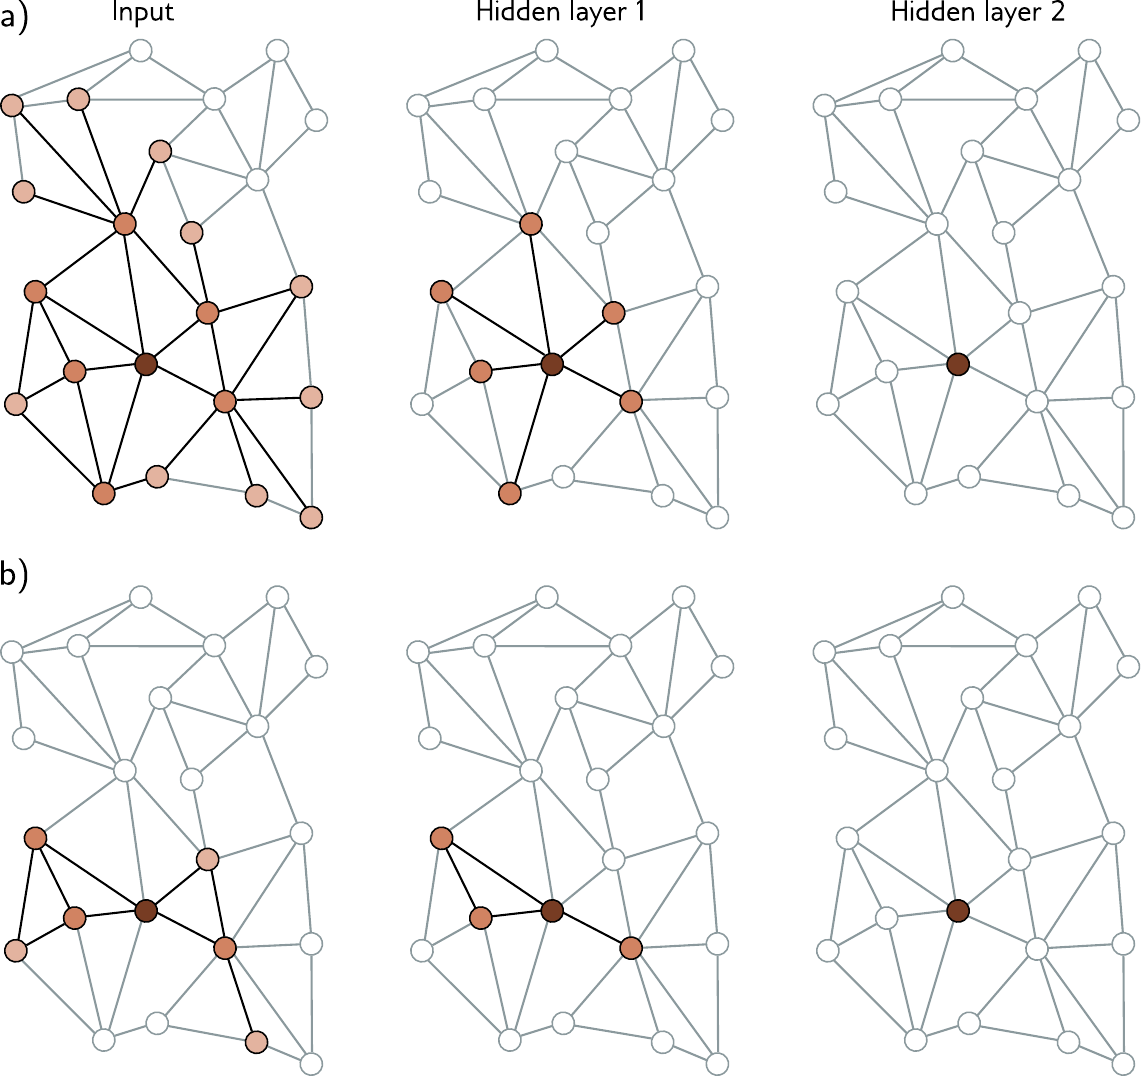
图 13.10 邻域采样。a) 在大型图上构成批量的一种方式是在输出层选择标注节点的子集(这里只有隐藏层二中的一个节点,右侧),然后回溯找到
跳邻域(感受野)中的所有节点。只需要这个子图来训练此批量。不幸的是,如果图连接密集,这可能保留了图的大部分。b) 一种解决方案是邻域采样。当我们从最终层回溯时,在前一层选择邻居的子集(这里为三个),以及它们在更前一层的邻居子集。这限制了训练批量的图的大小。所有面板中,亮度表示到原始节点的距离。
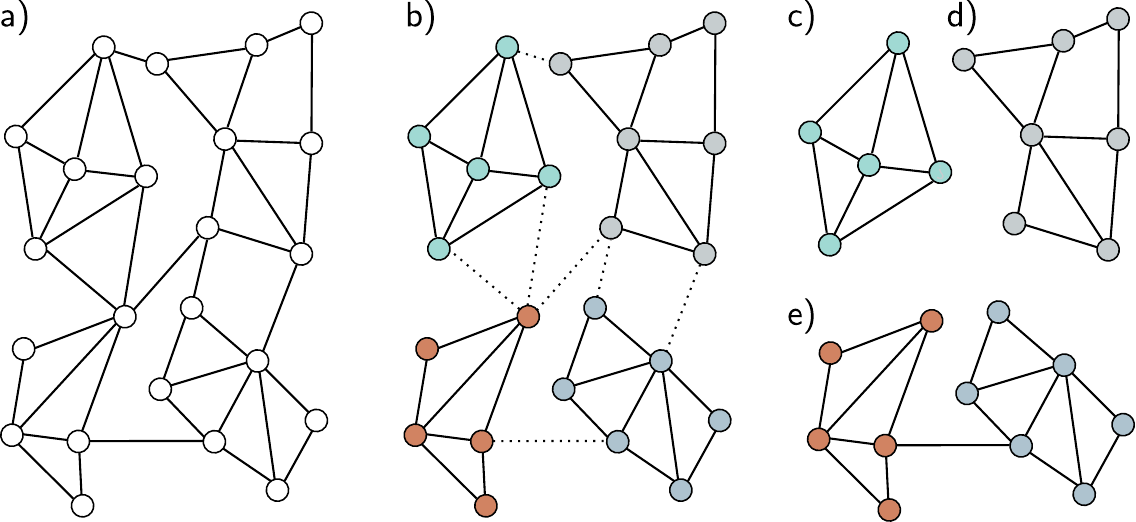
图 13.11 图划分。a) 输入图。b) 输入图使用有原则的方法划分为更小的子图,移除最少的边。c-d) 我们现在可以在直推设置中使用这些子图作为批量来训练,因此这里有四个可能的批量。e) 或者,我们可以使用子图的组合作为批量,恢复它们之间的边。如果使用成对的子图,这里将有六个可能的批量。
给定上述方法之一来构成批量,我们现在可以像归纳设置一样训练网络参数,将标注节点划分为训练集、测试集和验证集;我们实际上已经将直推问题转换为了归纳问题。为了执行推断,我们基于未知节点的
13.8 图卷积网络的层
在前面的示例中,我们通过将来自相邻节点的消息与变换后的当前节点相加来合并它们。这是通过将节点嵌入矩阵
13.8.1 当前节点与聚合邻居的组合
在上面的 GCN 层示例中,我们通过简单地将聚合邻居
在另一种变体中,当前节点在贡献到求和之前乘以因子
这被称为对角增强(diagonal enhancement)。一个相关变体是对当前节点应用不同的线性变换
其中我们在第三行定义了
13.8.2 残差连接
在残差连接中,来自邻居的聚合表示先经过变换并通过激活函数,然后再与当前节点相加或拼接。对于后一种情况,相关的网络方程为:
13.8.3 均值聚合
上述方法通过对节点嵌入求和来聚合邻居。然而,可以用不同的方式组合嵌入。有时取邻居的平均值而不是求和更好;如果嵌入信息比结构信息更重要,且邻域贡献的幅度不应取决于邻居的数量,这可能更优:
其中
13.8.4 Kipf 归一化
基于均值聚合的图神经网络有许多变体。有时当前节点与其邻居一起包含在均值计算中,而不是单独处理。在 Kipf 归一化中,节点表示的和被归一化为:
其逻辑是,来自拥有大量邻居的节点的信息应该被降权,因为连接多意味着提供的独特信息较少。这也可以用度矩阵以矩阵形式表示:
13.8.5 最大池化聚合
另一种同样对置换不变的操作是计算一组对象的最大值。最大池化聚合操作为:
其中运算符
13.8.6 注意力聚合
目前讨论的聚合方法要么对邻居的贡献等权对待,要么以依赖于图拓扑的方式加权。相反,在图注意力层(graph attention layers)中,权重依赖于节点处的数据。对当前节点嵌入应用线性变换:
然后通过拼接每个变换后的节点嵌入
这些变量存储在
其中
这与 Transformer 中的点积自注意力计算非常相似(见图 13.12),不同之处在于:(i) 键、查询和值都相同,(ii) 相似度的度量不同,(iii) 注意力被掩码使得每个节点只关注自身及其邻居。与 Transformer 一样,这个系统可以扩展为使用多个头并行运行并重新组合。
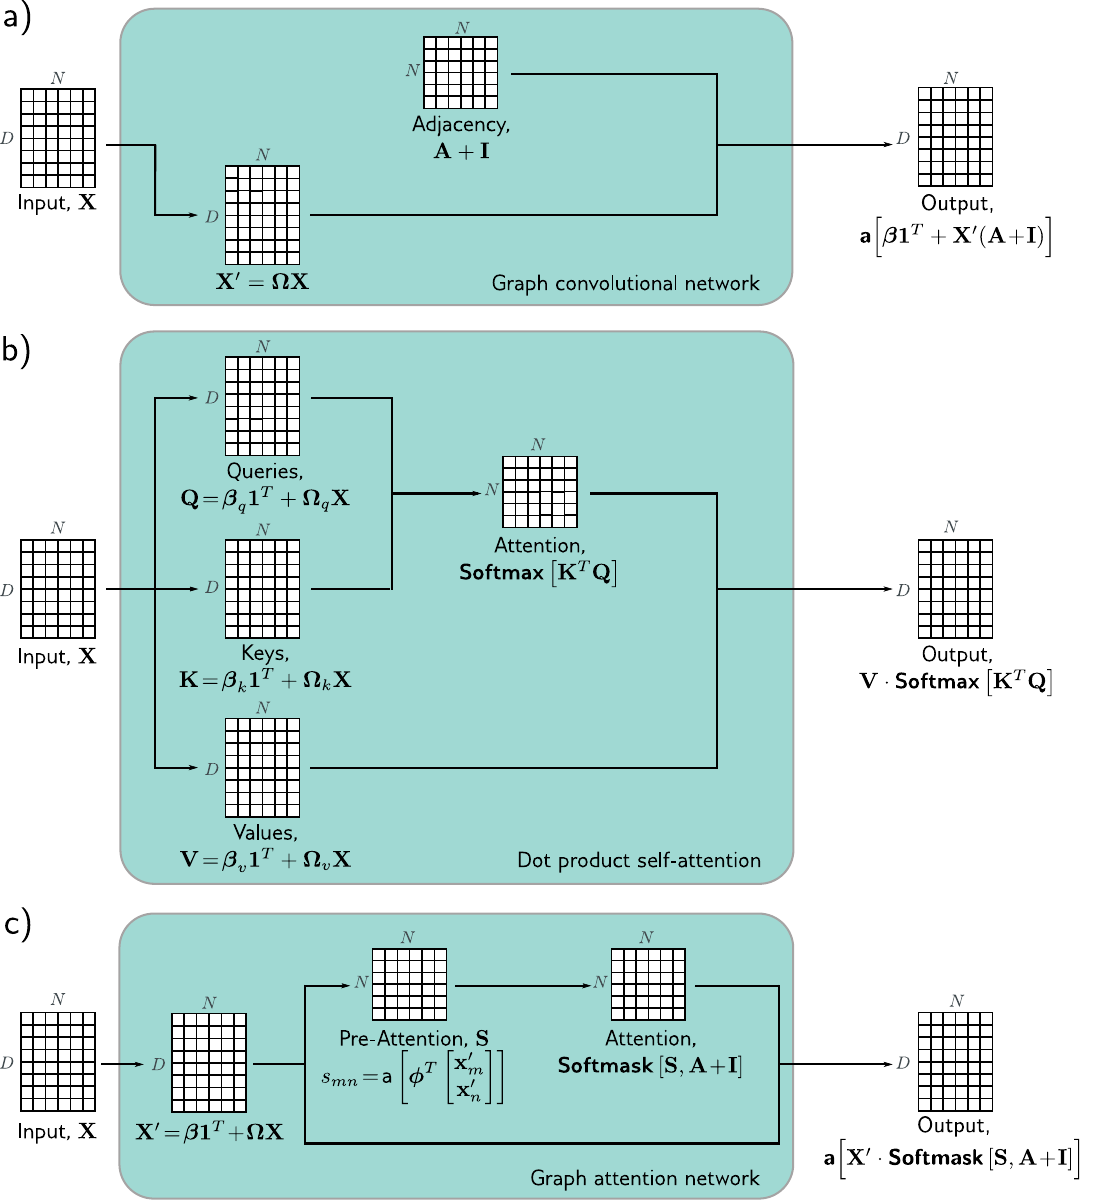
图 13.12 图卷积网络、点积注意力和图注意力网络的比较。每种情况下,机制将存储在
矩阵 中的 个大小为 的嵌入映射到相同大小的输出。a) 图卷积网络对数据矩阵应用线性变换 。然后计算变换数据的加权和,其中加权基于邻接矩阵。加上偏置 ,结果通过激活函数。b) Transformer 中点积自注意力机制的输出也是变换后输入的加权和,但这次权重通过注意力矩阵依赖于数据本身。c) 图注意力网络结合了这两种机制;权重既从数据计算又基于邻接矩阵。
13.9 边图
到目前为止,我们一直聚焦于处理节点嵌入。这些嵌入在通过网络传递时不断演化,使得到网络末端时,它们既包含节点本身的信息,也包含其在图中上下文的信息。我们现在考虑信息与图的边相关联的情况。
利用节点嵌入的机制来处理边嵌入很容易,只需使用边图(edge graph)(也称为伴随图(adjoint graph)或线图(line graph))。这是一个互补图,原始图中的每条边变成一个节点,原始图中共享公共节点的每两条边在新图中创建一条边(图 13.13)。一般来说,可以从边图恢复原始图,因此可以在这两种表示之间切换。
为了处理边嵌入,将图转换为其边图。然后使用完全相同的技术——在每个新节点处聚合来自邻居的信息,并将其与当前表示组合。当节点嵌入和边嵌入同时存在时,我们可以在两种图之间来回转换。现在有四种可能的更新(节点更新节点、节点更新边、边更新节点、边更新边),这些可以按需交替进行,或者稍作修改后,节点可以同时从节点和边更新。
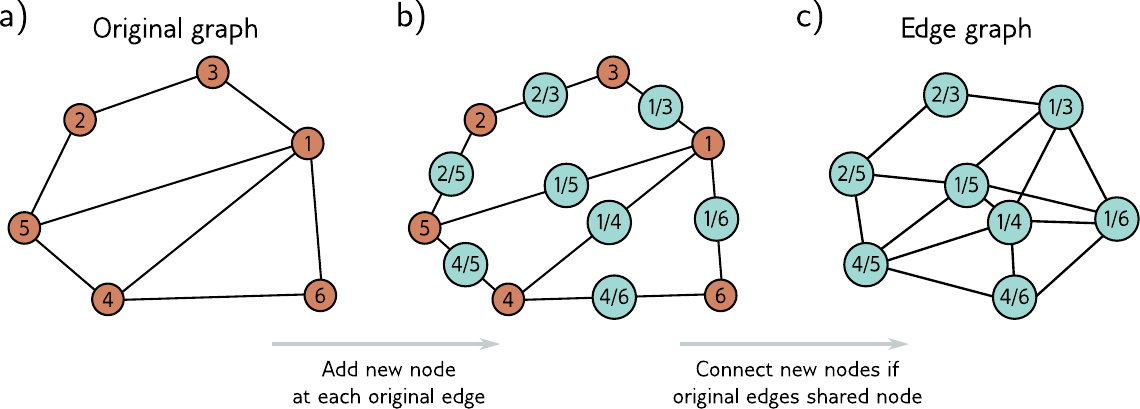
图 13.13 边图。a) 具有六个节点的图。b) 为了创建边图,我们为原始图中的每条边分配一个新节点(青色圆圈),c) 如果这些边在原始图中共享同一个节点,则将新节点连接起来。
13.10 总结
图由一组节点组成,其中节点对通过边相连。节点和边都可以附带数据,分别称为节点嵌入和边嵌入。许多现实世界的问题可以用图来描述,目标是确定整个图的属性、每个节点或边的属性,或图中额外边的存在。
图神经网络是应用于图的深度学习模型。由于图中的节点顺序是任意的,图神经网络的每一层必须对节点索引的置换是等变的。基于空间的卷积网络是图神经网络的一个家族,它们从节点的邻居聚合信息,然后用这些信息更新节点嵌入。
处理图的一个挑战是它们经常出现在直推设置中,即只有一个部分标注的图而不是训练图和测试图的集合。这个图可能非常大,在训练方面带来进一步挑战,由此产生了采样和划分算法。边图为原始图中的每条边创建一个节点。通过转换到这种表示,图神经网络可以用来更新边嵌入。